
用R实现范式编程
面向函数范式编程(Functional programming)
模拟简单的随机过程
模拟一个简单的随机过程:从N~(0,1)标准正态分布中产生100个随机值,反复5次得到一个list,再以每个list的初始值作为起点后一个的值作为过程步的增量走到下一步,直到走到尽头。
先来看一下accumulate函数的作用
# Understanding the arguments .x and .y when .f

# is a lambda function

# .x is the accumulating value

2:6 %>% accumulate(~ .x) # 产生以3为起点方差为3的序列

## [1] 2 2 2 2 2
# .y is element in the list

2:6 %>% accumulate(~ .y)

## [1] 2 3 4 5 6
#

2:6 %>% accumulate(~ .x + .y) # 产生以2为起点2:6为累加值的序列

## [1]  2  5  9 14 20
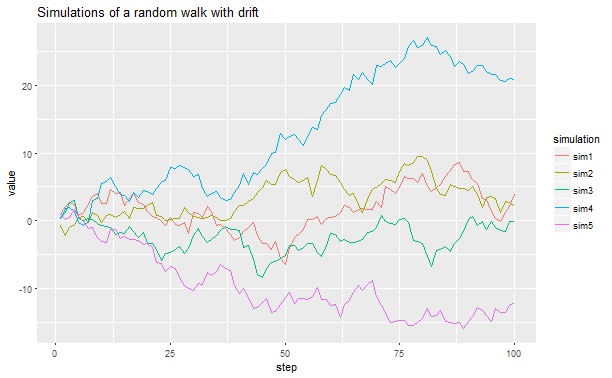
利用accumulate尝试实现一个带有漂移的随机过程
# Simulating stochastic processes with drift

## Not run:

plotSim <- function(draft){

  rerun(5, rnorm(100)) %>% # This is a convenient way of generating sample data. It works similarly to replicate(..., simplify = FALSE).

  set_names(paste0("sim", 1:5)) %>%

  map(~ accumulate(., ~ draft + .x + .y)) %>%

  map_df(~ data_frame(value = .x, step = 1:100), .id = "simulation") %>%

  ggplot(aes(x = step, y = value)) +

    geom_line(aes(color = simulation)) +

    ggtitle("Simulations of a random walk with drift")

}

plotSim(0.001)
多数据建模
检验车辆数据集中变量单位加仑的英里数与重量之间的线性关系是否会在不同的引擎汽缸中有显出差异?
# If each element of the output is a data frame, use

# map_df to row-bind them together:

mtcars %>%

  split(.$cyl) %>%

  map(~ lm(mpg ~ wt, data = .x)) %>%

  map_df(~ as.data.frame(t(as.matrix(coef(.)))))

##   (Intercept)        wt

## 1    39.57120 -5.647025

## 2    28.40884 -2.780106

## 3    23.86803 -2.192438
对数据集中不同的数据分别进行建模,再预测:
# Split into pieces, fit model to each piece, then predict

by_cyl <- mtcars %>% split(.$cyl)

mod <- by_cyl %>% map(~ glm(mpg ~ wt, data = .))

a <- map2(mod, by_cyl, predict) %>%

  flatten_df() %>%

  t() %>%

  as.data.frame() %>%

  mutate(a=rownames(.))

mtcars %>%

  mutate(a=rownames(.)) %>%

  left_join(a) %>%

  select(a, mpg, V1) %>%

  mutate(e = abs(mpg-V1)) %>%

  ggplot(aes(a, e))+

  geom_point()+

  coord_flip()

## Joining, by = "a"

多模型预测
对单一数据集进行多个模型训练预测:
result <- mtcars %>%

  tbl_df() %>%

  nest() %>%

  mutate(mod1 = map(data, ~ glm(mpg ~ wt, data = .)),

        mod2 = map(data, ~ lm(mpg ~ wt, data = .)),

        pred1 = map2(mod1, data, predict),

        pred2 = map2(mod2, data, predict)

  )

result

## # A tibble: 1 x 5

##                 data      mod1     mod2      pred1      pred2

##               <list>    <list>   <list>     <list>     <list>

## 1 <tibble [32 x 11]> <S3: glm> <S3: lm> <dbl [32]> <dbl [32]>
产生四个数据集,分别按照一定格式的文件命名方式保存下来
# create dfs to loop over

df <- data.frame(

  a = rnorm(10),

  b = rnorm(10),

  c = rnorm(10),

  d = rnorm(10)

)

obj <- list(df1 = df, df2 = df, df3 = df, df4 = df )

# create file names to loop over

path <- getwd()

folder <- "RDa"

names <- c("df1", "df2", "df3", "df4")

if(!file.exists(folder)){

  dir.create(folder)

  fnames <- lapply(names, function(x) paste0((file.path(path, folder)), '/', x, ".RDa"))

}

fnames <- lapply(names, function(x) paste0((file.path(path, folder)), '/', x, ".RDa"))

walk2(obj, fnames, ~ save(.x, file = .y))

dir('RDa')

## [1] "df1.RDa" "df2.RDa" "df3.RDa" "df4.RDa"
用R实现范式编程的更多相关文章
- SparkR(R on Spark)编程指南 含 dataframe操作 2.0
SparkR(R on Spark)编程指南 Spark 2015-06-09 28155 1评论 下载为PDF 为什么不允许复制 关注iteblog_hadoop公众号,并在这里评论区留言 ...
- SparkR(R on Spark)编程指南 含 dataframe操作
SparkR(R on Spark)编程指南 Spark 2015-06-09 28155 1评论 下载为PDF 为什么不允许复制 关注iteblog_hadoop公众号,并在这里评论区留言 ...
- C# 由范式编程==运算符引发对string内存分配的思考
今天在看C#编程指南时(类型参数的约束http://msdn.microsoft.com/zh-cn/library/d5x73970.aspx)看到一段描述: 在应用 where T : class ...
- 面向函数范式编程(Functional programming)
函数编程(简称FP)不只代指Haskell Scala等之类的语言,还表示一种编程思维,软件思考方式,也称面向函数编程. 编程的本质是组合,组合的本质是范畴Category,而范畴是函数的组合. 首先 ...
- R语言面向对象编程:S3和R6
一.基于S3的面向对象编程 基于S3的面向对象编程是一种基于泛型函数(generic function)的实现方式. 1.S3函数的创建 S3对象组成:generic(generic FUN)+met ...
- R语言高性能编程,优化(一)
这段时间学习了<R高性能编程>这本书,基于这段时间做的项目实践,总结了一些自己的体会,和大家分享 一.为什么R程序有时候会很慢?1.计算性能的三个限制条件 cpu ram io R代码本身 ...
- R语言高性能编程(三)
一.使用并行计算加倍提升性能1.数据并行 VS 任务并行实现数据并行的算法scoket 并行性注意并行计算时间并不与执行任务的计算资源数目成正比(计算机核心),amdahl定律:并行代码的速度受限于串 ...
- R语言高性能编程(二)
接着上一篇 一.减少内存使用的简单方法1.重用对象而不多占用内存 y <- x 是指新变量y指向包含X的那个内存块,只有当y被修改时才会复制到新的内存块,一般来说只要向量没有被其他对象引用,就可 ...
- GPU并行编程小结
http://peghoty.blog.163.com/blog/static/493464092013016113254852/ http://blog.csdn.net/augusdi/artic ...
随机推荐
- js关于时间(date)的比较
之前在工作上遇到一个问题:使用一些时间插件,如果有俩个时间,要判断结束时间和开始时间的大小?后来就查找了一些资料,这边整理出俩个比较简便的方法. 在这我拿 laydate.js 这个插件来举例: 首先 ...
- 基于 H5 和 webGL 的 3d 智慧城市
前言 中共中央.国务院在今年12月印发了<长江三角洲区域一体化发展规划纲要>(下文简称<纲要>),并发出通知,要求各地区各部门结合实际认真贯彻落实. <纲要>强调, ...
- HYSBZ_1588_set
http://www.lydsy.com/JudgeOnline/problem.php?id=1588 直接set做就好了,注意set的迭代器只能--之类的操作. OJ崩了,也不知道对错. #inc ...
- avtivity与view
view和activity的区别 activity相当于控制部分,view相当于显示部分.两者之间是多对多的关系,所有东西必须用view来显示. viewGroup继承自view,实现了ViewMa ...
- Grafana & Graphite & Collectd:监控系统
简介 监控是运维工作中的一个重要组成部分,今天介绍一套新的监控工具,方便好用,扩展性强,这套工具有三个组件,Grafana & Graphite & Collectd: Grafana ...
- 数据结构与算法的实现(c++)之第一天
开发工具:codeblocks 17.12版本 学习视频来自b站 第一天:学习swap交换.冒泡排序 swap交换:swap是几乎所有的排序的最基础部分,代码如下: #include <iost ...
- 曹工说Spring Boot源码(18)-- Spring AOP源码分析三部曲,终于快讲完了 (aop:config完整解析【下】)
写在前面的话 相关背景及资源: 曹工说Spring Boot源码(1)-- Bean Definition到底是什么,附spring思维导图分享 曹工说Spring Boot源码(2)-- Bean ...
- 【TensorFlow】TensorFlow基础 —— 模型的保存读取与可视化方法总结
TensorFlow提供了一个用于保存模型的工具以及一个可视化方案 这里使用的TensorFlow为1.3.0版本 一.保存模型数据 模型数据以文件的形式保存到本地: 使用神经网络模型进行大数据量和复 ...
- PyTorch可视化——tensorboard、visdom
一.pytorch与tensorboard结合使用 Tensorboard Tensorboard一般都是作为tf的可视化工具,与tf深度集成,它能够展现tf的网络计算图,绘制图像生成的定量指标图以及 ...
- ELK-图示nginx中ip的地理位置
一.环境准备: ELK stack 环境一套 geolite数据库文件 二.下载geolite数据库(logstash机器上解压,logstash需调用): geolite官网:https://dev ...