
node 爬虫 --- 批量下载图片
步骤一:创建项目
npm init
步骤二:安装 request,cheerio,async 三个模块
request
用于请求地址和快速下载图片流。
https://github.com/request/request
cheerio
为服务器特别定制的,快速、灵活、实施的jQuery核心实现.
便于解析html代码。
https://www.npmjs.com/package/cheerio
async
异步调用,防止堵塞。
http://caolan.github.io/async/
npm i request cheerio async -D
步骤三:核心思路
(1)用request 发送一个请求。获取html代码,取得其中的img标签和a标签。
//发送请求

function requestall(url) {

  request({

    uri: url,

    headers: setting.header

  }, function (error, response, body) {

    if (error) {

      // 请求失败

      console.log(error);

    } else {

      console.log(response.statusCode);

      if (!error && response.statusCode == 200) {

        // 请求成功

      }

    }

  });

}
(2)通过获取的a表情进行递归调用。不断获取img地址和a地址,继续递归
// 递归爬虫

$('a').each(function () {

  var murl = $(this).attr('href');

  if (IsURL(murl)) {

    setTimeout(function () {

      fetchre(murl);

    }, timeout);

    timeout += setting.ajax_timeout;

  } else {

    setTimeout(function () {

      fetchre("http://www.ivsky.com/" + murl);

    }, timeout);

    timeout += setting.ajax_timeout;

  }

})
(3)获取img地址通过request(photo).pipe(fs.createWriteStream(dir + “/” + filename));进行快速下载。
//发送请求

function requestall(url) {

  request({

    uri: url,

    headers: setting.header

  }, function (error, response, body) {

    if (error) {

      console.log(error);

    } else {

      console.log(response.statusCode);

      if (!error && response.statusCode == 200) {

        var $ = cheerio.load(body);

        var photos = [];

        $('img').each(function () {

          // 判断地址是否存在

          if ($(this).attr('src')) {

            var src = $(this).attr('src');

            var end = src.substr(-4, 4).toLowerCase();

            if (end == '.jpg' || end == '.gif' || end == '.png' || end == '.jpeg') {

              if (IsURL(src)) {

                photos.push(src);

              }

            }

          }

        });

        downloadImg(photos, dir, setting.download_v);

        // 递归爬虫

        $('a').each(function () {

          var murl = $(this).attr('href');

          if (IsURL(murl)) {

            setTimeout(function () {

              fetchre(murl);

            }, timeout);

            timeout += setting.ajax_timeout;

          } else {

            setTimeout(function () {

              fetchre("http://www.ivsky.com/" + murl);

            }, timeout);

            timeout += setting.ajax_timeout;

          }

        })

      }

    }

  });

}
步骤四:防坑
(1)在request通过图片地址下载时,绑定error事件防止爬虫异常的中断。
// 防止pipe错误

request(photo)

  .on('error', function (err) {

    console.log(err);

  })

  .pipe(fs.createWriteStream(dir + "/" + filename));
(2)通过async的mapLimit限制并发。
async.mapLimit(photos, asyncNum, function (photo, callback) {

  // 请求成功

}, function (err, result) {

  // 请求失败

})
(3)加入请求报头,防止ip被屏蔽。
setting.js
/**

 * 加入请求报头,防止ip被屏蔽

 */

module.exports = {

  header : {

    'User-Agent': 'request',

    "Referer":"http://www.ivsky.com/",

  },

  // 并发数

  ajax_timeout : 2000,

  // 下载图片速度

  download_v : 5

}
(4)获取一些图片和超链接地址,可能是相对路径(待考虑解决是否有通过方法)。
// 下载图片

function downloadImg(photos, dir, asyncNum) {

  console.log("即将异步并发下载图片,当前并发数为:" + asyncNum);

  async.mapLimit(photos, asyncNum, function (photo, callback) {

    var filename = (new Date().getTime()) + photo.substr(-4, 4);

    if (filename) {

      console.log('正在下载' + photo);

      // 默认

      // fs.createWriteStream(dir + "/" + filename)

      // 防止pipe错误

      request(photo)

        .on('error', function (err) {

          console.log(err);

        })

        .pipe(fs.createWriteStream(dir + "/" + filename));

      console.log('下载完成');

      callback(null, filename);

    }

  }, function (err, result) {

    if (err) {

      console.log(err);

    } else {

      console.log(" all right ! ");

      console.log(result);

    }

  })

}
步骤五:完整代码
app.js
/**

 * node 爬虫

 */

var fs = require('fs');

var request = require("request");

var cheerio = require("cheerio");

var async = require('async');

// 目标网址

var url = 'http://www.ivsky.com/tupian/ziranfengguang/';

// 本地存储目录

var dir = './images';

var setting = require('./setting');

var timeout = 100;

// 封装了一层函数

function fetchre(url) {

  requestall(url);

}

// 发送请求

function requestall(url) {

  request({

    uri: url,

    headers: setting.header

  }, function (error, response, body) {

    if (error) {

      console.log(error);

    } else {

      console.log(response.statusCode);

      if (!error && response.statusCode == 200) {

        var $ = cheerio.load(body);

        var photos = [];

        $('img').each(function () {

          // 判断地址是否存在

          if ($(this).attr('src')) {

            var src = $(this).attr('src');

            var end = src.substr(-4, 4).toLowerCase();

            if (end == '.jpg' || end == '.gif' || end == '.png' || end == '.jpeg') {

              if (IsURL(src)) {

                photos.push(src);

              }

            }

          }

        });

        downloadImg(photos, dir, setting.download_v);

        // 递归爬虫

        $('a').each(function () {

          var murl = $(this).attr('href');

          if (IsURL(murl)) {

            setTimeout(function () {

              fetchre(murl);

            }, timeout);

            timeout += setting.ajax_timeout;

          } else {

            setTimeout(function () {

              fetchre("http://www.ivsky.com/" + murl);

            }, timeout);

            timeout += setting.ajax_timeout;

          }

        })

      }

    }

  });

}

// 下载图片

function downloadImg(photos, dir, asyncNum) {

  console.log("即将异步并发下载图片,当前并发数为:" + asyncNum);

  async.mapLimit(photos, asyncNum, function (photo, callback) {

    var filename = (new Date().getTime()) + photo.substr(-4, 4);

    if (filename) {

      console.log('正在下载' + photo);

      // 默认

      // fs.createWriteStream(dir + "/" + filename)

      // 防止pipe错误

      request(photo)

        .on('error', function (err) {

          console.log(err);

        })

        .pipe(fs.createWriteStream(dir + "/" + filename));

      console.log('下载完成');

      callback(null, filename);

    }

  }, function (err, result) {

    if (err) {

      console.log(err);

    } else {

      console.log(" all right ! ");

      console.log(result);

    }

  })

}

// 判断是否为完整地址

function IsURL(str_url) {

  var strRegex = '^((https|http|ftp|rtsp|mms)?://)';

  var re = new RegExp(strRegex);

  if (re.test(str_url)) {

    return (true);

  } else {

    return (false);

  }

}

requestall(url);
步骤六:执行
(1)在根路径下创建 images 空文件夹,用于存放下载下来的图片
(2)打开终端,执行
node app.js
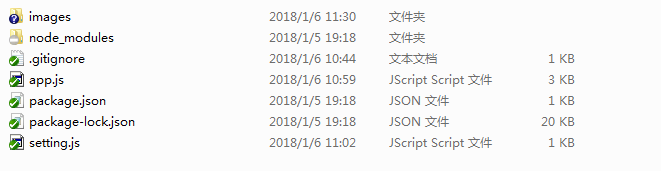
(3)项目目录
node 爬虫 --- 批量下载图片的更多相关文章
- 【Python】nvshens按目录批量下载图片爬虫1.00(单线程版)
# nvshens按目录批量下载图片爬虫1.00(单线程版) from bs4 import BeautifulSoup import requests import datetime import ...
- python图片爬虫 - 批量下载unsplash图片
前言 unslpash绝对是找图的绝佳场所, 但是进网站等待图片加载真的令人捉急, 仿佛是一场拼RP的战争 然后就开始思考用爬虫帮我批量下载, 等下载完再挑选, 操作了一下不算很麻烦, 顺便也给大家提 ...
- scrapy操作mysql/批量下载图片
1.操作mysql items.py meiju.py 3.piplines.py 4.settings.py -------------------------------------------- ...
- Node.js 使用爬虫批量下载网络图片到本地
图片网站往往广告众多,用Node.js写个爬虫下载图片,代码不长,省事不少,比手动一张张保存简直是天与地的区别.以前用Java也做过远程图片下载,但Node.js的下载速度更让人咂舌,这也是非阻塞式变 ...
- 利用Node 搭配uglify-js压缩js文件,批量下载图片到本地
Node的便民技巧-- 压缩代码 下载图片 压缩代码 相信很多前端的同学都会在上线前压缩JS代码,现在的Gulp Webpack Grunt......都能轻松实现.但问题来了,这些都不会,难道就要面 ...
- 用python批量下载图片
一 写爬虫注意事项 网络上有不少有用的资源, 如果需要合理的用爬虫去爬取资源是合法的,但是注意不要越界,前一阶段有个公司因为一个程序员写了个爬虫,导致公司200多个人被抓,所以先进入正题之前了解下什么 ...
- python——批量下载图片
前言 批量下载网页上的图片需要三个步骤: 获取网页的URL 获取网页上图片的URL 下载图片 例子 from html.parser import HTMLParser import urllib.r ...
- 如何用node.js批量给图片加水印
上一篇我们讲了如何用node.js给图片加水印,但是只是给某一张图片加,并没有涉及到批量处理.这一篇,我们学习如果批量进行图片加水印处理. 一.准备工作: 首先,你要阅读完这篇文章:http://ww ...
- javaWeb 批量下载图片
批量下载网页图片 CreateTime--2017年9月26日15:40:43 Author:Marydon 所用技术:javascript.java 测试浏览器:chrome 开发工具:Ecli ...
随机推荐
- day20-python之装饰器
1.装饰器 #!/usr/bin/env python # -*- coding:utf-8 -*- import time def cal(l): start_time=time.time() re ...
- [android开发篇]activity组件篇
https://developer.android.com/guide/components/activities.html Activity 是一个应用组件,用户可与其提供的屏幕进行交互,以执行拨打 ...
- 【MVC 1】MVC+EF实体框架—原理解析
导读:在之前,我们学过了三层框架,即:UI.BLL.DAL.我们将页面显示.逻辑处理和数据访问进行分层,避免了一层.两层的混乱.而后,我们又在经典三层的基础上,应用设计模式:外观.抽象工厂+反射,使得 ...
- mac上安装ruby
(转:http://www.cnblogs.com/daguo/p/4097263.html) 以下代码区域,带有 $ 打头的表示需要在控制台(终端)下面执行(不包括 $ 符号) 步骤0 - 安装系统 ...
- 注册苹果开发者账号和iOS9打包上线
链接: http://www.jianshu.com/p/507ca4e5fde0 http://blog.csdn.net/a283127993/article/details/45828175 i ...
- 【Luogu】P1072Hankson的趣味题(gcd)
这题真TM的趣味. 可以说我的动手能力还是不行,想到了算法却写不出来.以后说自己数论会GCD的时候只好虚了…… 我们首先这么想. x与a0的最大公约数为a1,那么我们把x/=a1,a0/=a1之后,x ...
- EC++学习笔记(四) 设计与声明
条款18:让接口容易被正确使用,不易被误用 必须考虑客户可能做出什么样的错误(防御式编程)std:shared_ptr会自动使用它的"每个指针专属的删除器",消除了"cr ...
- JavaScript 的时间消耗--摘抄
JavaScript 的时间消耗 2017-12-24 dwqs 前端那些事儿 随着我们的网站越来越依赖 JavaScript, 我们有时会(无意)用一些不易追踪的方式来传输一些(耗时的)东西. 在这 ...
- 【shell】shell编程(四)-循环语句
上篇我们学习了shell中条件选择语句的用法.接下来本篇就来学习循环语句.在shell中,循环是通过for, while, until命令来实现的.下面就分别来看看吧. for for循环有两种形式: ...
- PatentTips - Write Combining Buffer for Sequentially Addressed Partial Line Operations
SUMMARY OF THE INVENTION The present invention pertains to a write combining buffer for use in a mic ...