
[转]使用Scrapy建立一个网站抓取器
|
Scrapy是一个用于爬行网站以及在数据挖掘、信息处理和历史档案等大量应用范围内抽取结构化数据的应用程序框架,广泛用于工业。 在本文中我们将建立一个从Hacker News爬取数据的爬虫,并将数据按我们的要求存储在数据库中。 安装我们将需要Scrapy以及 BeautifulSoup用于屏幕抓取,SQLAlchemy用于存储数据. 如果你使用ubuntu已经其他发行版的unix可以通过pip命令安装Scrapy。
如果你使用Windows,你需要手工安装scrapy的一些依赖。 Windows用户需要pywin32、pyOpenSSL、Twisted、lxml和zope.interface。你可以下载这些包的编译版本来完成简易安装。 可以参照官方文档查看详情指导。 都安装好后,通过在python命令行下输入下面的命令验证你的安装:
如果没有返回内容,那么你的安装已就绪。 |
|
安装HNScrapy为了创建一个新项目,在终端里输入以下命令
这将会创建一系列的文件帮助你更容易的开始,cd 到 hn 目录然后打开你最喜欢的文本编辑器。 在items.py文件里,scrapy需要我们定义一个容器用于放置爬虫抓取的数据。如果你原来用过Django tutorial,你会发现items.py与Django中的models.py类似。 你将会发现class HnItem已经存在了,它继承自Item--一个scrapy已经为我们准备好的预定义的对象。 让我们添加一些我们真正想抓取的条目。我们给它们赋值为Field()是因为这样我们才能把元数据(metadata)指定给scrapy。
没什么难的--恩,就是这样。在scrapy里,没有别的filed类型,这点和Django不同。所以,我们和Field()杠上了。 scrapy的 Item类的行为类似于Python里面的dictionary,你能从中获取key和value。 |
开始写爬虫在spiders文件夹下创建一个hn_spider.py文件。这是奇迹发生的地方--这正是我们告诉scrapy如何找到我们寻找的确切数据的地方。正如你所想的那样,一个爬虫只针对一个特定网页。它可能不会在其他网站上工作。 在ht_spider.py里,我们将定义一个类,HnSpider以及一些通用属性,例如name和urls。 首先,我们先建立HnSpider类以及一些属性(在类内部定义的变量,也被称为field)。我们将从scrapy的BaseSpider继承:
前面的几个变量是自解释的:name定义了爬虫的名字,allowed_domains列出了 供爬虫爬行的允许域名(allowed domain)的base-URL,start_urls 列出了爬虫从这里开始爬行的URL。后续的URL将从爬虫从start_urls下载的数据的URL开始。 接着,scrapy使用XPath选择器从网站获取数据--通过一个给定的XPath从HTML数据的特定部分进行选择。正如它们的文档所说,"XPath |
|
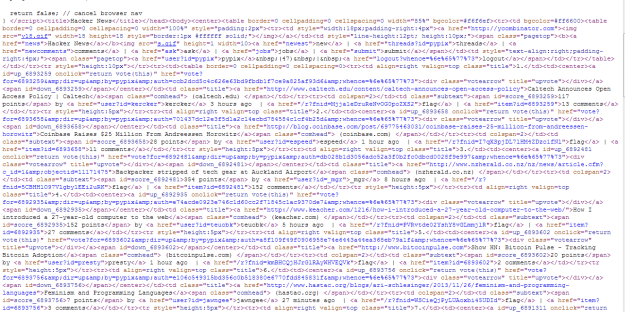
注意 在抓取你自己的站点并尝试计算 XPath 时, Chrome的 开发工具 提供了检查html元素的能力, 我们一般会基于一个定义好的Xpath来告诉 scrapy 到哪里去开始寻找数据. 让我们浏览我们的 Hacker News 站点,并右击选择”查看源代码“:
你会看到那个 sel.xpath('//td[@class="title"]') 有点貌似我们见过的HTML的代码. 从它们的 文档中你可以解读出构造XPath |
|
parse()方法使用了一个参数: response. 嘿,等一下 – 这个 self 是干什么的 – 看起来像是有两个参数! 每一个实体方法(在这种情况下, parse() 是一个实体方法 ) 接受一个对它自身的引用作为其第一个参数. 为了方便就叫做“self”. response 参数是抓取器在像Hacker News发起一次请求之后所要返回的东西. 我们会用我们的XPaths转换那个响应. 现在我们将使用 BeautifulSoup 来进行转换. Beautiful Soup 将会转换任何你给它的东西 . 下载 BeautifulSoup 并在抓取器目录里面创建 soup.py 文件,将代码复制到其中. 在你的hn_spider.py文件里面引入beautifulSoup 和来自 items.py的 Hnitem,并且像下面这样修改转换方法.
我们正在迭代这个items,并且给标题和链接赋上抓取来的数据. |
|
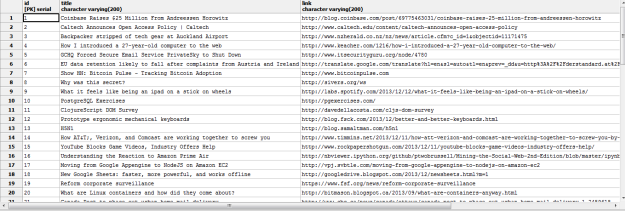
现在就试试对Hacker News域名进行抓取,你会看到连接和标题被打印在你的控制台上.
你将会在终端上看到大约400行的大量输出 ( 上面的输出之所以这么短,目的是为了方便观看 ). 你可以通过下面这个小命令将输出包装成JSON格式
现在我们已经基于正在找寻的项目实现了我们抓取器. |
! |
保存抓取到的数据我们开始的步骤是创建一个保存我们抓取到的数据的数据库。打开 settings.py 并且像下面展现的代码一样定义数据库配置。
再在 hn 目录下创建一个 mdels.py 文件。我们将要使用SQLAlchemy作为ORM框架建立数据库模型。 首先,我们需要定义一个直接连接到数据库的方法。为此,我们需要引入 SQLAlchemy 以及settings.py文件。
在开始下一步之前,我还想说明一下在 URL() 方法里两个星号的用法: **settings.DATABASE。首先,我们通过 settings.py 里的变量来访问数据库。这个 ** 实际上会取出所有在 DATABASE 路径下的值。URL 方法,一个在SQLAlchemy里定义的构造器,将会把key和value映射成一个SQLAlchemy能明白的URL来连接我们的数据库。 接着,URL() 方法将会解析其他元素,然后创建一个下面这样的将被 create_engine() 方法读取的URL。 接下来,我们要为我们的ORM创建一个表。我们需要 从 SQLAlchemy 引入declarative_base()以便把我们为表结构定义的类映射到Postgres上,以及一个从表的元数据里创建我们所需要的表的方法,还有我们已经定义好的用于存储数据的表和列。 |
! |
管道管理我们已经建立了用来抓取和解析HTML的抓取器, 并且已经设置了保存这些数据的数据库 . 现在我们需要通过一个管道来将两者连接起来. 打开 pipelines.py 并引入 SQLAlchemy的 sessionmaker 功能,用来绑定数据库 (创建那个连接), 当然也要引入我们的模型.
我们在这里创建了一个类, HnPipeline(). 我们有一个构造器函数 def __init__(self) 来通过定义引擎初始化这个类, hn表格,还使用定义的这个引擎绑定/连接到数据库. 然后我们定义 _process_item() 来获取参数, _item_ 和 _spider_. 我们建立了一个同数据库的会话, 然后打开一个我们的Hn()模型中的数据项. 然后我们通过电泳session.add()来将 Hn |
|
我们这里几乎还没有向 settings.py 中添加一个变量来告诉抓取器在处理数据时到哪里去找到我们的管道. 那就在 settings.py加入另外一个变量, ITEM_PIPELINES:
这就是我们刚才所定义管道的目录/模块的路径. 现在我们就可以将所有抓取到的数据放到我们的数据库中, 让我们试试看我们获取到了什么, 万岁!我们现在已经成功地把我们所抓取到的数据存入了数据库. 定时任务如果我们不得不定期手动去执行这个脚本,那将会是很烦人的. 所有这里需要加入定时任务 . 总结这是有关抓取的最简短小巧的教程,而scrapy拥有提供高级功能和可用性的更多特性. 从 Github 下载整个源代码. |
[转]使用Scrapy建立一个网站抓取器的更多相关文章
- 使用scrapy框架来进行抓取的原因
在python爬虫中:使用requests + selenium就可以解决将近90%的爬虫需求,那么scrapy就是解决剩下10%的吗? 这个显然不是这样的,scrapy框架是为了让我们的爬虫更强大. ...
- scrapy和selenium结合抓取动态网页
1.安装python (我用的是2.7版本的) 2.安装scrapy: 详情请参考 http://blog.csdn.net/wukaibo1986/article/details/8167590 ...
- 基于scrapy的分布式爬虫抓取新浪微博个人信息和微博内容存入MySQL
为了学习机器学习深度学习和文本挖掘方面的知识,需要获取一定的数据,新浪微博的大量数据可以作为此次研究历程的对象 一.环境准备 python 2.7 scrapy框架的部署(可以查看上一篇博客的简 ...
- [原创.数据可视化系列之十二]使用 nodejs通过async await建立同步数据抓取
做数据分析和可视化工作,最重要的一点就是数据抓取工作,之前使用Java和python都做过简单的数据抓取,感觉用的很不顺手. 后来用nodejs发现非常不错,通过js就可以进行数据抓取工作,类似jqu ...
- 从urllib和urllib2基础到一个简单抓取网页图片的小爬虫
urllib最常用的两大功能(个人理解urllib用于辅助urllib2) 1.urllib.urlopen() 2. urllib.urlencode() #适当的编码,可用于后面的post提交 ...
- sciencedirect 网站抓取过程
开发环境 C#+SQLite 软件使用教程: 设置页面 1. 首先录入需要查询的关键词,如果需要根据年去查询,可以勾选对应的年,支持多个年份查询.点击[设置关键字]按钮,把待查询关键 ...
- scrapy入门二(分页抓取文章入库)
分页抓取博客园新闻,先从列表里分析下一页按钮 相关代码: # -*- coding: utf-8 -*- import scrapy from cnblogs.items import Article ...
- PHP登入网站抓取并且抓取数据
有时候需要登入网站,然后去抓取一些有用的信息,人工做的话,太累了.有的人可以很快的做到登入,但是需要在登入后再去访问其他页面始终都访问不了,因为他们没有带Cookie进去而被当做是两次会话.下面看看代 ...
- Nutch2.1+mysql+solr3.6.1+中文网站抓取
1.mysql 数据库配置 linux mysql安装步骤省略. 在首先进入/etc/my.cnf (mysql为5.1的话就不用修改my.cnf,会导致mysql不能启动)在[mysqld] 下添加 ...
随机推荐
- rem
"em"是相对于其父元素来设置字体大小的,这样就会存在一个问题,进行任何元素设置,都有可能需要知道他父元素的大小,在我们多次使用时,就会带来无法预知的错误风险.而rem是相对于根元 ...
- SPI 驱动分析
断更博客两个月后我又回来了,眯着躺倒就能睡熟的小眼睛,在这儿敲键盘.这篇文章给你快乐,你有没有爱上我! SPI驱动由三部分组成,分别为drivers.core.device.通过bus总线连接.困了不 ...
- Oracle通过一个Value值查询数据库
---恢复内容开始--- 大家在想看看数据库中有哪些数据表中,哪些字段中有“helloworld” 这个字符串,现在数据库所有的表,视图都不能直接提供,所有必须通过循环去访问所有的数据表,所有的字段列 ...
- 跟小静读《jQuery权威指南》——目录
前言 2014年开始了,年底给自己制订的学习计划,第一步先从学习<jQuery权威指南>开始. jQuery大家都很比较熟悉,但是我经常是边用的时候边对照着API,这次找本书通读一遍,记录 ...
- category - junit用例分组执行
一.category 和 testSuite的比较 (1)testSuite是类级分组(xx.class) (2)category是用例级分组(@Test) (3)category是testSuite ...
- Objective-C( Foundation框架 一 NSDictionary (NSMutaleDictionary))
NSDictionary 不可变的字典 创建字典的方法 // 创建字典的方式 NSDictionary *dy = [NSDictionary dictionaryWithObject:@" ...
- ORACLE 连接SQLSERVER 数据库备忘
最近工作需要,要从SQL SERVER数据库中同步提取数据. 这里采用了 Oracle Gateway 来连接,折腾了半天,终于搞定,记录下已备下次使用. 基本资料网上都可以搜很多,官网配置说明在这 ...
- C++小项目:directx11图形程序(九):总结
整篇文章中对于directx11的知识的介绍并不多,我也不知道怎么介绍,也应该说对于directx,它有它自己的部分,比如设备(device),设备上下文(devicecontext),顶点缓存,索引 ...
- Git命令使用总结
Git 教學(1):Git的基本使用 Git 教學(2):Git Branch 的操作與基本工作流程 Git 情境劇:告訴你使用 Git 時什麼情況該下什麼指令 如何安裝 Git Mac : 安裝 H ...
- centos6环境下安装tmux
Install tmux on CentOS 6:1. sudo rpm -ivh http://pkgs.repoforge.org/rpmforge-release/rpmforge-releas ...