
<机器学习实战>读书笔记--决策树
1、决策树的构造
createBranch伪代码:
检测数据集中的每个子项是否属于同一分类:
IF SO RETURN 类标签
ELSE
寻找划分数据集的最好特征
划分数据集
创建分支节点
FOR 每个划分的子集
调用函数createBranch并增加返回结果到分支节点中
RETURN 分支节点
划分数据集的大原则:将无序的数据变的更加有序。在划分数据集之前之后信息发生的变化称为信息增益,获得信息增益最高的特征就是最好的选择
熵定义为信息的期望值。熵越大越离散。
计算给定数据集的香农熵
def calcShannonEnt(dataSet):

    numEntries = len(dataSet)

    labelCounts = {}

    for featVec in dataSet: #the the number of unique elements and their occurance

        currentLabel = featVec[-1]

        if currentLabel not in labelCounts.keys(): labelCounts[currentLabel] = 0

        labelCounts[currentLabel] += 1

    shannonEnt = 0.0

    for key in labelCounts:

        prob = float(labelCounts[key])/numEntries

        shannonEnt -= prob * log(prob,2) #log base 2

    return shannonEnt
2.决策树的构造算法
ID3算法
ID3算法是一种分类决策树算法。他通过一系列的规则,将数据最后分类成决策树的形式。分类的根据是用到了熵这个概念。熵在物理这门学科中就已经出现过,表示是一个物质的稳定度,在这里就是分类的纯度的一个概念。公式为:
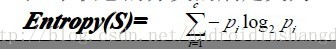
C4.5算法
C4.5与ID3在核心的算法是一样的,但是有一点所采用的办法是不同的,C4.5采用了信息增益率作为划分的根据,克服了ID3算法中采用信息增益划分导致属性选择偏向取值多的属性。信息增益率的公式为:
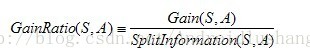
分母的位置是分裂因子,他的计算公式为:
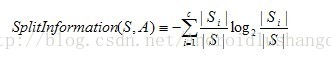
CART算法
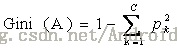
CART算法对于属性的值采用的是基于Gini系数值的方式做比较,gini某个属性的某次值的划分的gini指数的值为:
<机器学习实战>读书笔记--决策树的更多相关文章
- 机器学习实战 - 读书笔记(13) - 利用PCA来简化数据
前言 最近在看Peter Harrington写的"机器学习实战",这是我的学习心得,这次是第13章 - 利用PCA来简化数据. 这里介绍,机器学习中的降维技术,可简化样品数据. ...
- 机器学习实战 - 读书笔记(12) - 使用FP-growth算法来高效发现频繁项集
前言 最近在看Peter Harrington写的"机器学习实战",这是我的学习心得,这次是第12章 - 使用FP-growth算法来高效发现频繁项集. 基本概念 FP-growt ...
- 机器学习实战 - 读书笔记(11) - 使用Apriori算法进行关联分析
前言 最近在看Peter Harrington写的"机器学习实战",这是我的学习心得,这次是第11章 - 使用Apriori算法进行关联分析. 基本概念 关联分析(associat ...
- 机器学习实战 - 读书笔记(07) - 利用AdaBoost元算法提高分类性能
前言 最近在看Peter Harrington写的"机器学习实战",这是我的学习笔记,这次是第7章 - 利用AdaBoost元算法提高分类性能. 核心思想 在使用某个特定的算法是, ...
- 机器学习实战 - 读书笔记(06) – SVM支持向量机
前言 最近在看Peter Harrington写的"机器学习实战",这是我的学习笔记,这次是第6章:SVM 支持向量机. 支持向量机不是很好被理解,主要是因为里面涉及到了许多数学知 ...
- 【转载】 机器学习实战 - 读书笔记(07) - 利用AdaBoost元算法提高分类性能
原文地址: https://www.cnblogs.com/steven-yang/p/5686473.html ------------------------------------------- ...
- 机器学习实战 - 读书笔记(14) - 利用SVD简化数据
前言 最近在看Peter Harrington写的"机器学习实战",这是我的学习心得,这次是第14章 - 利用SVD简化数据. 这里介绍,机器学习中的降维技术,可简化样品数据. 基 ...
- 机器学习实战读书笔记(二)k-近邻算法
knn算法: 1.优点:精度高.对异常值不敏感.无数据输入假定 2.缺点:计算复杂度高.空间复杂度高. 3.适用数据范围:数值型和标称型. 一般流程: 1.收集数据 2.准备数据 3.分析数据 4.训 ...
- <机器学习实战>读书笔记--朴素贝叶斯
1.朴素贝叶斯法是基于贝叶斯定理与特征条件独立假设的分类方法, 最为广泛的两种分类模型是决策树模型(Decision Tree Model)和朴素贝叶斯模型(Naive Bayesian Model, ...
随机推荐
- backbone.js 学习笔记
Backbone.Model 模型.相当于表定义,定义一个表当中有的列 defaults:设置属性的默认值 initialize():初始化函数 get(key):获取属性值 set(data):设置 ...
- Python2.4+ 与 Python3.0+ 主要变化与新增内容
Python2 Python3print是内置命令 print变为函数print >> f,x,y ...
- 字体变色详解链接:https://www.cnblogs.com/daofaziran/p/9015284.html
格式:\033[显示方式;前景色;背景色m + 结尾部分:\033[0m 字体色 | 背景色 | 颜色描述 ------------------------------------------- 30 ...
- 浅谈TCP通讯
基于Tcp协议的Socket通讯类似于B/S架构,面向连接,但不同的是服务器端可以向客户端主动推送消息. 使用Tcp协议通讯需要具备以下几个条件: (1).建立一个套接字(Socket) (2).绑定 ...
- Yaoge’s maximum profit HDU - 5052
Yaoge’s maximum profit Time Limit: 10000/5000 MS (Java/Others) Memory Limit: 65536/65536 K (Java/ ...
- COOKIE的优化与购物车小试
由于经常被抓取文章内容,在此附上博客文章网址:,偶尔会更新某些出错的数据或文字,建议到我博客地址 : --> 点击这里 一 Cookie 的优化 1.1 一般而言,我们设置cookie是在ph ...
- 孩子们各显神通对付 iOS 12「屏幕使用时间」的限制
简评:2018 年秋季,苹果公司推出了 iOS 12,其中备受好评的一项改变是:增加了屏幕使用时间限制,以减轻沉迷手机的状况.三个月过去后,这项功能似乎并没有对孩子造成太多困扰,道高一尺魔高一丈,孩子 ...
- Ionic2 启动加载优化总结
1. ionic2通过ionic serve生成的main.js大于4M,必须先build才能部署 npm run ionic:build --prod 之后main.js缩小为大概100K+ 2. ...
- java爬虫中jsoup的使用
jsoup可以用来解析HTML的内容,其功能非常强大,它可以向javascript那样直接从网页中提取有用的信息 例如1: 从html字符串中解析数据 //直接从字符串中获取 public stati ...
- day 13 课后作业
# -*- coding: utf-8 -*-# @Time : 2019/1/7 18:00# @Author : Endless-cloud# @Site : # @File : day 13 课 ...