
solr 中文分词器IKAnalyzer和拼音分词器pinyin
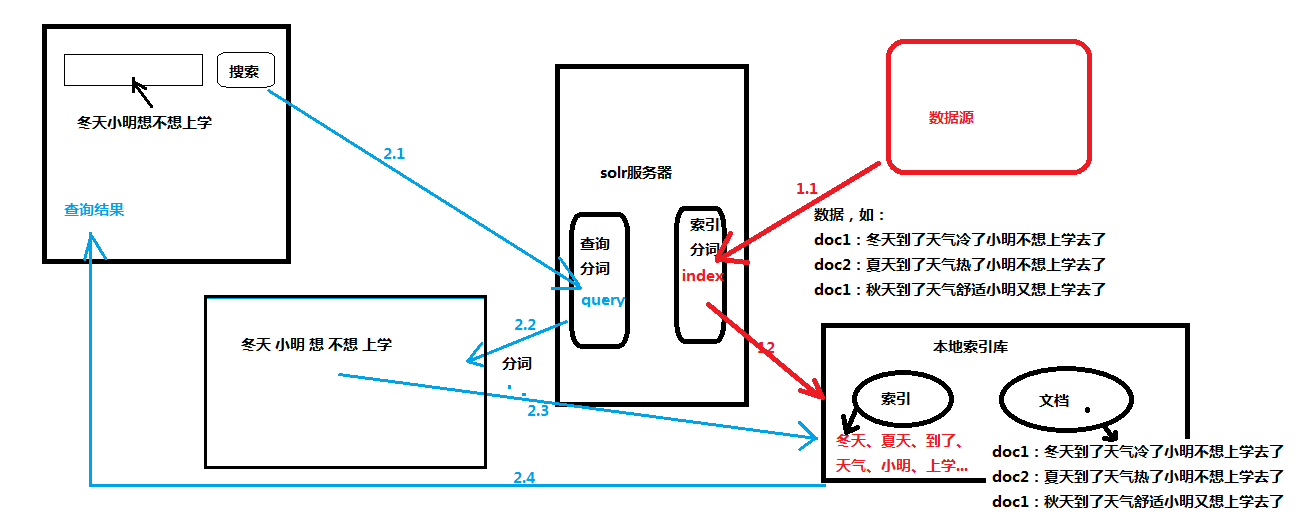
solr分词过程:
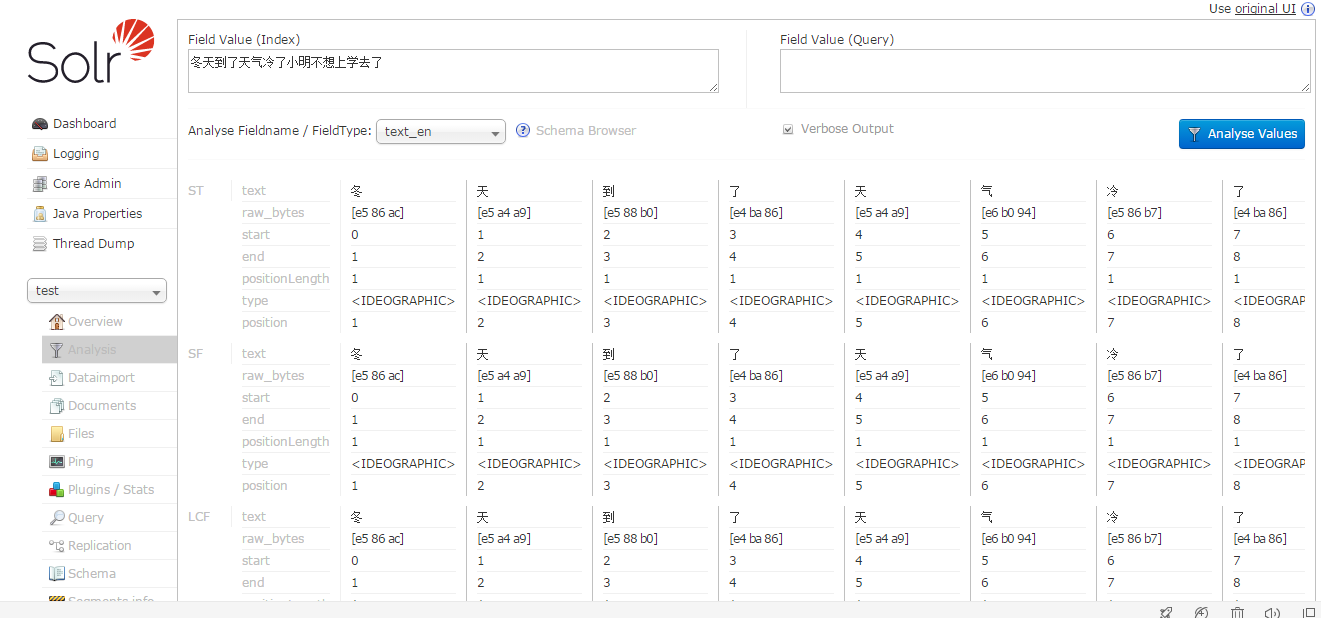
Solr Admin中,选择Analysis,在FieldType中,选择text_en
左边框输入 “冬天到了天气冷了小明不想上学去了”,点击右边的按钮,发现对每个字都进行分词。这不符合中国人的习惯。
solr6.3.0自带中文分词包,在 \solr-6.3.0\contrib\analysis-extras\lucene-libs\lucene-analyzers-smartcn-6.3.0.jar,但是不能自定义词库
好在我们有IKAnalyzer(已无人更新,目前版本是2012)和pinyin分词插件。
IKAnalyzer安装
IKAnalyzer下载地址:https://github.com/EugenePig/ik-analyzer-solr5
因为原始的IKAnalyzer已经不支持solr5以后的版本,这里是修改过后的
用git clone到本地或者直接下载zip到本地,然后执行mvn clean instal(Java8),或者mvn clean -Djavac.src.version=1.7 -Djavac.target.version=1.7 install(jdk1.7)
执行完,在项目 /target 目录下,看到jar文件
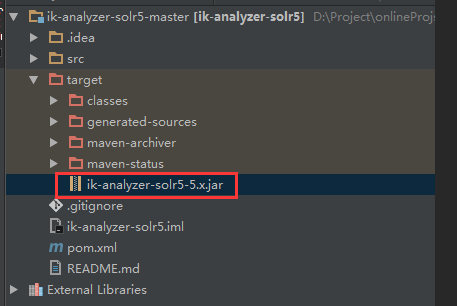
将改jar文件copy到 solr目录:\solr-6.3.0\server\solr-webapp\webapp\WEB-INF\lib
然后修改core的配置文件:\solr-6.3.0\server\solr\test\conf\managed-schema
添加如下配置:
<fieldType name="text_ik" class="solr.TextField">

  <analyzer type="index">

    <tokenizer class="org.wltea.analyzer.lucene.IKTokenizerFactory" useSmart="false" />

  </analyzer>

  <analyzer type="query">

    <tokenizer class="org.wltea.analyzer.lucene.IKTokenizerFactory" useSmart="true" />

  </analyzer>

</fieldType>
或者
<fieldType name="text_ik" class="solr.TextField">

  <analyzer type="index" useSmart="false" class="org.wltea.analyzer.lucene.IKAnalyzer"/>

  <analyzer type="query" useSmart="true" class="org.wltea.analyzer.lucene.IKAnalyzer"/>

</fieldType>
保存重启solr,到选择test核心-Analysis,进入分词页面,输入“冬天到了天气冷了小明不想上学去了”,FieldType选择“text_cn”,点击Analyse Value按钮:
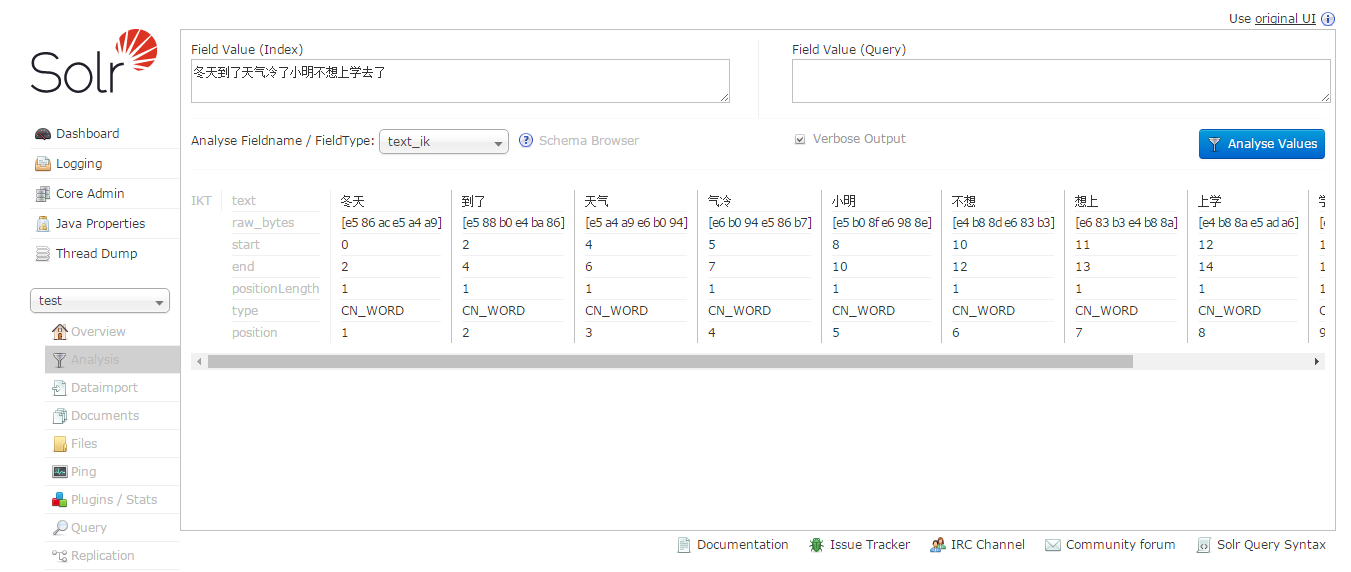
看到已经分词中文成功了。
pinyin安装
pinyin下载地址:http://files.cnblogs.com/files/wander1129/pinyin.zip
下载后将2个jar文件copy到\solr-6.3.0\server\solr-webapp\webapp\WEB-INF\lib目录下,
然后修改core的配置文件:\solr-6.3.0\server\solr\test\conf\managed-schema,添加:
<!-- 配置拼音分词 pinyin-->

    <fieldType name="text_pinyin" class="solr.TextField" positionIncrementGap="0">

        <analyzer type="index">

            <tokenizer class="org.apache.lucene.analysis.ik.IKTokenizerFactory"/>

            <filter class="com.shentong.search.analyzers.PinyinTransformTokenFilterFactory" minTermLenght="2" />

            <filter class="com.shentong.search.analyzers.PinyinNGramTokenFilterFactory" minGram="1" maxGram="20" />

        </analyzer>

        <analyzer type="query">

            <tokenizer class="org.apache.lucene.analysis.ik.IKTokenizerFactory"/>

            <filter class="com.shentong.search.analyzers.PinyinTransformTokenFilterFactory" minTermLenght="2" />

            <filter class="com.shentong.search.analyzers.PinyinNGramTokenFilterFactory" minGram="1" maxGram="20" />

        </analyzer>

    </fieldType>
重启solr
到选择test核心-Analysis,进入分词页面,输入“冬天到了天气冷了小明不想上学去了”,FieldType选择“text_pinyin”,点击Analyse Value按钮:
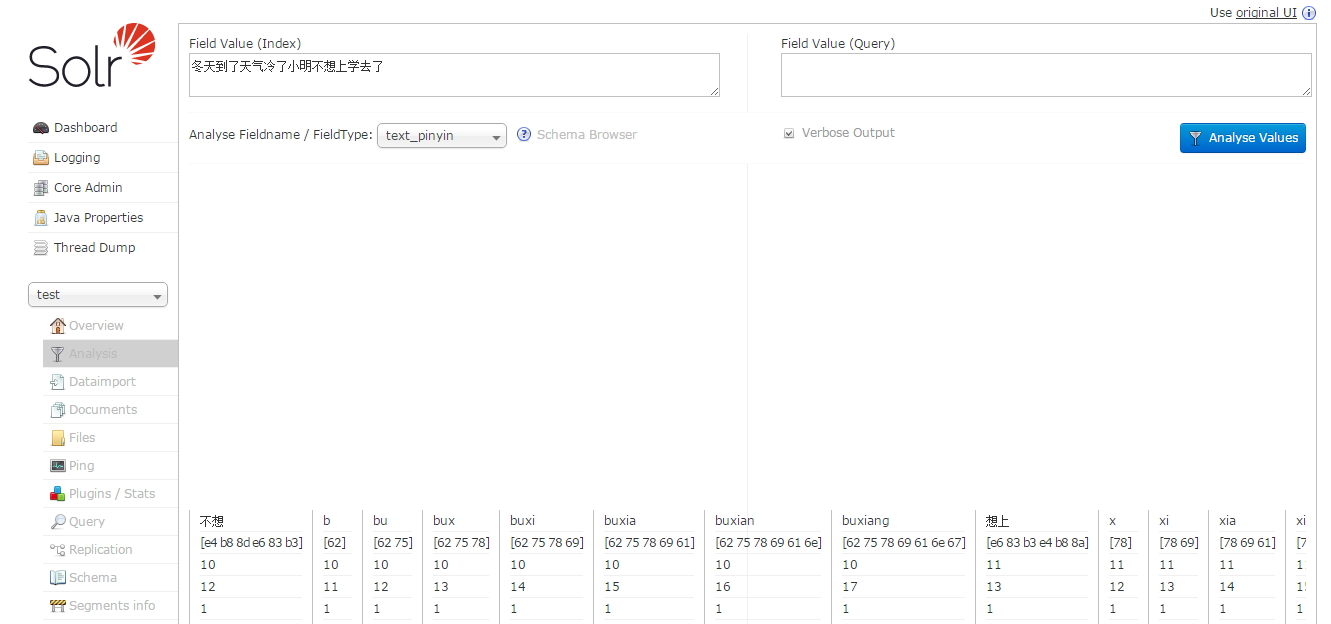
看到汉字转成拼音了。
solr 中文分词器IKAnalyzer和拼音分词器pinyin的更多相关文章
- 如何在Elasticsearch中安装中文分词器(IK)和拼音分词器?
声明:我使用的Elasticsearch的版本是5.4.0,安装分词器前请先安装maven 一:安装maven https://github.com/apache/maven 说明: 安装maven需 ...
- 开源项目在线化 中文繁简体转换/敏感词/拼音/分词/汉字相似度/markdown 目录
前言 以前在 github 上自己开源了一些项目.碍于技术与精力,大部分项目都是 java 实现的. 这对于非 java 开发者而言很不友好,对于不会编程的用户更加不友好. 为了让更多的人可以使用到这 ...
- Solr6.5配置中文分词IKAnalyzer和拼音分词pinyinAnalyzer (二)
之前在 Solr6.5在Centos6上的安装与配置 (一) 一文中介绍了solr6.5的安装.这篇文章主要介绍创建Solr的Core并配置中文IKAnalyzer分词和拼音检索. 一.创建Core: ...
- es 修改拼音分词器源码实现汉字/拼音/简拼混合搜索时同音字不匹配
[版权声明]:本文章由danvid发布于http://danvid.cnblogs.com/,如需转载或部分使用请注明出处 在业务中经常会用到拼音匹配查询,大家都会用到拼音分词器,但是拼音分词器匹配的 ...
- elasticsearch 拼音+ik分词,spring data elasticsearch 拼音分词
elasticsearch 自定义分词器 安装拼音分词器.ik分词器 拼音分词器: https://github.com/medcl/elasticsearch-analysis-pinyin/rel ...
- solr服务中集成IKAnalyzer中文分词器、集成dataimportHandler插件
昨天已经在Tomcat容器中成功的部署了solr全文检索引擎系统的服务:今天来分享一下solr服务在海量数据的网站中是如何实现数据的检索. 在solr服务中集成IKAnalyzer中文分词器的步骤: ...
- solr 中文分词 IKAnalyzer
solr中文分词器ik, 推荐资料:http://iamyida.iteye.com/blog/2220474?utm_source=tuicool&utm_medium=referral 使 ...
- 全文检索引擎Solr系列——整合中文分词组件IKAnalyzer
IK Analyzer是一款结合了词典和文法分析算法的中文分词组件,基于字符串匹配,支持用户词典扩展定义,支持细粒度和智能切分,比如: 张三说的确实在理 智能分词的结果是: 张三 | 说的 | 确实 ...
- Solr7.3.0入门教程,部署Solr到Tomcat,配置Solr中文分词器
solr 基本介绍 Apache Solr (读音: SOLer) 是一个开源的搜索服务器.Solr 使用 Java 语言开发,主要基于 HTTP 和 Apache Lucene 实现.Apache ...
随机推荐
- [NOI2010]超级钢琴(RMQ+堆)
小Z是一个小有名气的钢琴家,最近C博士送给了小Z一架超级钢琴,小Z希望能够用这架钢琴创作出世界上最美妙的音乐. 这架超级钢琴可以弹奏出n个音符,编号为1至n.第i个音符的美妙度为Ai,其中Ai可正可负 ...
- SHOI2008仙人掌图(tarjan+dp)
Solution 好题啊没的说. 本题需要求出仙人掌的直径,但仙人掌是一个带有简单环的一张图无法直接用树形dp求解,但它有一个好东西就是没有类似环套环的东西,所以我们在处理时就方便了一些. 思路:ta ...
- Luogu P1648 看守
Luogu P1648 看守 题意简述 有n个d维的点,输出这些点两两之间曼哈顿距离中的最大值 数据范围 n<=1e6,d<=4 思路 暴力?时间复杂度O(\(n^2d\)) 考虑这样的一 ...
- Nginx环境的搭建
源码安装 不同发行版使用的安装程序都不同,所以官方提供了源代码,我们需要将原代码编译后再安装. 源程序使用C语言开发,所以需要安装C语言的编译环境. 安装Nginx环境和第三方支持库 yum inst ...
- 【CF600E】Lomsat gelral
题目大意:给定一棵 N 个节点的有根树,1 号节点是树的根节点,每个节点有一个颜色.求对于每个节点来说,能够支配整棵子树的颜色之和是多少.支配的定义为对于以 i 为根的子树,该颜色出现的次数不小于任何 ...
- [NOIP2018]旅行(数据加强版)(图论+基环树)
数据范围多了2个0就是不一样,O(n^2)只能68分了.(其中60分是n=m+1和原题一样的做法送的),这题直接从NOIP难度变为NOI Plus难度了不说废话直接写题解:首先dfs一遍找到环,然后和 ...
- 第二十九节,目标检测算法之R-CNN算法详解
Girshick, Ross, et al. “Rich feature hierarchies for accurate object detection and semantic segmenta ...
- C++基础知识-Day5
今天主要讲的是类的扩展 1.类成员函数的存储方式 首先我们介绍类成员函数的存储方式,C++引入面向对象的概念之后,C语言中的一些比如static/const等原有语义,作一些升级,此时既要保持兼容,还 ...
- c#中委托和事件区别
委托和事件相同的功能 class Dem5 { public Action deHandler; public event Action eveHa; public Dem5() { deHandle ...
- icmpsh解决运行报错
运行./run.sh报错 sysctl -w net.ipv4.icmp_echo_ignore_all=1 >/dev/null python icmpsh_m.py 攻击机ip 目标机ip ...