
Flink 物理分区
Flink还通过以下函数对转换后的数据精确流分区进行低级控制(如果需要)。
1、自定义分区
使用用户定义的分区程序为每个元素选择目标任务。
dataStream.partitionCustom(partitioner, "someKey")

dataStream.partitionCustom(partitioner, 0)
如简单的hash 分区(下面的实例不是官网):
val input = env.addSource(source)

      .map(json => {

        // json : {"id" : 0, "createTime" : "2019-08-24 11:13:14.942", "amt" : "9.8"}

        val id = json.get("id").asText()

        val createTime = json.get("createTime").asText()

        val amt = json.get("amt").asText()

        LateDataEvent("key", id, createTime, amt)

      })

      .setParallelism(1)

      .partitionCustom(new Partitioner[String] {

        override def partition(key: String, numPartitions: Int): Int = {

          // numPartitions 是下游算子的并发数

          key.hashCode % numPartitions

        }

      }, "id")

      .map(l => {

        LateDataEvent(l.key, l.id, l.amt, l.createTime)

      })

      .setParallelism(3)
注:key 是传入的field 的类型
2、随机分区
根据均匀分布随机分配元素(类似于: random.nextInt(5),0 - 5 在概率上是均匀的)
dataStream.shuffle()
源码:
@Internal

public class ShufflePartitioner<T> extends StreamPartitioner<T> {

    private static final long serialVersionUID = 1L;

    private Random random = new Random();

    @Override

    public int selectChannel(SerializationDelegate<StreamRecord<T>> record) {
        // 传入下游分区数

        return random.nextInt(numberOfChannels);

    }

    @Override

    public StreamPartitioner<T> copy() {

        return new ShufflePartitioner<T>();

    }

    @Override

    public String toString() {

        return "SHUFFLE";

    }

}
3、均匀分区 rebalance
分区元素循环,每个分区创建相等的负载。在存在数据偏斜时用于性能优化。
dataStream.rebalance()
源码:
public class RebalancePartitioner<T> extends StreamPartitioner<T> {

    private static final long serialVersionUID = 1L;

    private int nextChannelToSendTo;

    @Override

    public void setup(int numberOfChannels) {

        super.setup(numberOfChannels);

        nextChannelToSendTo = ThreadLocalRandom.current().nextInt(numberOfChannels);

    }

    @Override

    public int selectChannel(SerializationDelegate<StreamRecord<T>> record) {

        // 轮训的发往下游分区

        nextChannelToSendTo = (nextChannelToSendTo + 1) % numberOfChannels;

        return nextChannelToSendTo;

    }

    public StreamPartitioner<T> copy() {

        return this;

    }

    @Override

    public String toString() {

        return "REBALANCE";

    }

}
4、rescale
分区元素循环到下游操作的子集。如果您希望拥有管道,例如,从源的每个并行实例扇出到多个映射器的子集以分配负载但又不希望发生rebalance()会产生完全重新平衡,那么这非常有用。这将仅需要本地数据传输而不是通过网络传输数据,具体取决于其他配置值,例如TaskManagers的插槽数。
上游操作发送元素的下游操作的子集取决于上游和下游操作的并行度。例如,如果上游操作具有并行性2并且下游操作具有并行性4,则一个上游操作将元素分配给两个下游操作,而另一个上游操作将分配给另外两个下游操作。另一方面,如果下游操作具有并行性2而上游操作具有并行性4,那么两个上游操作将分配到一个下游操作,而另外两个上游操作将分配到其他下游操作。在不同并行度不是彼此的倍数的情况下,一个或多个下游操作将具有来自上游操作的不同数量的输入。
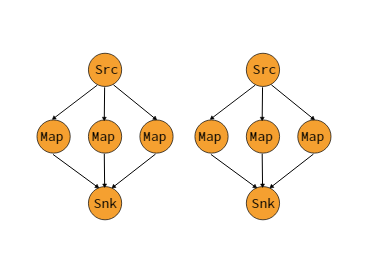
dataStream.rescale()
源码:
public class RescalePartitioner<T> extends StreamPartitioner<T> {

    private static final long serialVersionUID = 1L;

    private int nextChannelToSendTo = -1;

    @Override

    public int selectChannel(SerializationDelegate<StreamRecord<T>> record) {
        if (++nextChannelToSendTo >= numberOfChannels) {

            nextChannelToSendTo = 0;

        }

        return nextChannelToSendTo;

    }

    public StreamPartitioner<T> copy() {

        return this;

    }

    @Override

    public String toString() {

        return "RESCALE";

    }

}
很遗憾这段代码只能看出,上游分区往下游分区发的时候,每个上游分区内部的数据是轮训发到下游分区的(没找到具体分配的地方,从这段代码debug,一直往上,找到分区出现在 RuntimeEnvironment 的对象里面,找不具体分配的地方)。
5、广播
向每个分区广播元素。
dataStream.broadcast()
Flink 物理分区的更多相关文章
- linux下vmware的安装、物理分区使用及卸载
1.安装 先下载安装文件VMware-Workstation-Full-12 在命令行下执行下载的文件安装即可(需要root权限) wget https://download3.vmware.com/ ...
- 扩大缩小Linux物理分区大小
由于产品在不同的标段,设备硬盘也不同, 有些500G,有些320G有些200G,开始在大硬盘上做的配置,想把自己定制好的Linux克隆到小硬盘上,再生龙会纠结空间大小的问题, 因此需要做一些分区的改变 ...
- ubuntu下挂载物理分区到openmediavault4
准备弄个NAS,但还没想好直接买现成,还是自己组装一台,先在虚拟机上体验下OpenMediaVault4和黑群晖.主系统是ubuntu,但刚买的时候这笔记本是装windows的,除了ubuntu的系统 ...
- aliyun添加数据盘后的物理分区和lvm逻辑卷两种挂载方式
一.普通磁盘分区管理方式 1.对磁盘进行分区 列出磁盘 # fdisk -l # fdisk /dev/vdb Welcome to fdisk (util-linux 2.23.2). Change ...
- linux 分区 物理卷 逻辑卷
今天我们主要说说分区.格式化.SWAP.LVM.软件RAID的创建哈~ 格式化 查看当前分区:fdisk -l 这个命令我们以前是讲过的,我现在问下,ID那项是什么意思? 83 是代表EXT2和E ...
- linux磁盘 分区 物理卷 卷组 逻辑卷 文件系统加载点操作案例
转自:truemylife.linux磁盘 分区 物理卷 卷组 逻辑卷 文件系统加载点操作案例 基本概念: 磁盘.分区.物理卷[物理部分] 卷组[中间部分] 逻辑卷.文件系统[虚拟化后可控制部分] 磁 ...
- Flink学习笔记:Operators串烧
本文为<Flink大数据项目实战>学习笔记,想通过视频系统学习Flink这个最火爆的大数据计算框架的同学,推荐学习课程: Flink大数据项目实战:http://t.cn/EJtKhaz ...
- <译>Flink编程指南
Flink 的流数据 API 编程指南 Flink 的流数据处理程序是常规的程序 ,通过再流数据上,实现了各种转换 (比如 过滤, 更新中间状态, 定义窗口, 聚合).流数据可以来之多种数据源 (比如 ...
- flink学习笔记-split & select(拆分流)
说明:本文为<Flink大数据项目实战>学习笔记,想通过视频系统学习Flink这个最火爆的大数据计算框架的同学,推荐学习课程: Flink大数据项目实战:http://t.cn/EJtKh ...
随机推荐
- C++编译原理
链接
- python字符转数字
print(float("260.01478420521632365364543423")) 260.0147842052163
- java web 向数据库插入中文数据乱码问题
一.先检查下是 页面返回数据时已经乱码了,还是在插入数据库的时候乱的码. 二.页面返回乱码: 1. Web.XML 文件配置 <!-- 配置编码过滤器 --> <filter&g ...
- SpringBoot官方文档学习(三)配置文件、日志、国际化和JSON
一.Profiles Spring配置文件提供了一种方法来隔离应用程序配置的各个部分,并使其仅在某些环境中可用.任何@Component.@Configuration或@ConfigurationPr ...
- 学习Spring-Data-Jpa(七)---JpaRepository
之前我们学习的Repository都是Spring-Data为了兼容NoSQL而进行的一些抽象封装,从JpaRepository开始是对关系型数据库进行抽象封装.JpaRepository位于spri ...
- js之大文件断点续传
文件夹上传:从前端到后端 文件上传是 Web 开发肯定会碰到的问题,而文件夹上传则更加难缠.网上关于文件夹上传的资料多集中在前端,缺少对于后端的关注,然后讲某个后端框架文件上传的文章又不会涉及文件夹. ...
- Error Codes Messages查找工具介绍
当我们通过各种手段获取到一个Windows错误码后,如何获取对应的错误消息呢?有两种方法:一是用编程的手段(FormatMessage):其二是用现成的工具.第一种方法一般在我们编码的时候有用,而更多 ...
- (26)打鸡儿教你Vue.js
weex框架的使用 1.weex开发入门 2.weex开发环境搭建 3.掌握部分weex组件模块 4.了解一些vue基本常见语法 5.制作一个接近原生应用体验的app weex介绍 安装开发环境 We ...
- 利用HTML和CSS设计一个静态的“小米商城官网首页”
一.小项目说明 这是个例行的小项目练习,主要利用html和css的基础知识,复刻一个缩减版的小米商城网页.包括[导航栏].[头部logo区,快捷键.搜索框].[网页主体].[网页尾部]几个部分.目前只 ...
- Pyspark 最近使用的一些有趣姿势的梳理
之前对 SQL 还是不是非常熟悉的,但是现在或多或少还是会写一些计算任务.比如最近在推送将所有天级的耗时任务都从传统关系型数据库迁移至 Spark 集群当中进行计算,中间遇到一些有趣的小问题在这里记录 ...