
【算法】BitMap
转自:https://www.seoxiehui.cn/article-45186-1.html
需求:
为满足用户标签的统计需求,小灰利用Mysql设计了如下的表结构,每一个维度的标签都对应着Mysql表的一列:要想统计所有90后的程序员该怎么做呢


两个月之前——


为满足用户标签的统计需求,小灰利用Mysql设计了如下的表结构,每一个维度的标签都对应着Mysql表的一列:

要想统计所有90后的程序员该怎么做呢?
用一条求交集的SQL语句即可:
Select count(distinct Name) as 用户数 from table whare age = '90后' and Occupation = '程序员' ;
要想统计所有使用苹果手机或者00后的用户总合该怎么做?
用一条求并集的SQL语句即可:
Select count(distinct Name) as 用户数 from table whare Phone = '苹果' or age = '00后' ;

两个月之后——


———————————————


1. 给定长度是10的bitmap,每一个bit位分别对应着从0到9的10个整型数。此时bitmap的所有位都是0。

2. 把整型数4存入bitmap,对应存储的位置就是下标为4的位置,将此bit置为1。

3. 把整型数2存入bitmap,对应存储的位置就是下标为2的位置,将此bit置为1。

4. 把整型数1存入bitmap,对应存储的位置就是下标为1的位置,将此bit置为1。

5. 把整型数3存入bitmap,对应存储的位置就是下标为3的位置,将此bit置为1。

要问此时bitmap里存储了哪些元素?显然是4,3,2,1,一目了然。
Bitmap不仅方便查询,还可以去除掉重复的整型数。


1. 建立用户名和用户ID的映射:

2. 让每一个标签存储包含此标签的所有用户ID,每一个标签都是一个独立的Bitmap。

3. 这样,实现用户的去重和查询统计,就变得一目了然:


1. 如何查找使用苹果手机的程序员用户?

2. 如何查找所有男性或者00后的用户?


一周之后......



我们以上一期的用户数据为例,用户基本信息如下。按照年龄标签,可以划分成90后、00后两个Bitmap:

用更加形象的表示,90后用户的Bitmap如下:

这时候可以直接求得非90后的用户吗?直接进行非运算?

显然,非90后用户实际上只有1个,而不是图中得到的8个结果,所以不能直接进行非运算。


同样是刚才的例子,我们给定90后用户的Bitmap,再给定一个全量用户的Bitmap。最终要求出的是存在于全量用户,但又不存在于90后用户的部分。

如何求出呢?我们可以使用异或操作,即相同位为0,不同位为1。




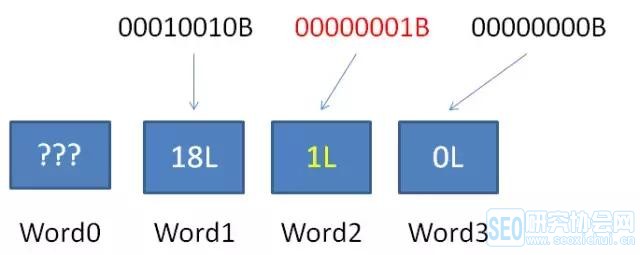


25769803776L = 11000000000000000000000000000000000B
8589947086L = 1000000000000000000011000011001110B


1.解析Word0,得知当前RLW横跨的空Word数量为0,后面有连续3个普通Word。
2.计算出当前RLW后方连续普通Word的最大ID是 64 X (0 + 3) -1 = 191。
3. 由于 191 < 400003,所以新ID必然在下一个RLW(Word4)之后。
4.解析Word4,得知当前RLW横跨的空Word数量为6247,后面有连续1个普通Word。
5.计算出当前RLW(Word4)后方连续普通Word的最大ID是191 + (6247 + 1)X64 = 400063。
6.由于400003 < 400063,因此新ID 400003的正确位置就在当前RLW(Word4)的后方普通Word,也就是Word5当中。
最终插入结果如下:


官方说明如下:
* Though you can set the bits in any order (e.g., set(100), set(10), set(1),* you will typically get better performance if you set the bits in increasing order (e.g., set(1), set(10), set(100)).* * Setting a bit that is larger than any of the current set bit* is a constant time operation. Setting a bit that is smaller than an * already set bit can require time proportional to the compressed* size of the bitmap, as the bitmap may need to be rewritten.

几点说明:
1. 该项目最初的技术选型并非Mysql,而是内存数据库hana。本文为了便于理解,把最初的存储方案写成了Mysq数据库。
1.文中介绍的Bitmap优化方法在一定程度上做了简化,源码中的逻辑要复杂得多。比如对于插入数据400003的定位,和实际步骤是有出入的。
2.如果同学们有兴趣,可以亲自去阅读源码,甚至是尝试实现自己的Bitmap算法。虽然要花不少时间,但这确实是一种很好的学习方法。
EWAHCompressedBitmap对应的maven依赖如下:
<dependency>

  <groupId>com.googlecode.javaewah</groupId>

  <artifactId>JavaEWAH</artifactId>

  <version>1.1.0</version>

</dependency>
【算法】BitMap的更多相关文章
- 海量数据处理算法—Bit-Map
原文:http://blog.csdn.net/hguisu/article/details/7880288 1. Bit Map算法简介 来自于<编程珠玑>.所谓的Bit-map就是用一 ...
- 海量数据处理算法—BitMap
1. Bit Map算法简介 来自于<编程珠玑>.所谓的Bit-map就是用一个bit位来标记某个元素对应的Value, 而Key即是该元素.由于采用了Bit为单位来存储数据,因此在存储空 ...
- 算法---BitMap
问题: 假设有3亿个整数(范围0-2亿),如何判断某一个树是否存在.局限条件一台机器,内存500m. 常规的思路:我们可以将数据存到一个集合中,然后判断某个数是否存在:或者用一个等长的数组来表示,每个 ...
- 从一道高大上的面试题来学习位图算法BitMap
今天我偶然刷到了一篇文章,"华为二面:一个文件里面有5亿个数据,一行一个,没有重复的,进行排序".不知道又是哪个无良媒体瞎起的标题,夺人眼球. 不过说归说,这题听着就很高大上,5亿 ...
- [Android算法] bitmap 将图片压缩到指定的大小
Bitmap压缩到指定大小: private void imageZoom() {//图片允许最大空间 单位:KBdouble maxSize =400.00;//将bitmap放至数组中,意在bit ...
- 复选框与bitmap算法实践
bitmap(位图)算法 bitmap算法是利用数据二进制的每一位的值来表示数据的算法,可用来压缩保存数据集. 如何保存 如 5(int)的二进制表示为 101b,第一位和第三位的值是1就可以表示数据 ...
- Android图片缓存之Bitmap详解
前言: 最近准备研究一下图片缓存框架,基于这个想法觉得还是先了解有关图片缓存的基础知识,今天重点学习一下Bitmap.BitmapFactory这两个类. 图片缓存相关博客地址: Android图片缓 ...
- 大数据分析常用去重算法分析『Bitmap 篇』
大数据分析常用去重算法分析『Bitmap 篇』 mp.weixin.qq.com 去重分析在企业日常分析中的使用频率非常高,如何在大数据场景下快速地进行去重分析一直是一大难点.在近期的 Apache ...
- 大数据计算:如何仅用1.5KB内存为十亿对象计数
大数据计算:如何仅用1.5KB内存为十亿对象计数 Big Data Counting: How To Count A Billion Distinct Objects Using Only 1.5K ...
- Flink去重统计-基于自定义布隆过滤器
一.背景说明 在Flink中对流数据进行去重计算是常有操作,如流量域对独立访客之类的统计,去重思路一般有三个: 基于Hashset来实现去重 数据存在内存,容量小,服务重启会丢失. 使用状态编程Val ...
随机推荐
- 四轴电池ADC监控学习
一.硬件原理 电池供电通过两个分压电阻接地,STM32则在两电阻中间通过ADC检测电池电压.(引脚BAT_DET) 二.ADC通道初始化 //初始化电池检测ADC //开启ADC1的通道8 //Bat ...
- 解决handsontable日期控件汉化的问题
在项目的 node_modules\pikaday目录下打开 pikaday.js 把 i18n: { previousMonth : 'Previous Month', nextMonth : 'N ...
- 经典的MySQL Duplicate entry报错注入
SQL注射取数据的方式有多种: 利用union select查询直接在页面上返回数据,这种最为常见,一个前提是攻击者能够构造闭合的查询. Oracle中利用监听UTL_HTTP.request发起的H ...
- python count()函数
Python 元组 count() 方法用于统计某个元素在元祖,列表,字符串中出现的次数.可选参数为在字符串搜索的开始与结束位置. 参数 sub -- 搜索的子字符串 start -- 字符串开始搜索 ...
- oracle 中和mysql的group_concat有同样作用的写法
所有版本的oracle都可以使用select wm_concat(name) as name from user;但如果是oracle11g,使用select listagg(name, ',') w ...
- ubuntu18.04 点击启动器实现窗口最小化
gsettings set org.gnome.shell.extensions.dash-to-dock click-action 'minimize'
- .NET Core开源组件:后台任务利器之Hangfire 转载 https://www.cnblogs.com/chenug/p/6655636.html
.NET Core开源组件:后台任务利器之Hangfire 一.简述 Hangfire作为一款高人气且容易上手的分布式后台执行服务,支持多种数据库.在.net core的环境中,由Core自带的D ...
- The request with exception: The SSL connection could not be established, see inner exception. requestId 解决方案
DOTNET CORE 部署 Centos7 抛出异常 环境变量如下: .NET Core SDK (reflecting any global.json): Version: 2.2.401 Com ...
- 如何深入理解Java泛型
一.泛型的作用与定义 1.1泛型的作用 使用泛型能写出更加灵活通用的代码泛型的设计主要参照了C++的模板,旨在能让人写出更加通用化,更加灵活的代码.模板/泛型代码,就好像做雕塑时的模板,有了模板,需要 ...
- 16-python基础-字典
1.字典的定义 dictionary(字典)是除列表以外python之中最灵活的数据类型. 字典同样可以存储多个数据. 通常用于存储一个物体的相关信息. 和列表的区别 列表是有序的对象集合 字典是无序 ...