
强化学习策略梯度方法之: REINFORCE 算法(从原理到代码实现)
强化学习策略梯度方法之: REINFORCE 算法 (从原理到代码实现)
2018-04-01 15:15:42
最近在看policy gradient algorithm, 其中一种比较经典的算法当属:REINFORCE 算法,已经广泛的应用于各种计算机视觉任务当中。
【REINFORCE 算法原理推导】
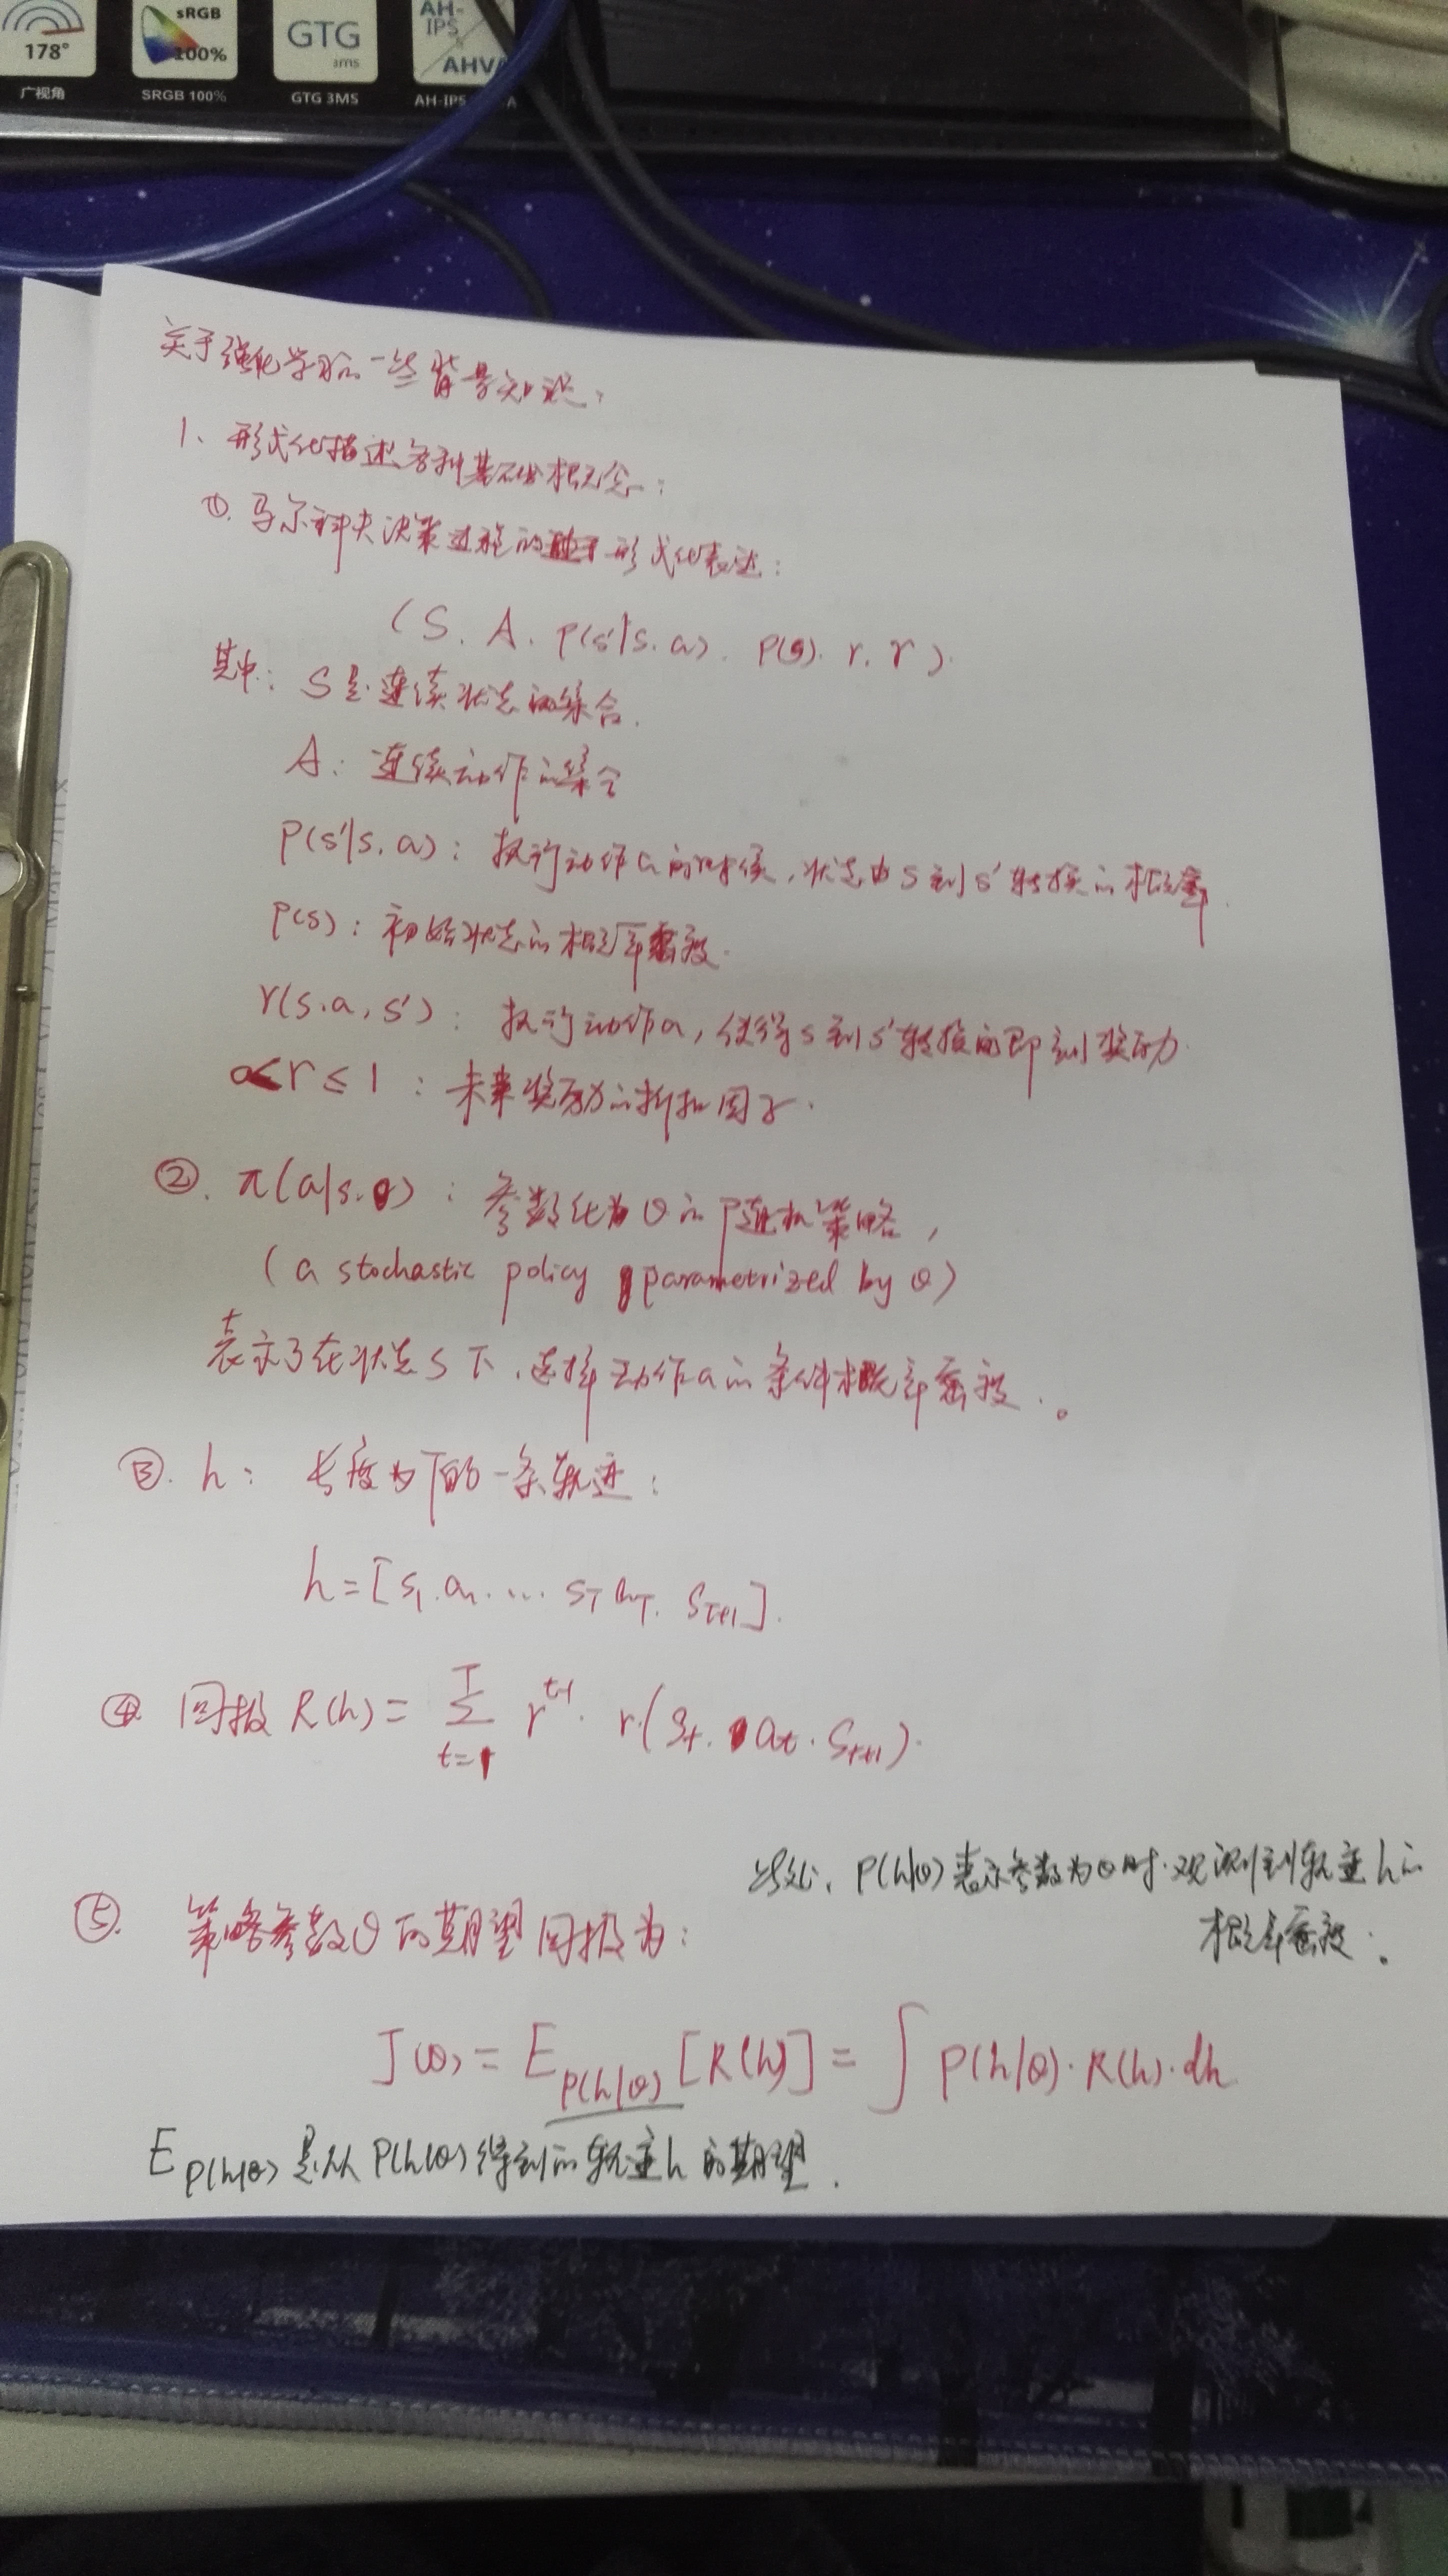
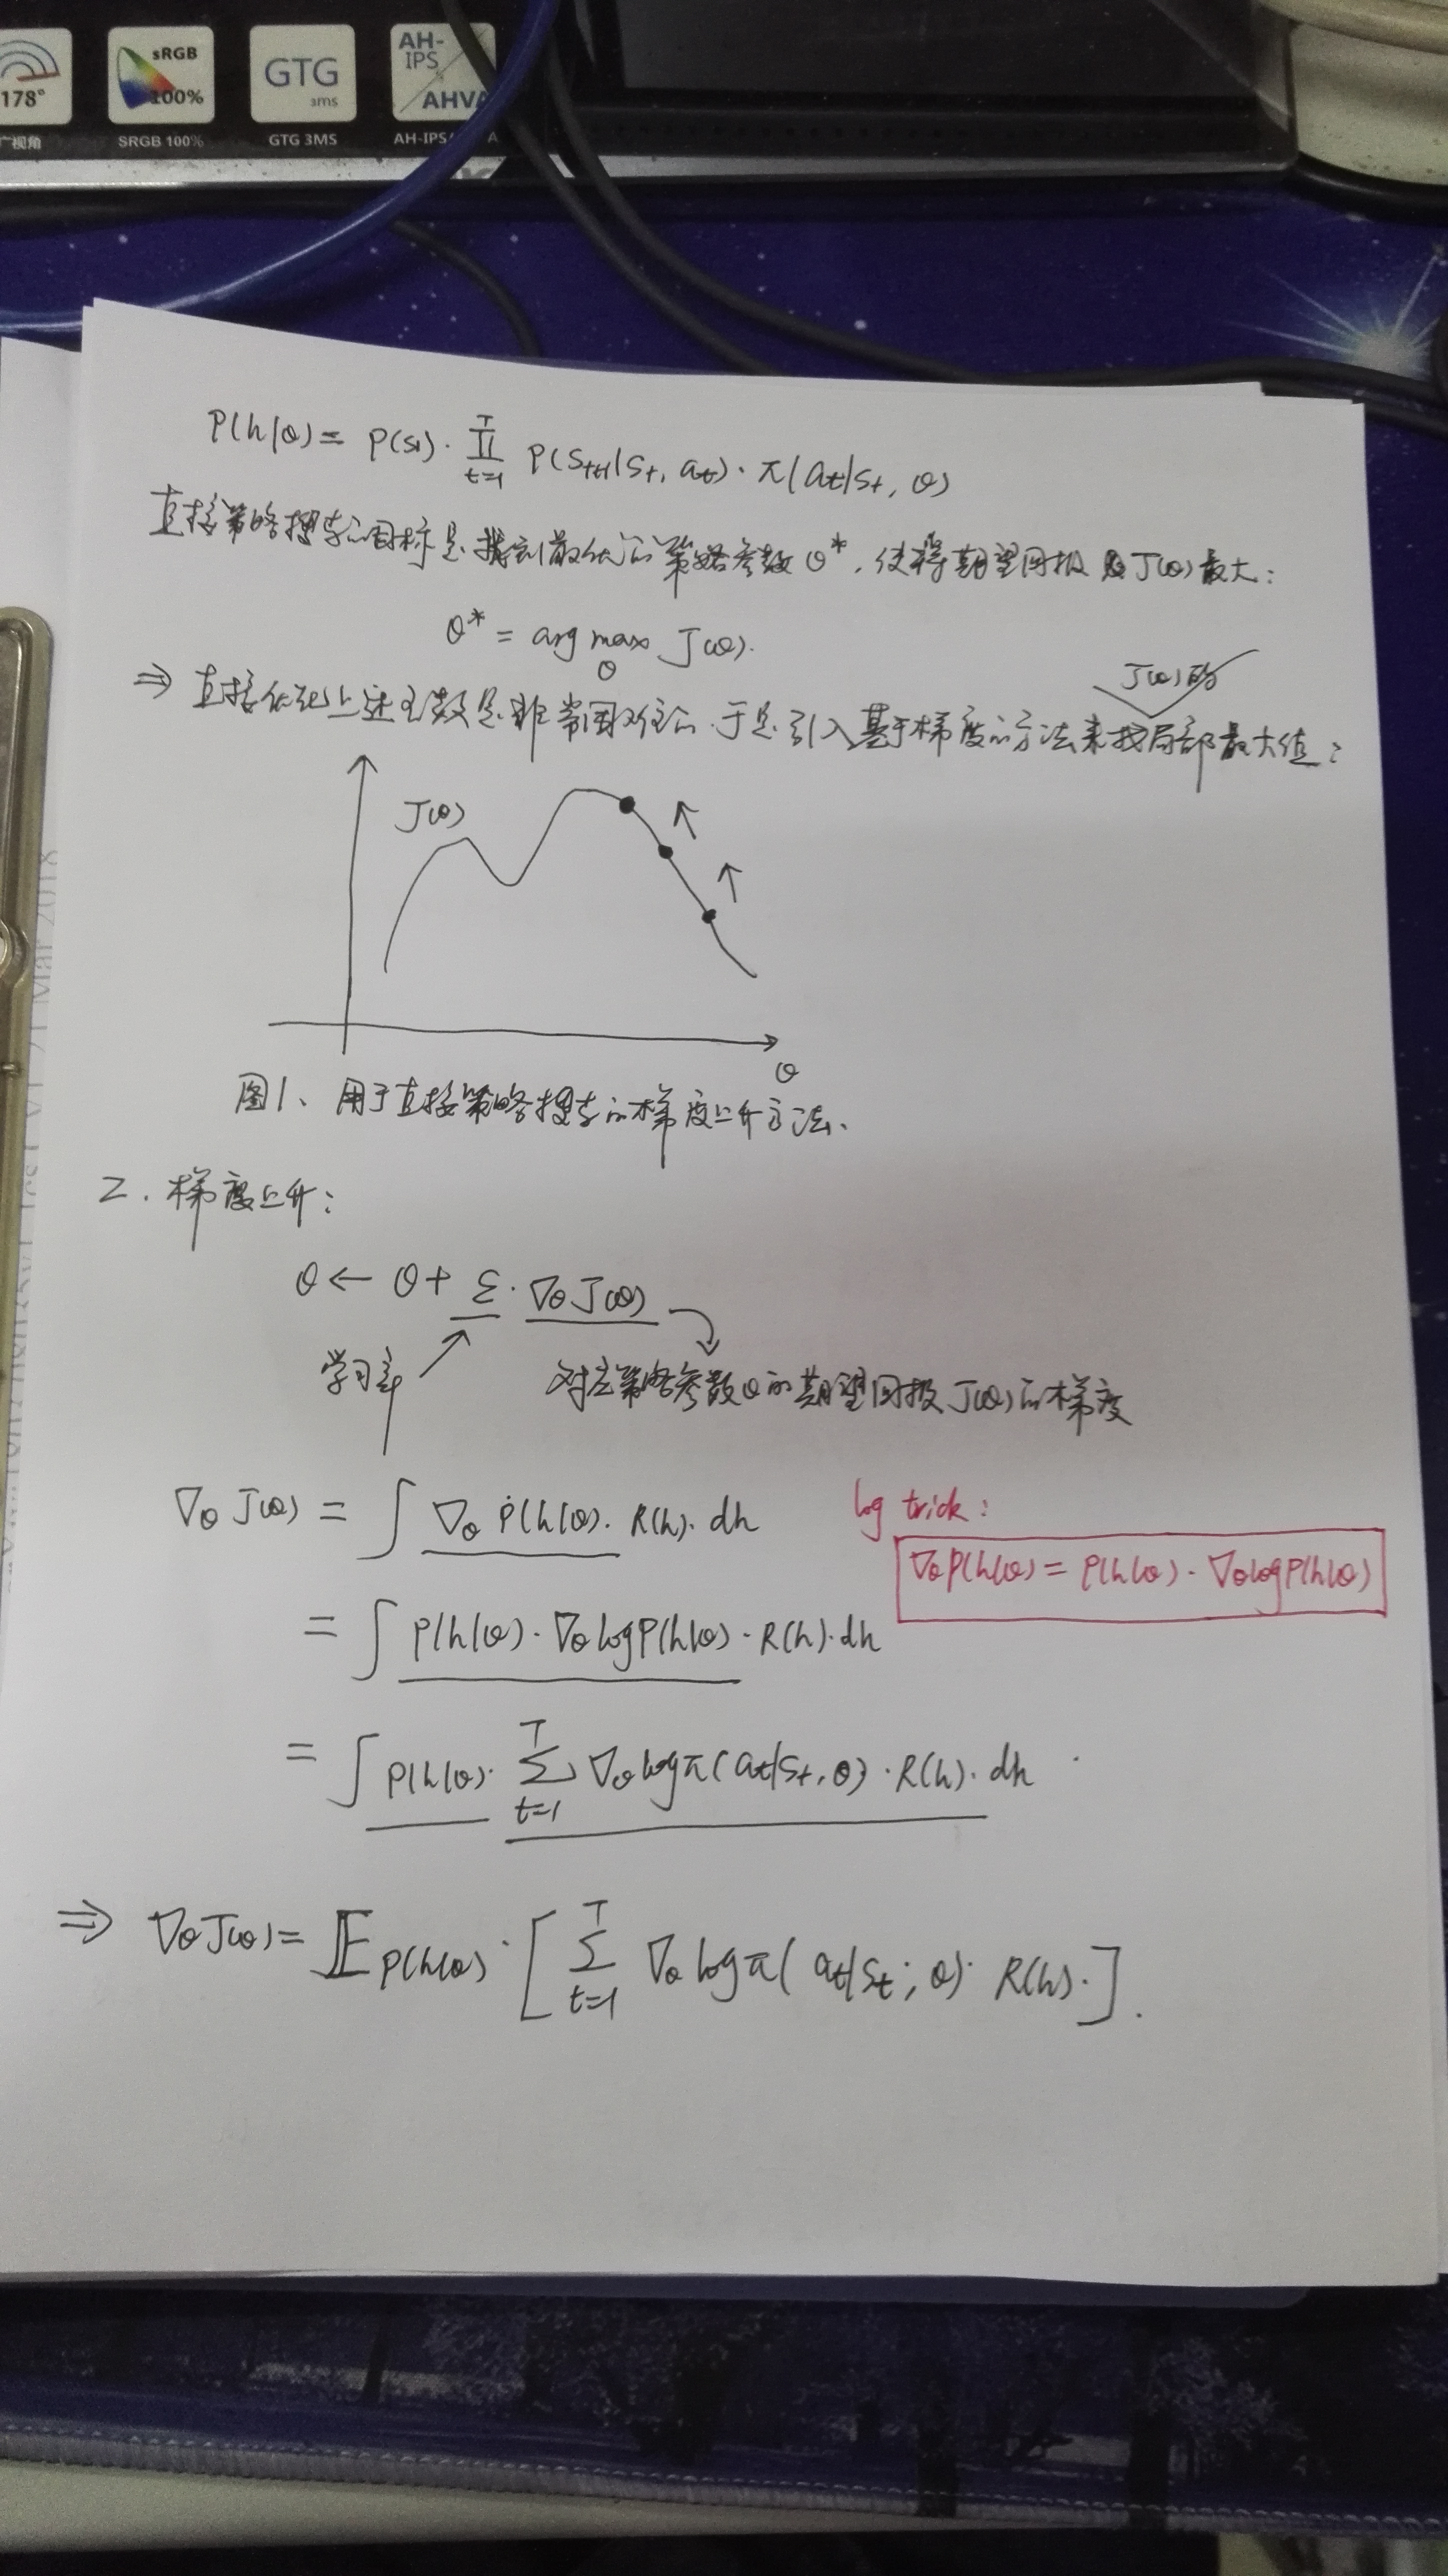
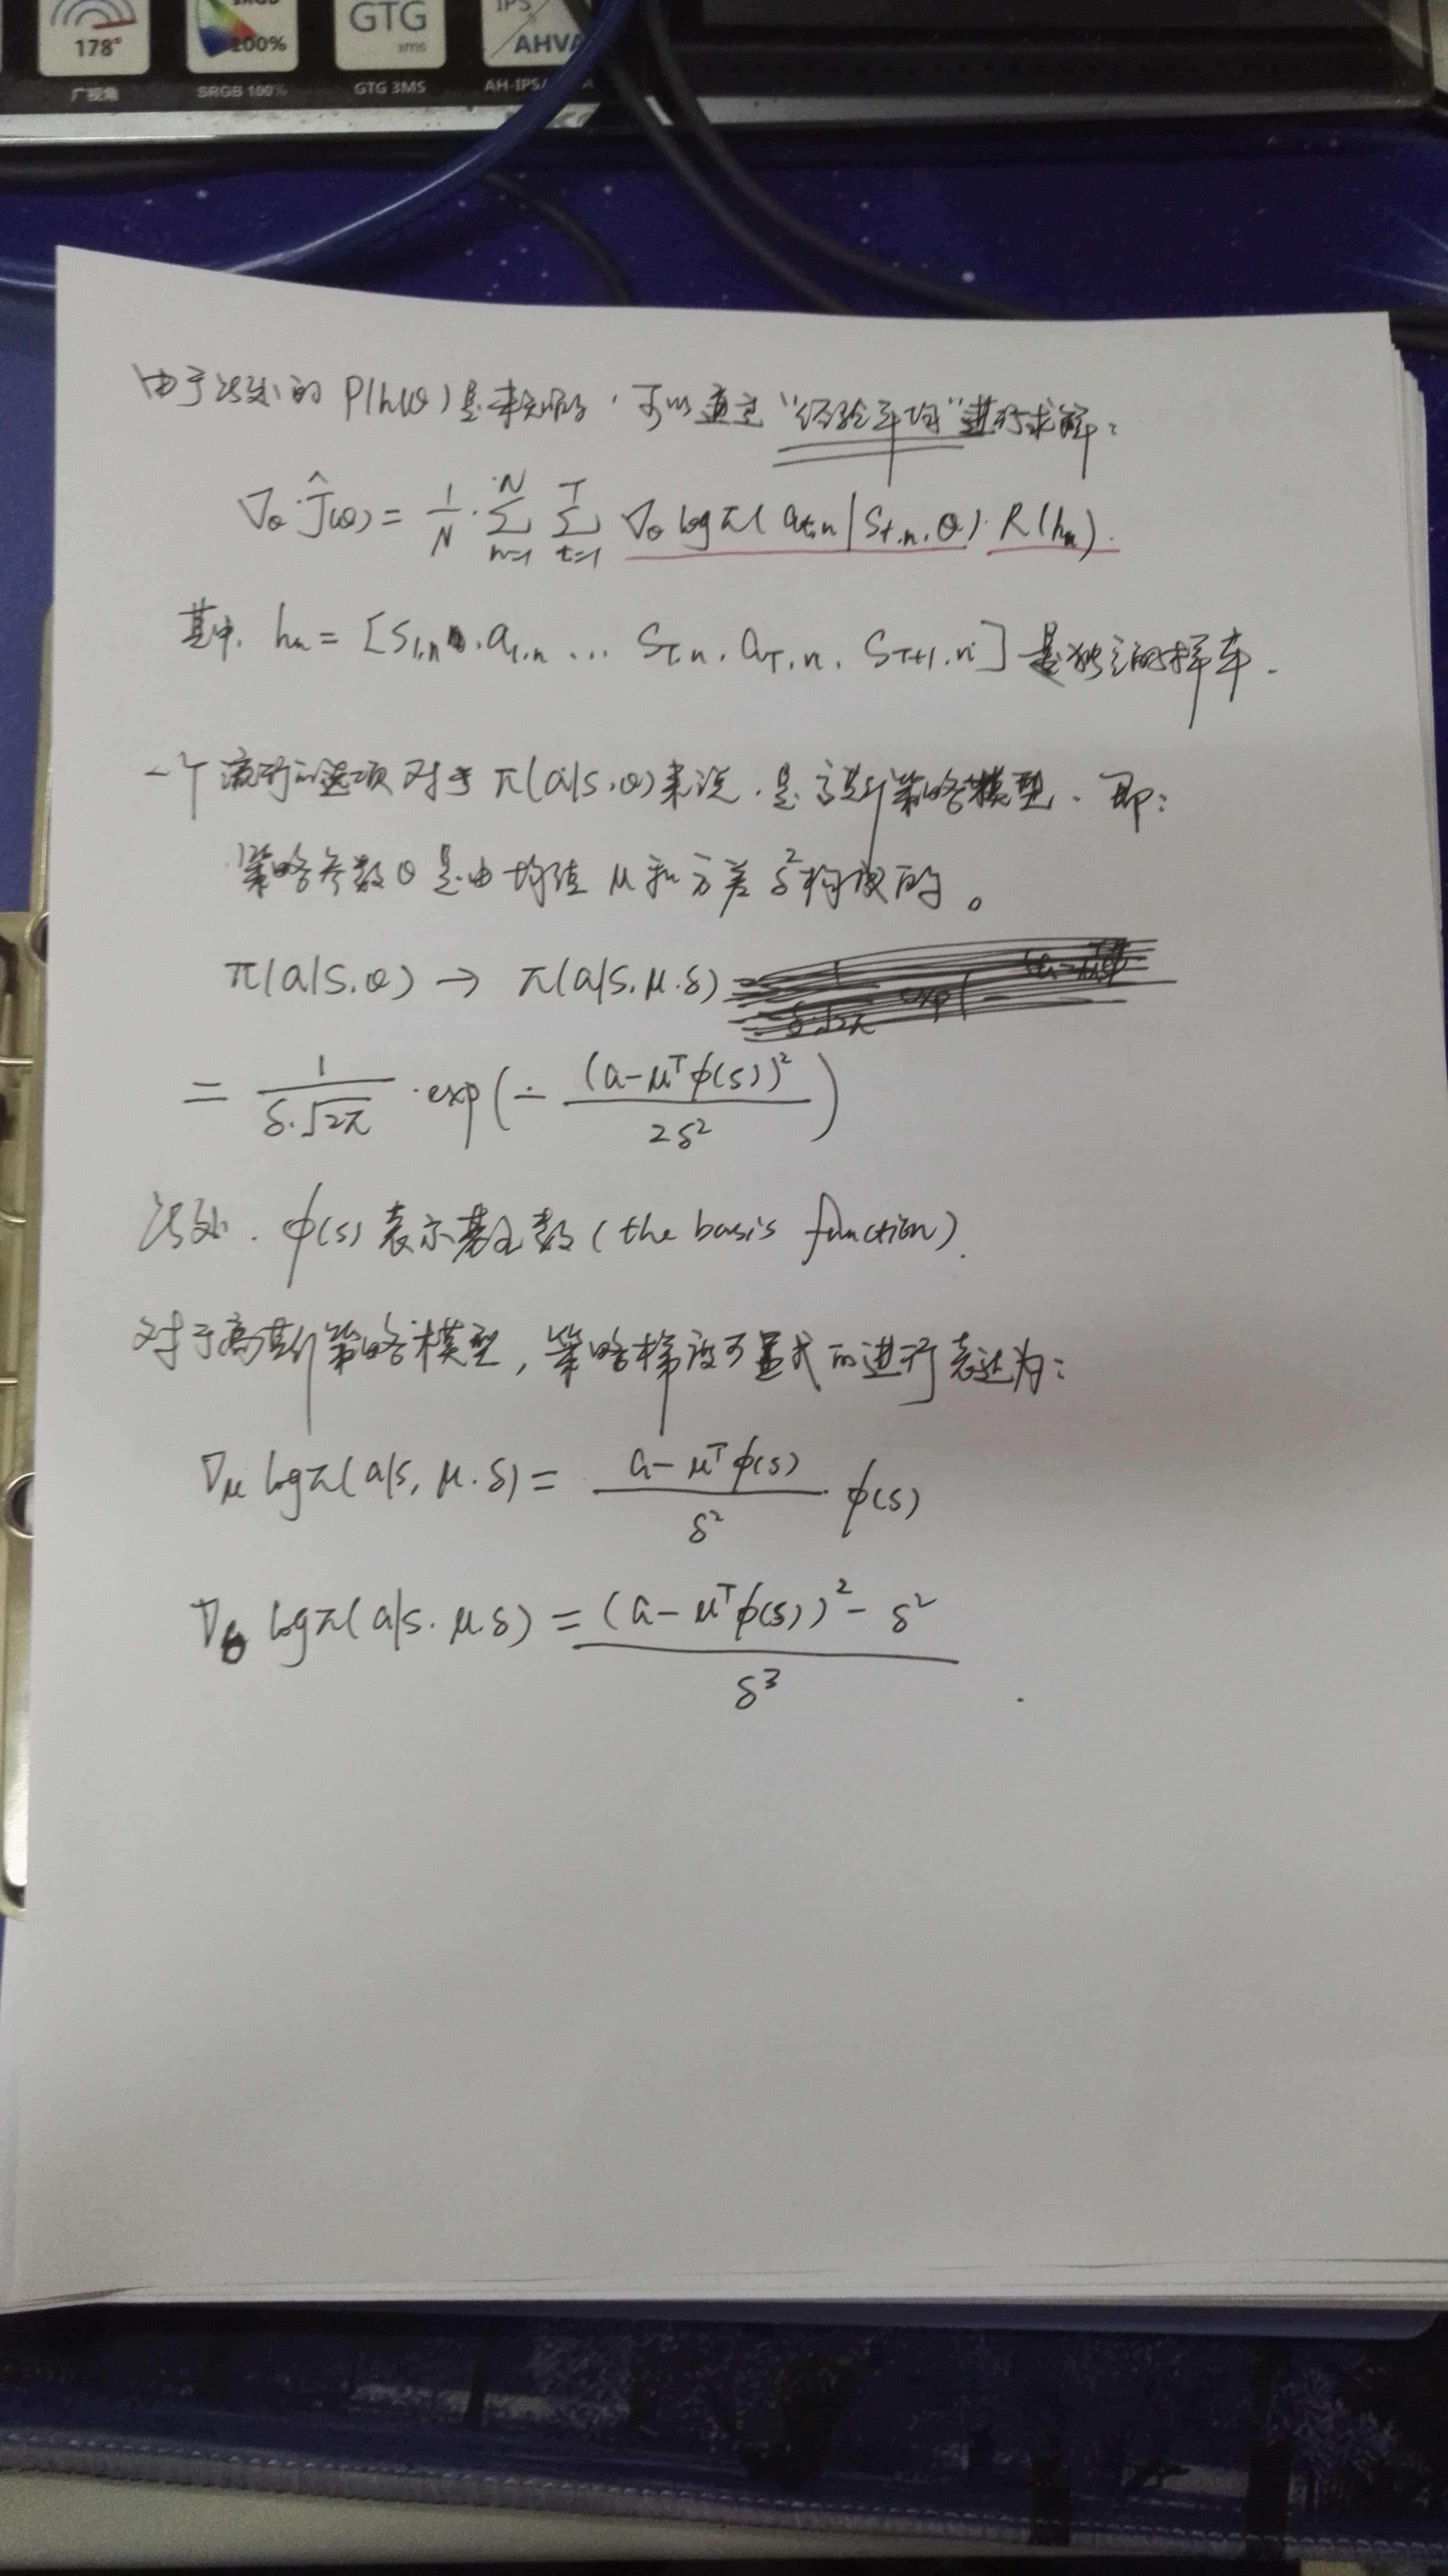
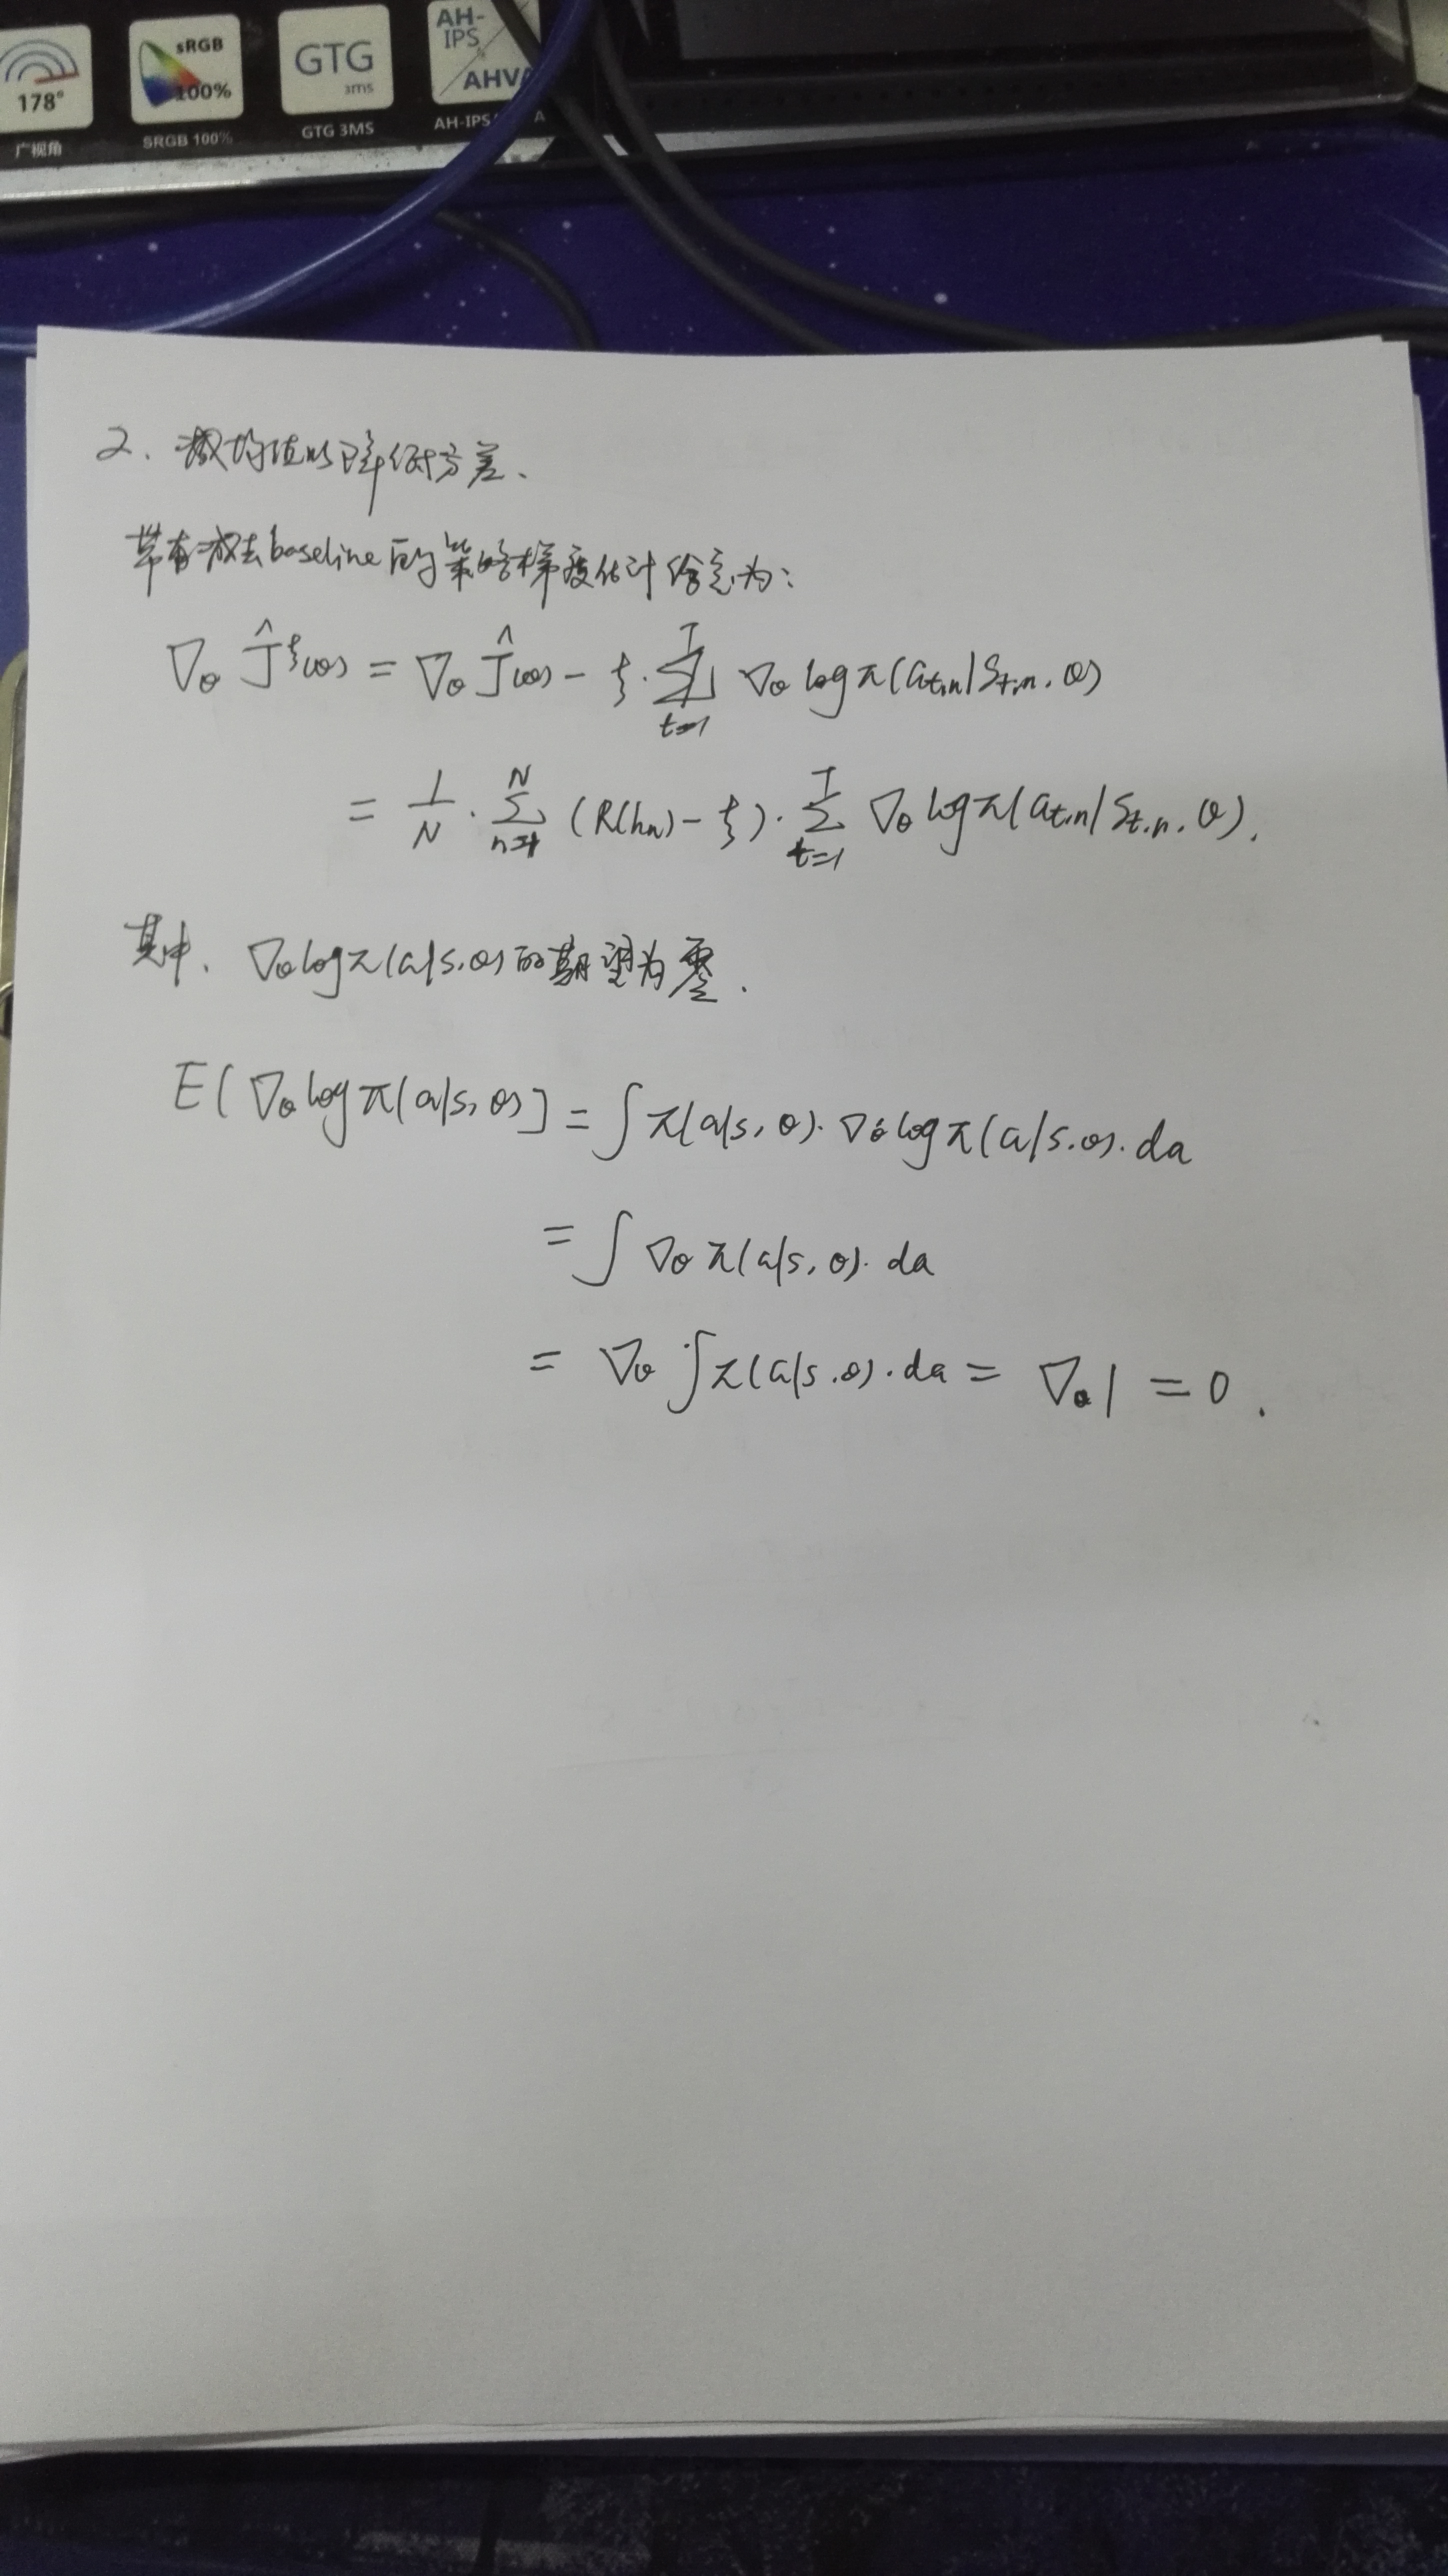
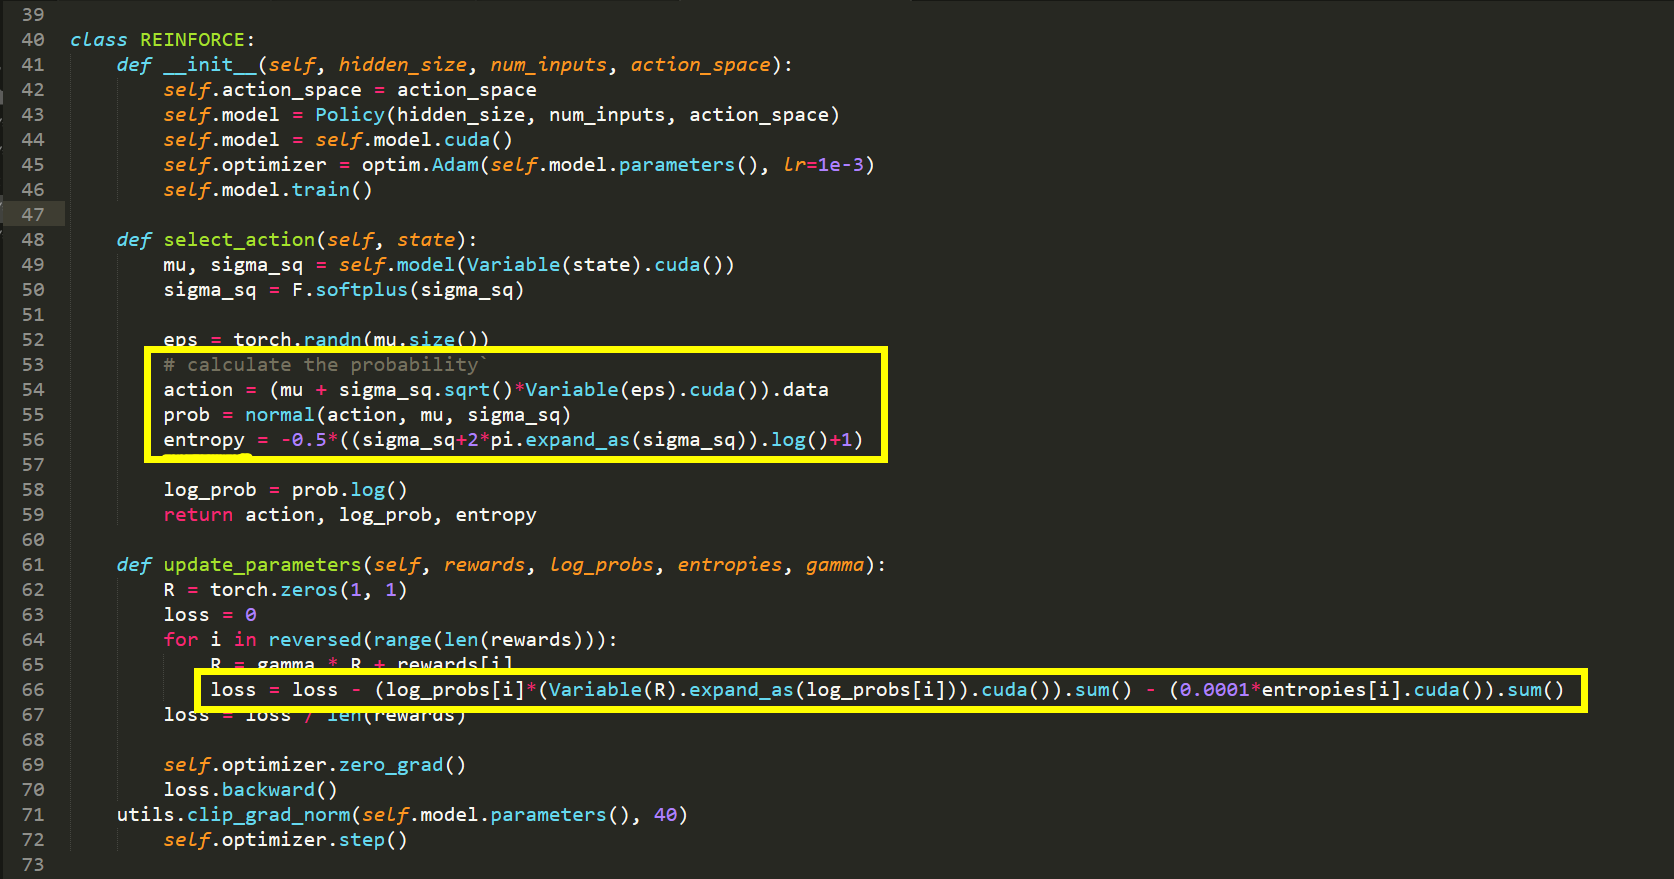
【Pytorch 代码实现】
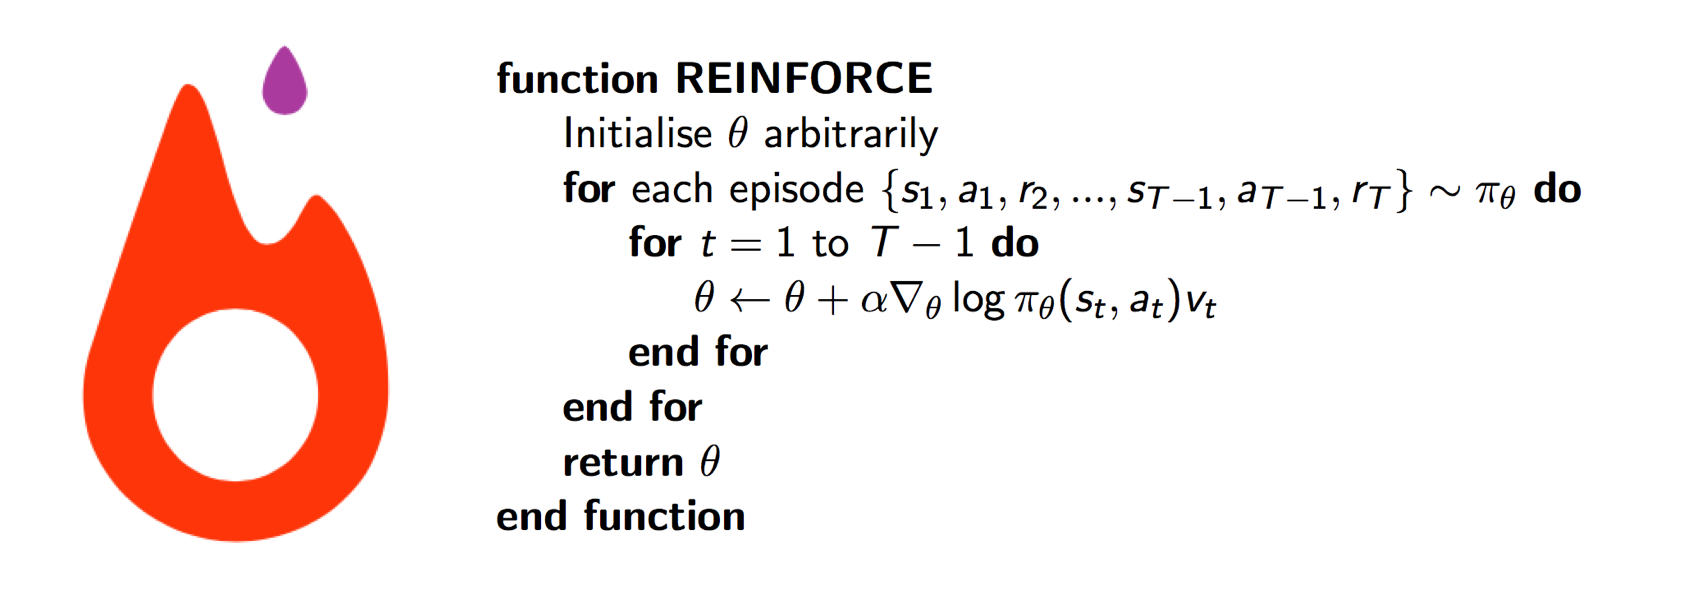
该图像来自于:https://github.com/JamesChuanggg/pytorch-REINFORCE/blob/master/assets/algo.png


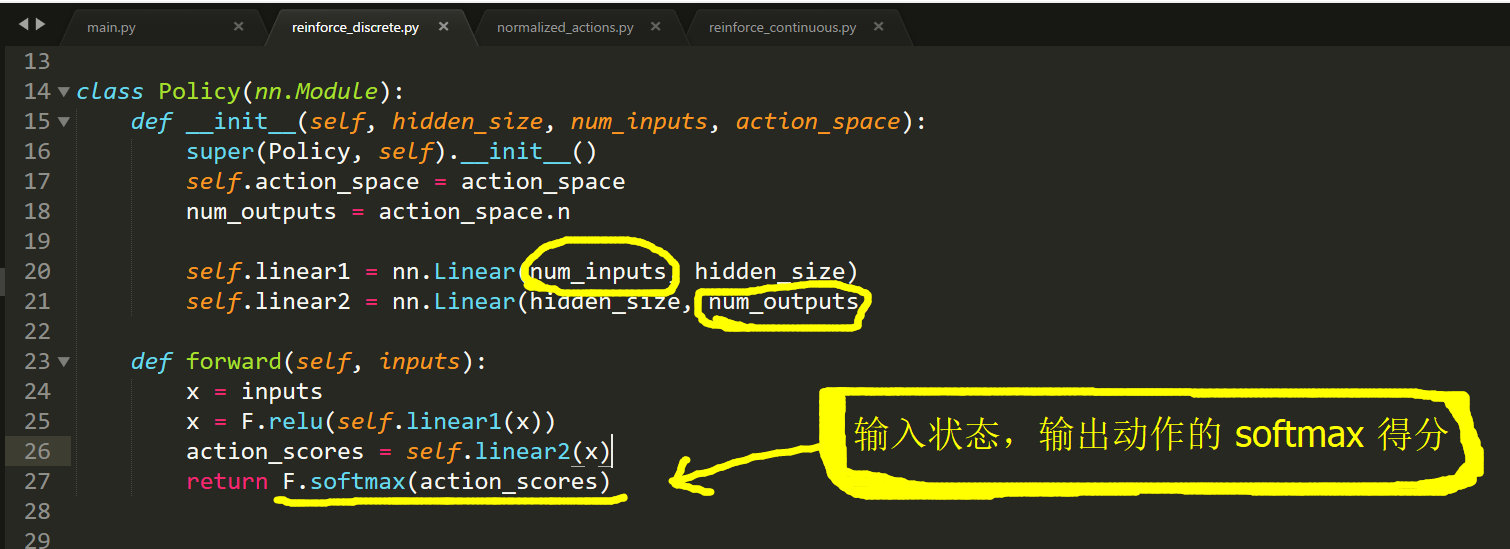
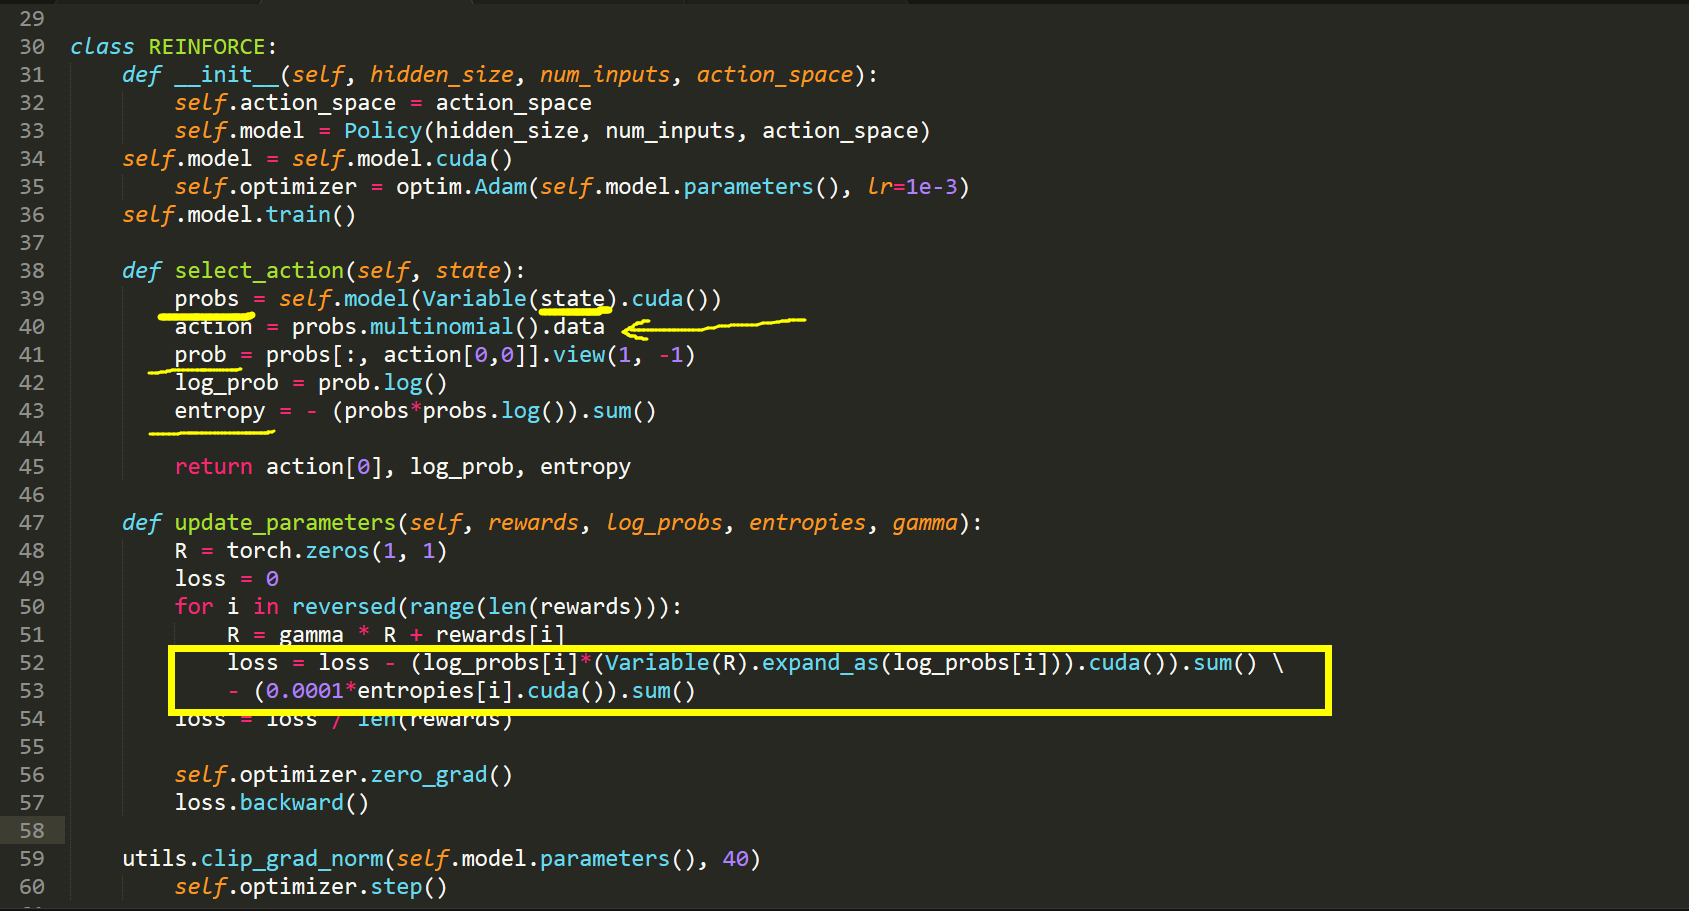
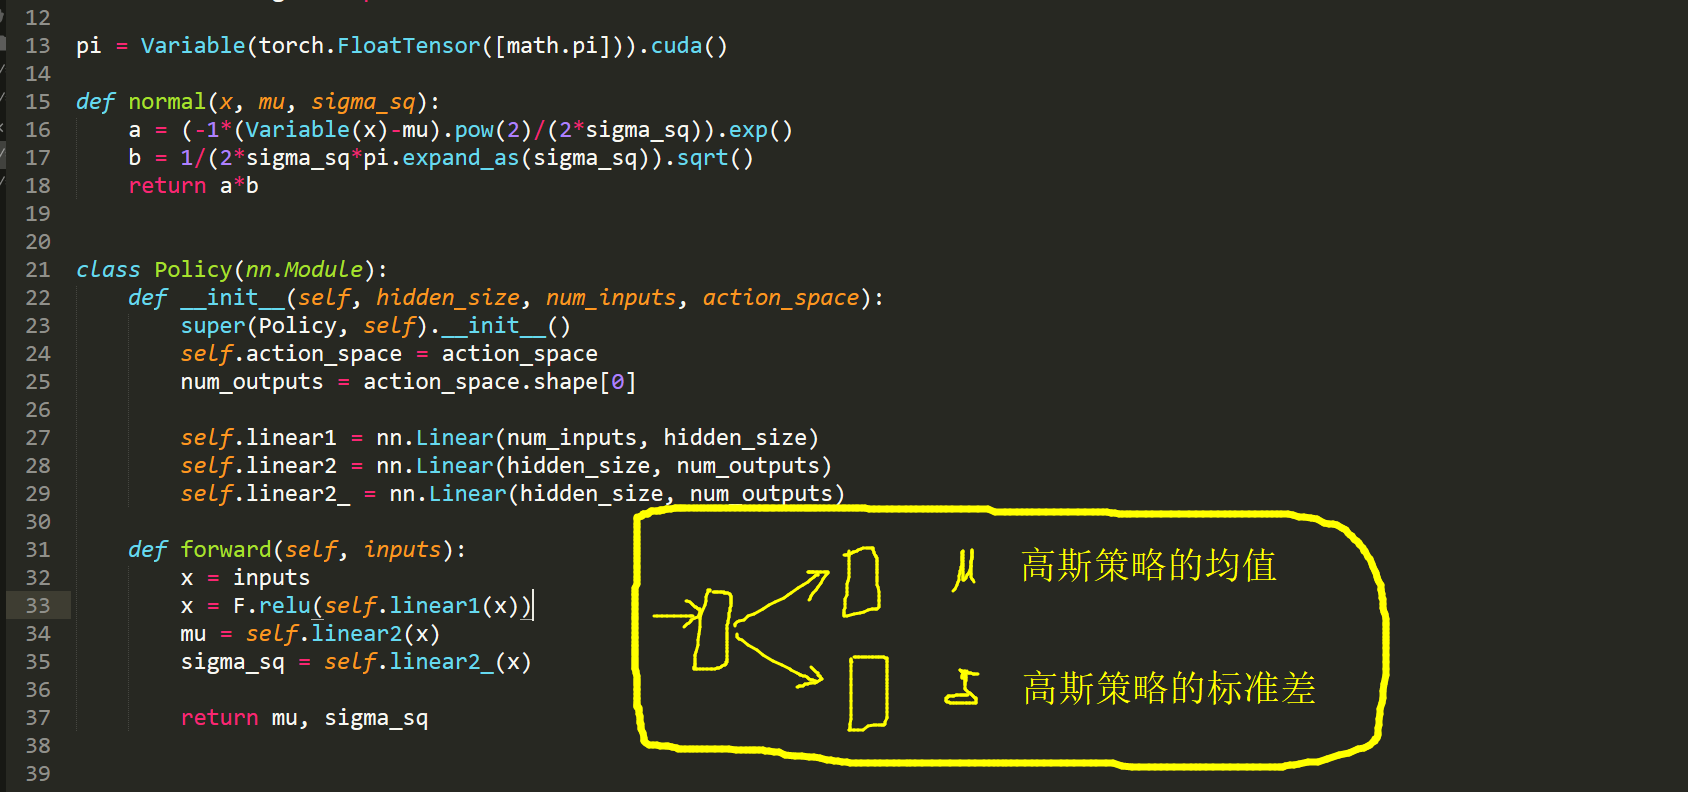
上面函数是 离散情况下的,那么,连续领域是什么情况呢?
-------------------------------------------------------------------------------------------------------------------------------------------------
-------------------------------------------------------------------------------------------------------------------------------------------------
Reference:
1. 参考博文:http://www.tuananhle.co.uk/notes/reinforce.html
2. 参考博文:http://www.scholarpedia.org/article/Policy_gradient_methods
3. 代码实现(Pytorch version)https://github.com/JamesChuanggg/pytorch-REINFORCE
4. REINFORCE 文章链接:http://citeseerx.ist.psu.edu/viewdoc/download?doi=10.1.1.129.8871&rep=rep1&type=pdf
5. 书籍:Statistical_Reinforcement_Learning
强化学习策略梯度方法之: REINFORCE 算法(从原理到代码实现)的更多相关文章
- js学习笔记之排序算法的原理及代码
冒泡排序 比较任何两个相邻的项,如果第一个比第二个大,则交换它们 重复这样的操作,直到排序完成,具体代码如下: let arr = [67,23,11,89,45,76,56,99] function ...
- BP算法从原理到python实现
BP算法从原理到实践 反向传播算法Backpropagation的python实现 觉得有用的话,欢迎一起讨论相互学习~Follow Me 博主接触深度学习已经一段时间,近期在与别人进行讨论时,发现自 ...
- 强化学习(五)—— 策略梯度及reinforce算法
1 概述 在该系列上一篇中介绍的基于价值的深度强化学习方法有它自身的缺点,主要有以下三点: 1)基于价值的强化学习无法很好的处理连续空间的动作问题,或者时高维度的离散动作空间,因为通过价值更新策略时是 ...
- 强化学习读书笔记 - 13 - 策略梯度方法(Policy Gradient Methods)
强化学习读书笔记 - 13 - 策略梯度方法(Policy Gradient Methods) 学习笔记: Reinforcement Learning: An Introduction, Richa ...
- 深度学习课程笔记(十三)深度强化学习 --- 策略梯度方法(Policy Gradient Methods)
深度学习课程笔记(十三)深度强化学习 --- 策略梯度方法(Policy Gradient Methods) 2018-07-17 16:50:12 Reference:https://www.you ...
- DRL之:策略梯度方法 (Policy Gradient Methods)
DRL 教材 Chpater 11 --- 策略梯度方法(Policy Gradient Methods) 前面介绍了很多关于 state or state-action pairs 方面的知识,为了 ...
- 强化学习-MDP(马尔可夫决策过程)算法原理
1. 前言 前面的强化学习基础知识介绍了强化学习中的一些基本元素和整体概念.今天讲解强化学习里面最最基础的MDP(马尔可夫决策过程). 2. MDP定义 MDP是当前强化学习理论推导的基石,通过这套框 ...
- 强化学习中REIINFORCE算法和AC算法在算法理论和实际代码设计中的区别
背景就不介绍了,REINFORCE算法和AC算法是强化学习中基于策略这类的基础算法,这两个算法的算法描述(伪代码)参见Sutton的reinforcement introduction(2nd). A ...
- 蜂窝网络TDOA定位方法的Fang算法研究及仿真纠错
科学论文为我们提供科学方法,在解决实际问题中,能极大提高生产效率.但论文中一些失误则可能让使用者浪费大量时间.自己全部再推导那真不容易,怀疑的成本特别高,通常不会选择这条路.而如果真是它的问题,其它所 ...
随机推荐
- hdu4778 状态压缩
#include <iostream> #include <algorithm> #include <cstdio> #include <vector> ...
- WebAppInitializer类,代替web.xml
package com.ssm.yjblogs.config; import javax.servlet.MultipartConfigElement; import javax.servlet.Se ...
- CS229 - MachineLearning - 12 强化学习笔记
Ng的机器学习课,课程资源:cs229-课件 网易公开课-视频 问题数学模型: 马尔科夫过程五元组{S.a.Psa.γ.R},分别对应 {状态.行为.状态s下做出a行为的概率.常数.回报}. 一 ...
- django的母板和继承
Django模板中只需要记两种特殊符号: {{ }}和 {% %} {{ }}表示变量,在模板渲染的时候替换成值,{% %}表示逻辑相关的操作. 母板 <!DOCTYPE html> & ...
- 编程中的链式调用:Scala示例
编程中的链式调用与Linux Shell 中的管道类似.Linux Shell 中的管道 ,会将管道连接的上一个程序的结果, 传递给管道连接的下一个程序作为参数进行处理,依次串联起N个实用程序形成流水 ...
- python os.path.join()
>>> import os >>> path = '/Users/beazley/Data/data.csv' >>> # Get the las ...
- flask 对URL进行安全验证
对URL进行安全验证 虽然我们已经实现了重定向会上一个页面的功能,但是安全问题不容忽视,鉴于referer和next容易被串篡改的特性,我们需要对这些值进行验证,否则会形成开放重定向漏洞 以URL ...
- 什么是redis,redis简介
redis是一个key-value存储系统.包括string(字符串).list(链表).set(集合).zset(sorted set --有序集合)和hash(哈希类型). 高可用分布式集群 一, ...
- px-pt-dp-rem像素单位的换算问题
px-pt-dp-rem像素单位的换算问题 dp 的意思从 MDPI 到 XXXHDPI 每单位物理尺寸的像素数越来越大.也就是说 mdpi 时 1dp = 1pxxxxhdpi 时 1dp = 4p ...
- 关于mapreducer 读取hbase数据 存入mysql的实现过程
mapreducer编程模型是一种八股文的代码逻辑,就以用户行为分析求流存率的作为例子 1.map端来说:必须继承hadoop规定好的mapper类:在读取hbase数据时,已经有现成的接口 Tabl ...