
第三百三十一节,web爬虫讲解2—Scrapy框架爬虫—Scrapy安装—Scrapy指令
第三百三十一节,web爬虫讲解2—Scrapy框架爬虫—Scrapy安装—Scrapy指令
Scrapy框架安装
1、首先,终端执行命令升级pip: python -m pip install --upgrade pip
2、安装,wheel(建议网络安装) pip install wheel
3、安装,lxml(建议下载安装)
4、安装,Twisted(建议下载安装)
5、安装,Scrapy(建议网络安装) pip install Scrapy
测试Scrapy是否安装成功
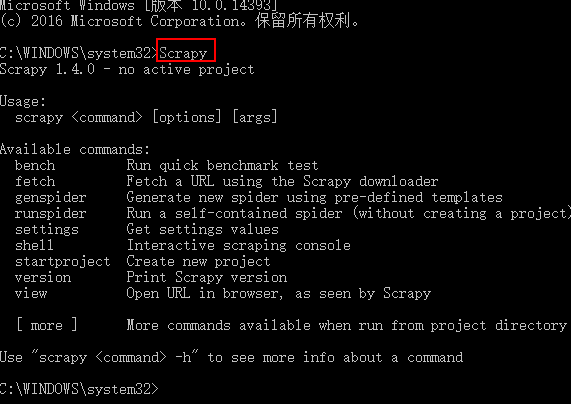
Scrapy框架指令
scrapy -h 查看帮助信息
Available commands:
bench Run quick benchmark test (scrapy bench 硬件测试指令,可以测试当前服务器每分钟最多能爬多少个页面)
fetch Fetch a URL using the Scrapy downloader (scrapy fetch http://www.iqiyi.com/ 获取一个网页html源码)
genspider Generate new spider using pre-defined templates ()
runspider Run a self-contained spider (without creating a project) ()
settings Get settings values ()
shell Interactive scraping console ()
startproject Create new project (cd 进入要创建项目的目录,scrapy startproject 项目名称 ,创建scrapy项目)
version Print Scrapy version ()
view Open URL in browser, as seen by Scrapy ()
创建项目以及项目说明
scrapy startproject adc 创建项目
项目说明
目录结构如下:
├── firstCrawler
│ ├── __init__.py
│ ├── items.py
│ ├── middlewares.py
│ ├── pipelines.py
│ ├── settings.py
│ └── spiders
│ └── __init__.py
└── scrapy.cfg
scrapy.cfg: 项目的配置文件tems.py: 项目中的item文件,用来定义解析对象对应的属性或字段。pipelines.py: 负责处理被spider提取出来的item。典型的处理有清理、 验证及持久化(例如存取到数据库)settings.py: 项目的设置文件.- spiders:实现自定义爬虫的目录
- middlewares.py:Spider中间件是在引擎及Spider之间的特定钩子(specific
hook),处理spider的输入(response)和输出(items及requests)。
其提供了一个简便的机制,通过插入自定义代码来扩展Scrapy功能。

项目指令
项目指令是需要cd进入项目目录执行的指令
scrapy -h 项目指令帮助
Available commands:
bench Run quick benchmark test
check Check spider contracts
crawl Run a spider
edit Edit spider
fetch Fetch a URL using the Scrapy downloader
genspider Generate new spider using pre-defined templates
list List available spiders
parse Parse URL (using its spider) and print the results
runspider Run a self-contained spider (without creating a project)
settings Get settings values
shell Interactive scraping console
startproject Create new project
version Print Scrapy version (scrapy version 查看scrapy版本信息)
view Open URL in browser, as seen by Scrapy (scrapy view http://www.zhimaruanjian.com/ 下载一个网页并打开)
创建爬虫文件
创建爬虫文件是根据scrapy的母版来创建爬虫文件的
scrapy genspider -l 查看scrapy创建爬虫文件可用的母版
Available templates:母版说明
basic 创建基础爬虫文件
crawl 创建自动爬虫文件
csvfeed 创建爬取csv数据爬虫文件
xmlfeed 创建爬取xml数据爬虫文件
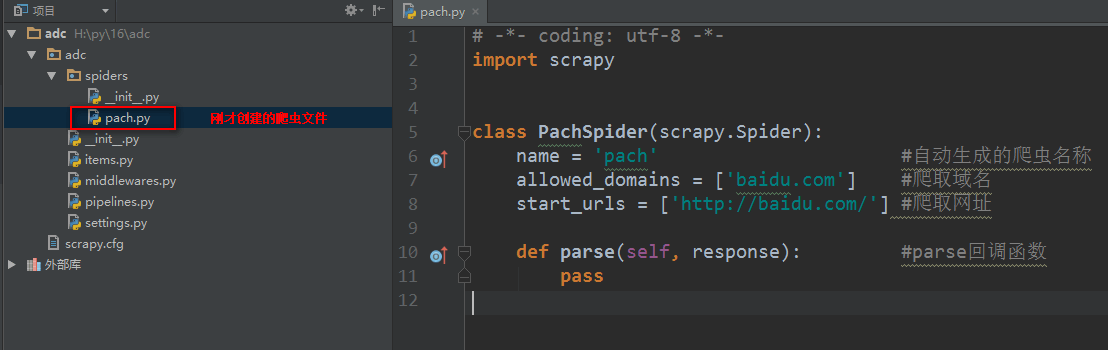
创建一个基础母版爬虫,其他同理
scrapy genspider -t 母版名称 爬虫文件名称 要爬取的域名 创建一个基础母版爬虫,其他同理
如:scrapy genspider -t basic pach baidu.com
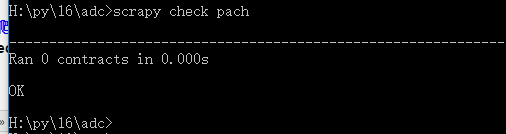
scrapy check 爬虫文件名称 测试一个爬虫文件是否合规
如:scrapy check pach
scrapy crawl 爬虫名称 执行爬虫文件,显示日志 【重点】
scrapy crawl 爬虫名称 --nolog 执行爬虫文件,不显示日志【重点】
第三百三十一节,web爬虫讲解2—Scrapy框架爬虫—Scrapy安装—Scrapy指令的更多相关文章
- 第三百七十一节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)用Django实现我的搜索以及热门搜索
第三百七十一节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)用Django实现我的搜索以及热门 我的搜素简单实现原理我们可以用js来实现,首先用js获取到 ...
- 第三百六十一节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)倒排索引
第三百六十一节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)倒排索引 倒排索引 倒排索引源于实际应用中需要根据属性的值来查找记录.这种索引表中的每一项都包 ...
- 第三百五十一节,Python分布式爬虫打造搜索引擎Scrapy精讲—将selenium操作谷歌浏览器集成到scrapy中
第三百五十一节,Python分布式爬虫打造搜索引擎Scrapy精讲—将selenium操作谷歌浏览器集成到scrapy中 1.爬虫文件 dispatcher.connect()信号分发器,第一个参数信 ...
- 第三百九十一节,Django+Xadmin打造上线标准的在线教育平台—404,403,500页面配置
第三百九十一节,Django+Xadmin打造上线标准的在线教育平台—404,403,500页面配置 路由映射在全局也就是根目录里的urls.py里配置404路由映射 注意:不是写在urlpatter ...
- 第三百八十一节,Django+Xadmin打造上线标准的在线教育平台—xadmin全局配置
第三百八十一节,Django+Xadmin打造上线标准的在线教育平台—xadmin全局配置 1.xadmin主题设置 要使用xadmin主题,需要在一个app下的adminx.py后台注册文件里,写一 ...
- 第三百二十一节,Django框架,发送邮件
第三百二十一节,Django框架,发送邮件 全局配置settings.py EMAIL_BACKEND = 'django.core.mail.backends.smtp.EmailBackend' ...
- 第三百三十七节,web爬虫讲解2—PhantomJS虚拟浏览器+selenium模块操作PhantomJS
第三百三十七节,web爬虫讲解2—PhantomJS虚拟浏览器+selenium模块操作PhantomJS PhantomJS虚拟浏览器 phantomjs 是一个基于js的webkit内核无头浏览器 ...
- 第三百三十六节,web爬虫讲解2—urllib库中使用xpath表达式—BeautifulSoup基础
第三百三十六节,web爬虫讲解2—urllib库中使用xpath表达式—BeautifulSoup基础 在urllib中,我们一样可以使用xpath表达式进行信息提取,此时,你需要首先安装lxml模块 ...
- 第三百三十五节,web爬虫讲解2—Scrapy框架爬虫—豆瓣登录与利用打码接口实现自动识别验证码
第三百三十五节,web爬虫讲解2—Scrapy框架爬虫—豆瓣登录与利用打码接口实现自动识别验证码 打码接口文件 # -*- coding: cp936 -*- import sys import os ...
随机推荐
- CCDictionary
/** * CCDictionary is a class like NSDictionary in Obj-C . * * @note Only the pointer of CCObject or ...
- ASP.NET Core2.0 环境下MVC模式的支付宝PC网站支付接口-沙箱环境开发测试
1.新建.NET Core web项目 2.Controllers-Models-Views 分三个大部分 3.下载安装最新sdk 官方的SDK以及Demo都还是.NET Framework的,根据官 ...
- Android 编程下代码之(QQ消息列表滑动删除)
这份代码写出来有些时候了,一直没共享,现在把它共享给大家.简单列一下代码中你可以学到的知识点: 自定义控件的实现方式: 事件的拦截分发消费机制: QQ会话列表滑动删除原理: 最后附上源码链接:Q ...
- Asp.Net模拟post提交数据方法
方法1: System.Net.WebClient WebClientObj = new System.Net.WebClient(); System.Collections.Specialized. ...
- openfire聊天记录插件
package com.sqj.openfire.chat.logs; import java.io.File; import java.util.Date; import java.util.Lis ...
- Mybatis的mapper注册
既然 MyBatis 的行为已经由上述元素配置完了,我们现在就要定义 SQL 映射语句了.但是首先我们需要告诉 MyBatis 到哪里去找到这些语句. Java 在自动查找这方面没有提供一个很好的方法 ...
- git file mode change
近期在做ffmpeg版本合并时发现,TortoiseGit的Check for Modifications的修改对话框中有未修改的问题,直接导出diff,会有类似下面的输出: compat/plan9 ...
- 2015-2016款Mac安装win10多分区教程,不破坏GUID分区表。
原文:https://bbs.feng.com/read-htm-tid-10895240.html 参考:https://bbs.feng.com/read-htm-tid-9940193.html ...
- Android studio 创建安卓项目hello
Android studio是一个非常好用的软件,只不过在使用的最开始,由于各种问题,会失败,并且新手本身就不懂的情况下,更加的懵逼. 这里我来记录一下我遇到过的一点坑. 首先,Android stu ...
- Aspose.Cells Smart markers 基于模板导出Excel
Aspose.Cells可以预先定义Excel模板,然后填充数据(官方文档:http://www.aspose.com/docs/display/cellsjava/Smart+Markers). 设 ...