
cuda中用cublas库做矩阵乘法
这里矩阵C=A*B,原始文档给的公式是C=alpha*A*B+beta*C,所以这里alpha=1,beta=0。
主要使用cublasSgemm这个函数,这个函数的第二个参数有三种类型,这里CUBLAS_OP_N求出来矩阵结果是按行排列,所以不需要转置了。
如果用CUBLAS_OP_T参数求得的结果是按列排列,做成C形式的矩阵应该还需要转置一下,并且后面跟的参数也不太一样,这个参数我就没再尝试了。
代码如下:
#include "cuda_runtime.h"

#include "cublas_v2.h"

#include <stdio.h>

#include <stdlib.h>

#include <iostream>

#include <ctime>

using namespace std;

int main()

{

    srand(time());

    int M = ;            //矩阵A的行,矩阵C的行

    int N = ;            //矩阵A的列,矩阵B的行

    int K = ;            //矩阵B的列,矩阵C的列

    float *h_A = (float*)malloc(sizeof(float)*M*N);

    float *h_B = (float*)malloc(sizeof(float)*N*K);

    float *h_C = (float*)malloc(sizeof(float)*M*K);

    for (int i = ; i < M*N; i++)

    {

        h_A[i] = rand() % ;

        cout << h_A[i] << "  ";

        if ((i + ) % N == )

            cout << endl;

    }

    cout << endl;

    for (int i = ; i < N*K; i++)

    {

        h_B[i] = rand() % ;

        cout << h_B[i] << "  ";

        if ((i + ) % K == )

            cout << endl;

    }

    cout << endl;

    float *d_A, *d_B, *d_C,*d_CT;

    cudaMalloc((void**)&d_A, sizeof(float)*M*N);

    cudaMalloc((void**)&d_B, sizeof(float)*N*K);

    cudaMalloc((void**)&d_C, sizeof(float)*M*K);

    cudaMemcpy(d_A, h_A, M*N * sizeof(float), cudaMemcpyHostToDevice);

    cudaMemcpy(d_B, h_B, N*K * sizeof(float), cudaMemcpyHostToDevice);

    float alpha = ;

    float beta = ;

    //C=A*B

    cublasHandle_t handle;

    cublasCreate(&handle);

    cublasSgemm(handle,

        CUBLAS_OP_N,

        CUBLAS_OP_N,

        K,                    //矩阵B的列数

        M,                    //矩阵A的行数

        N,                    //矩阵A的列数

        &alpha,

        d_B,

        K,

        d_A,

        N,

        &beta,

        d_C,

        K);

    cudaMemcpy(h_C, d_C, M*K * sizeof(float), cudaMemcpyDeviceToHost);

    for (int i = ; i < M*K; i++)

    {

        cout << h_C[i] << "  ";

        if ((i+)%K==)

            cout << endl;

    }

    cudaFree(d_A);

    cudaFree(d_B);

    cudaFree(d_C);

    free(h_A);

    free(h_B);

    free(h_C);

    return ;

}
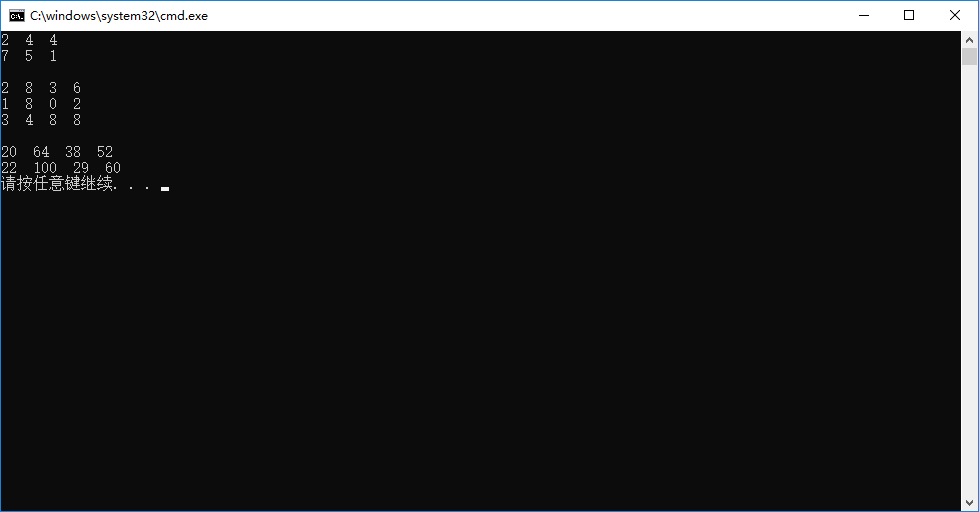
结果:
cuda中用cublas库做矩阵乘法的更多相关文章
- 有关CUBLAS中的矩阵乘法函数
关于cuBLAS库中矩阵乘法相关的函数及其输入输出进行详细讨论. ▶ 涨姿势: ● cuBLAS中能用于运算矩阵乘法的函数有4个,分别是 cublasSgemm(单精度实数).cublasDgemm( ...
- 【神经网络与深度学习】【C/C++】使用blas做矩阵乘法
使用blas做矩阵乘法 #define min(x,y) (((x) < (y)) ? (x) : (y)) #include <stdio.h> #include <st ...
- numpy.loadtxt() 出现codecError_____ Excel 做矩阵乘法
1) 用 numpy读入csv文件是报错 UnicodeDecodeError: 'gbk' codec can't decode byte 0xbf in position 2: illegal m ...
- 使用blas做矩阵乘法
#define min(x,y) (((x) < (y)) ? (x) : (y)) #include <stdio.h> #include <stdlib.h> # ...
- 使用 CUBLAS 库给矩阵运算提速
前言 编写 CUDA 程序真心不是个简单的事儿,调试也不方便,很费时.那么有没有一些现成的 CUDA 库来调用呢? 答案是有的,如 CUBLAS 就是 CUDA 专门用来解决线性代数运算的库. 本文将 ...
- 第四篇:使用 CUBLAS 库给矩阵运算提速
前言 编写 CUDA 程序真心不是个简单的事儿,调试也不方便,很费时.那么有没有一些现成的 CUDA 库来调用呢? 答案是有的,如 CUBLAS 就是 CUDA 专门用来解决线性代数运算的库. 本文将 ...
- POJ 2778 DNA Sequence (AC自动机,矩阵乘法)
题意:给定n个不能出现的模式串,给定一个长度m,要求长度为m的合法串有多少种. 思路:用AC自动机,利用AC自动机上的节点做矩阵乘法. #include<iostream> #includ ...
- poj3233之经典矩阵乘法
Matrix Power Series Time Limit: 3000MS Memory Limit: 131072K Total Submissions: 12346 Accepted: ...
- 51nod 1462 树据结构 | 树链剖分 矩阵乘法
题目链接 51nod 1462 题目描述 给一颗以1为根的树. 每个点有两个权值:vi, ti,一开始全部是零. Q次操作: 读入o, u, d o = 1 对u到根上所有点的vi += d o = ...
随机推荐
- spring jpa : 多条件查询
https://www.cnblogs.com/Donnnnnn/p/6277872.html 方式一: 第一步:EmpAccNumService package com.payease.scford ...
- vector源码1(参考STL源码--侯捷):源码
vector源码1(参考STL源码--侯捷) vector源码2(参考STL源码--侯捷) vector源码(参考STL源码--侯捷)-----空间分配导致迭代器失效 vector源码3(参考STL源 ...
- KahaDB简介
ActiveMQ 5.3以后,出现了KahaDB.她是一个基于文件支持事务的消息存储器,是一个可靠,高性能,可扩展的消息存储器. 她的设计初衷就是使用简单并尽可能的快.KahaDB的索引使用一 ...
- sftp命令不被识别
sftp命令不被识别 原因:C:\Windows\System32文件夹下面没有sftp可执行程序 解决方案:安装openssh,安装完成之后可发现在path系统变量的值中多了openssh的安装目录 ...
- 【转】Intellij IDEA使用总结
原文地址:http://totohust.iteye.com/blog/1035550 1. IDEA内存优化 先看看你机器本身的配置而配置. \IntelliJ IDEA 8\bin\idea.ex ...
- JavaScript -- Window-Name
-----027-Window-Name.html----- <!DOCTYPE html> <html> <head> <meta http-equiv=& ...
- js获取上一个兄弟元素
需要用到的两个属性:previousSbiling和previousElementSibling previousSibling:获取元素的上一个兄弟节点:(既包含元素节点.文本节点.注释节点) pr ...
- 如何测试你给客户端app开的接口
这里介绍一款工具用于测试后台给客户端开的接口. 采用http或者https 采用表单或者json格式 这款工具之前是谷歌浏览器的一款插件,后来出现了各个平台的客户端.非常实用. 名叫postman 官 ...
- java多线程下的所的概念
锁和synchronized关键字 为了同步多线程,Java语言使用监视器(monitors),一种高级的机制来限定某一 时刻只有一个线程执行一段受监视器保护的代码.监视器的行为是通过锁来实现 ...
- Spring Security OAuth2实现单点登录
1.概述 在本教程中,我们将讨论如何使用 Spring Security OAuth 和 Spring Boot 实现 SSO(单点登录). 本示例将使用到三个独立应用 一个授权服务器(中央认证机制) ...