
python识别html主要文本框
在抓取网页的时候只想抓取主要的文本框,例如 csdn 中的主要文本框为下图红色框:
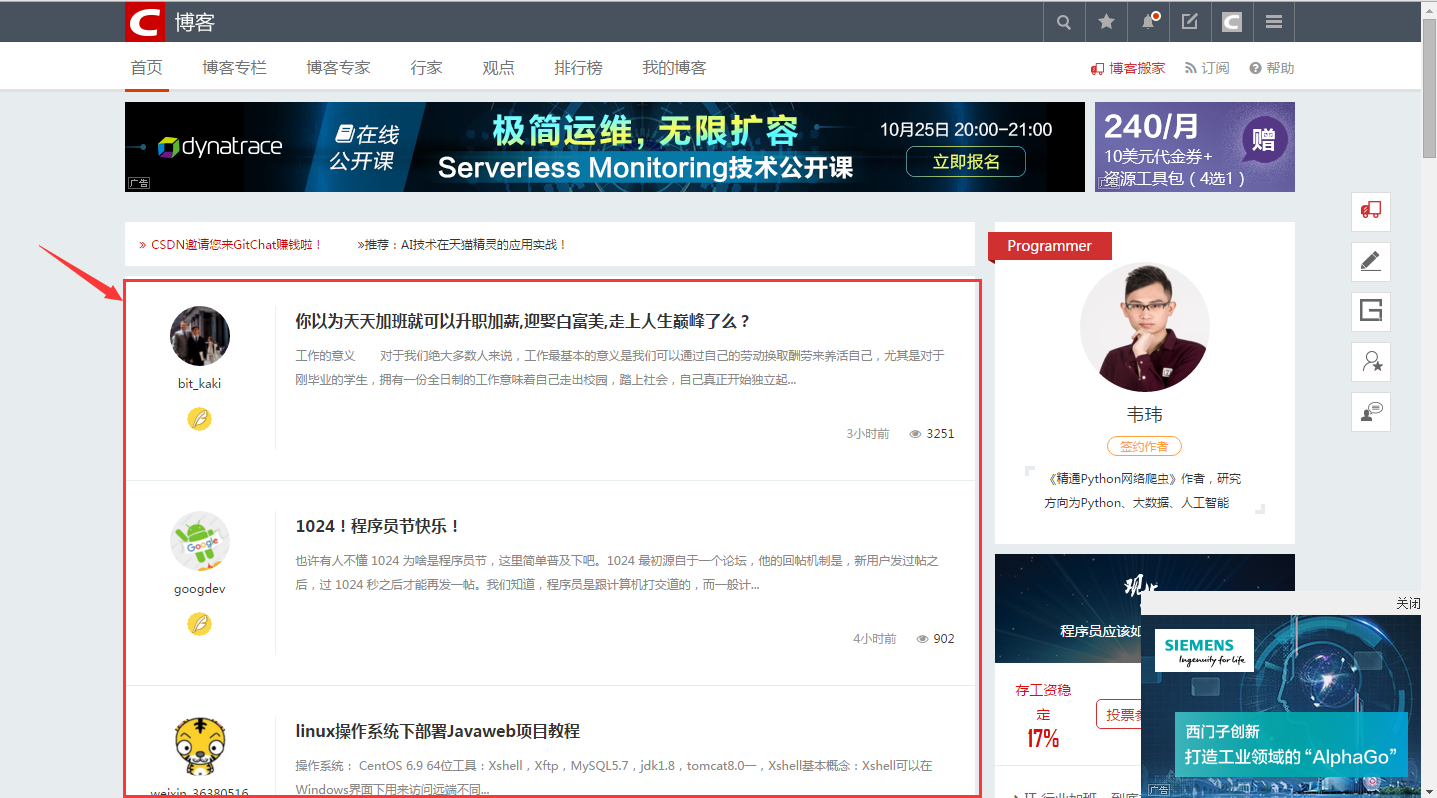
抓取的思想是,利用 bs4 查找所有的 div,用正则筛选出每个 div 里面的中文,找到中文字数最多的 div 就是属于正文的 div 了。定义一个抓取的头部抓取网页内容:
import requests

headers = {

    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/47.0.2526.106 Safari/537.36',

    'Host': 'blog.csdn.net'}

session = requests.session()

def getHtmlByRequests(url):

    headers.update(

        dict(Referer=url, Accept="*/*", Connection="keep-alive"))

    htmlContent = session.get(url=url, headers=headers).content

    return htmlContent.decode("utf-8", "ignore")
识别每个 div 中文字的正则:
import re

# 统计中文字数

def countContent(string):

    pattern = re.compile(u'[\u1100-\uFFFD]+?')

    content = pattern.findall(string)

    return content
遍历每一个 div ,利用正则判断里面中文的字数长度,找到长度最长的 div :
# 分析页面信息

def analyzeHtml(html):

    # 初始化网页

    soup = BeautifulSoup(html, "html.parser")

    part = soup.select('div')

    match = ""

    for paragraph in part:

        content = countContent(str(paragraph))

        if len(content) > len(match):

            match = str(paragraph)

    return match
得到主要的 div 后,提取里面的文字出来:
def main():

    url = "http://blog.csdn.net/"

    html = getHtmlByRequests(url)

    mainContent = analyzeHtml(html)

    soup = BeautifulSoup(mainContent, "html.parser")

    print(soup.select('div')[0].text)
完整的代码如下:
#!/usr/bin/env python

# -*- coding: utf-8 -*-

from bs4 import BeautifulSoup

import requests

import re

headers = {

    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/47.0.2526.106 Safari/537.36',

    'Host': 'blog.csdn.net'}

session = requests.session()

def getHtmlByRequests(url):

    headers.update(

        dict(Referer=url, Accept="*/*", Connection="keep-alive"))

    htmlContent = session.get(url=url, headers=headers).content

    return htmlContent.decode("utf-8", "ignore")

# 统计中文字数

def countContent(string):

    pattern = re.compile(u'[\u1100-\uFFFD]+?')

    content = pattern.findall(string)

    return content

# 分析页面信息

def analyzeHtml(html):

    # 初始化网页

    soup = BeautifulSoup(html, "html.parser")

    part = soup.select('div')

    match = ""

    for paragraph in part:

        content = countContent(str(paragraph))

        if len(content) > len(match):

            match = str(paragraph)

    return match

def main():

    url = "http://blog.csdn.net/"

    html = getHtmlByRequests(url)

    mainContent = analyzeHtml(html)

    soup = BeautifulSoup(mainContent, "html.parser")

    print(soup.select('div')[0].text)

if __name__ == '__main__':

    main()
python识别html主要文本框的更多相关文章
- python开发_tkinter_获取文本框内容_给文本框添加键盘输入事件
在之前的blog中有提到python的tkinter中的菜单操作 python开发_tkinter_窗口控件_自己制作的Python IDEL_博主推荐 python开发_tkinter_窗口控件_自 ...
- python tkinter-按钮.标签.文本框、输入框
按钮 无功能按钮 Button的text属性显示按钮上的文本 tkinter.Button(form, text='hello button').pack() 无论怎么变幻窗体大小,永远都在窗体的最上 ...
- python selenium无法清除文本框内容问题
正常是我们在清除文本框内容的时候,都会使用 clear() 函数进行清除,但是有时候会出现,清除完成后再点击查询时,文本框的内容会再次自动填充,这个时候我们可以选择以下方式: #清空查询条件drive ...
- (2)python tkinter-按钮.标签.文本框、输入框
按钮 无功能按钮 Button的text属性显示按钮上的文本 tkinter.Button(form, text='hello button').pack() 无论怎么变幻窗体大小,永远都在窗体的最上 ...
- Selenium示例集锦--常见元素识别方法、下拉框、文本域及富文本框、鼠标操作、一组元素定位、弹窗、多窗口处理、JS、frame、文件上传和下载
元素定位及其他操作 0.常见的识别元素的方法是什么? driver.find_element_by_id() driver.find_element_by_name() driver.find_ele ...
- wxpython 支持python语法高亮的自定义文本框控件的代码
在研发闲暇时间,把开发过程中比较重要的一些代码做个珍藏,下面的代码内容是关于wxpython 支持python语法高亮的自定义文本框控件的代码,应该是对大家也有用. import keywordimp ...
- Python Tkinter Entry(文本框)
Python学习记录--关于Tkinter Entry(文本框)的选项.方法说明,以及一些示例. 属性(Options) background(bg) borderwidth(bd) cursor e ...
- python webdriver api-操作富文本框
操作富文本框-就是邮件正文部分,可以选字体啥的 第一种方式: 一般都是在iframe里,要切进去,一般是”html/body”,编辑之后,再切出来,然后再send_keys就完事儿 #encoding ...
- Python+selenium之获取文本值和下拉框选择数据
Python+selenium之获取文本值和下拉框选择数据 一.结合实例进行描述 1. 实例如下所示: #新增标签操作 def func_labels(self): self.driver.find_ ...
随机推荐
- 201521123005《Java程序设计》第十三周学习总结
1. 本周学习总结 1.网络基本概念 2.网络常用命令 ipconfig 查看网络配置信息,如ip地址 ping 测试网络是否连通 telnet 远程登录 ftp 登陆ftp Fport (xp下)查 ...
- 201521123057 《Java程序设计》第10周学习总结
1. 本周学习总结 1.1 以你喜欢的方式(思维导图或其他)归纳总结异常与多线程相关内容. 2. 书面作业 本次PTA作业题集异常.多线程 1.finally 题目4-2 1.1 截图你的提交结果(出 ...
- 201521123110《Java程序与设计》第13周学习总结
1. 本周学习总结 2. 书面作业 1. 网络基础 1.1 比较ping www.baidu.com与ping cec.jmu.edu.cn,分析返回结果有何不同?为什么会有这样的不同? 时间数据不同 ...
- webservice第三篇【接口开发webservice、CXF框架使用、IDEA下使用webservice、小例子】
实现接口的webservice 服务端 import javax.jws.WebService; /**面向接口的webservice发布方式 * * */ @WebService public in ...
- Servlet第四篇【request对象常用方法、应用】
什么是HttpServletRequest HttpServletRequest**对象代表客户端的请求,当客户端通过HTTP协议访问服务器时,**HTTP请求头中的所有信息都封装在这个对象中,开发人 ...
- python写的一段分页的代码
代码: from django.utils.safestring import mark_safe class Paginator(object): def __init__(self,current ...
- 解决在Ubuntu终端下使用cURL获取GBK格式的页面出现乱码问题
问题描述 在Ubuntu下使用终端使用cURL去拿一个GBK的页面,发现返回来的内容里面中文都是乱码 解决方法 通过iconv来处理乱码拿到的内容,进行转码,示例如下: $curl http://ww ...
- Flask-WTF 配置、验证及日志P4
参数配置 参数 说明 WTF_CSRF_ENABLED 设置为False以禁用所有CSRF保护 WTF_CSRF_CHECK_DEFAULT 使用CSRF保护扩展时,这可以控制每个视图是否受到默认保护 ...
- crypto加密
/* hash.js */ var crypto = require('crypto'); module.exports = function(){ this.encode = fu ...
- GCD之Apply
dispatch_apply函数是dispatch_sync函数和dispatch_group的结合体.该函数将按指定的次数将指定的block追加到指定的dispatch queue中,并等待全部处理 ...