
记一次kafka客户端NOT_COORDINATOR_FOR_GROUP处理过程
转发请注明原创地址:https://www.cnblogs.com/dongxiao-yang/p/10602799.html
某日晚高峰忽然集群某个大流量业务收到lag报警,查看客户端日志发现reblance一直无法成功,日志如下
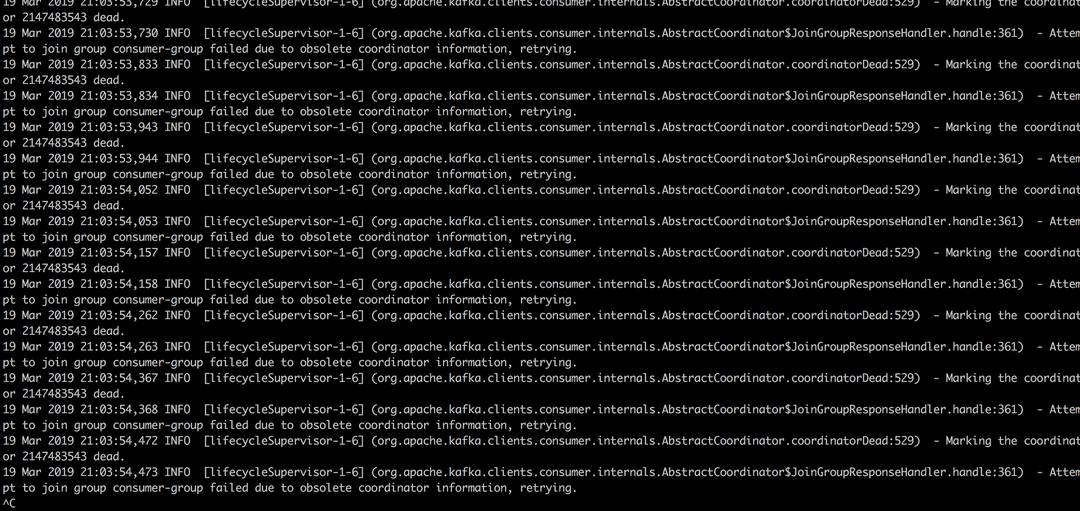
根据客户端日志显示consumer在尝试joingroup的过程中收到了服务端COORDINATOR状态不正常的信息,怀疑是服务端负责这个consumer-group的broker在coordinator元信息管理上出现了问题。
于是跑到对应的节点上看一下server日志,发现在一台刚才有过重启的服务节点上产生如下日志
Failed to append 363 tombstones to __consumer_offsets-38 for expired/deleted offsets and/or metadata for group consumer-group. (kafka.coordinator.GroupMetadataManager)
org.apache.kafka.common.errors.NotLeaderForPartitionException: Leader not local for partition __consumer_offsets-38 on broker 。
怀疑是这个服务重启的过程中__consumer_offset分区有部分数据或者文件有异常导致coordinator无法提供服务导致,停掉有问题节点后发现客户端reblance很快就成功了,于是怀疑问题节点产生了坏文件,后续删除对应分区可以重启成功服务,但是对应group的业务又开始报错
20 Mar 2019 15:31:32,000 INFO [PollableSourceRunner-KafkaSource-bl_app_event_detail_source] (org.apache.kafka.clients.consumer.internals.ConsumerCoordinator$OffsetCommitResponseHandler.handle:542) - Offset commit for group consumer-group failed due to NOT_COORDINATOR_FOR_GROUP, will find new coordinator and retry
20 Mar 2019 15:31:32,001 INFO [PollableSourceRunner-KafkaSource-bl_app_event_detail_source] (org.apache.kafka.clients.consumer.internals.AbstractCoordinator.coordinatorDead:529) - Marking the coordinator 2147483543 dead.
kafka 自从0.9以来摒弃了consumer把offset存在zk的做法而是都存到了__consumer_offsets这个系统topic里面,同时consumer端的reblance都是依靠server端的coordinator负责调度协调。至于每个group怎么选择对应broker节点是根据下面这个简单的hashcode对__consumer_offsets分区数取模的算法得出来的,
def partitionFor(groupId: String): Int = Utils.abs(groupId.hashCode) % groupMetadataTopicPartitionCount
所以看上去是重启节点拉起来后客户端发现对应的offset分区leader又活了,但是活过来的leader却告知客户端NOT_COORDINATOR_FOR_GROUP这个矛盾。但是明明有问题的offset文件已经被手动删除掉了,重新拉副本也成功了,为什么还是会有join group不成功的现象呢。
继续查看问题节点,发现问题节点在Loading group metadata for之类的日志的时候一直没有输出对应的问题group相关日志,初步判断broker重启过程中load group信息的时效出了问题。
  def onLeadershipChange(updatedLeaders: Iterable[Partition], updatedFollowers: Iterable[Partition]) {

      // for each new leader or follower, call coordinator to handle consumer group migration.

      // this callback is invoked under the replica state change lock to ensure proper order of

      // leadership changes

      updatedLeaders.foreach { partition =>

        if (partition.topic == GROUP_METADATA_TOPIC_NAME)

          groupCoordinator.handleGroupImmigration(partition.partitionId)

        else if (partition.topic == TRANSACTION_STATE_TOPIC_NAME)

          txnCoordinator.handleTxnImmigration(partition.partitionId, partition.getLeaderEpoch)

      }
如上述代码所示,kafka在offset分区重新被选举为leader的时候才会去加载对应的group信息,而且所有新leader是foreach单线程循环,如果其中有一个慢的剩下的group都会受到影响。查看问题节点果然除了被删掉的offset分区还有一个分区offset历史文件很多,多到500G的体量,这和offset这种只保存最新数据的场景明显是不符合的,这个大小会导致服务端加载offset信息长到无法接受的程度。
为了尽快回复offset元信息,把问题节点的offset partition全都重新分配到其他节点,在重分配的过程中发现新的副本会不断的删除同步过来的过期数据最后结束后整个分区的大小只有几十M,于是坚定了原来分区大小不正常的判断 。对于__consumer_offsets这种compact策略的topic,kafka内部是有一个专门的logcleaner线程负责日志的合并,但是刚开始出问题的节点经过了几次重启,原始的现场早已不存在,于是把整个集群每个服务挨个查了一遍,果然在另一台看似正常的机器上同样发现了一个很大的offset分区,jstack了一下,发现kafka-log-cleaner-thread这个线程已经没了!重启该服务后发现问题分区的日志也开始正常删除。可惜的是由于服务日志只保留了最近7天的,kafka-log-cleaner-thread的错误日志已经找不到了,这个有待后续复现确认。
回顾了一下处理问题过程中出现的其他现象,其实都是有提示的,像是关掉问题节点的时候server日志会报
WARN Map failed (kafka.utils.CoreUtils$)
java.io.IOException: Map failed
at sun.nio.ch.FileChannelImpl.map(FileChannelImpl.java:940)
at kafka.log.AbstractIndex$$anonfun$resize$1.apply(AbstractIndex.scala:111)
at kafka.log.AbstractIndex$$anonfun$resize$1.apply(AbstractIndex.scala:101)
以及kafka jvm第一次崩掉的hs_err_pid日志会提示内存不足
Native memory allocation (mmap) failed to map 65536 bytes for committing reserved memory
由于kafka使用的mmap方式映射了数据文件以及索引,这个mmap failed就已经提示了文件过多。
结论:kafka的offset数据每个group会根据hash取模的方式发到一个固定的_consumer_offsets分区中,_consumer_offsets分区的leader负责对应groupid的coordinator服务,_consumer_offsets
的删除是由kafka-log-cleaner-thread执行的,这个线程个数默认是1,如果线程崩掉了offset历史分区文件会一直无法删除,导致jvm崩掉并且服务恢复的时候group元信息长时间的无法加载导致reblacne报错。
记一次kafka客户端NOT_COORDINATOR_FOR_GROUP处理过程的更多相关文章
- 【原创】大叔问题定位分享(5)Kafka客户端报错SocketException: Too many open files 打开的文件过多
kafka0.8.1 一 问题 10月22号应用系统忽然报错: [2014/12/22 11:52:32.738]java.net.SocketException: 打开的文件过多 [2014/12/ ...
- python confluent kafka客户端配置kerberos认证
kafka的认证方式一般有如下3种: 1. SASL/GSSAPI 从版本0.9.0.0开始支持 2. SASL/PLAIN 从版本0.10.0.0开始支持 3. SASL/SCRAM-SHA- ...
- 解Bug之路-记一次存储故障的排查过程
解Bug之路-记一次存储故障的排查过程 高可用真是一丝细节都不得马虎.平时跑的好好的系统,在相应硬件出现故障时就会引发出潜在的Bug.偏偏这些故障在应用层的表现稀奇古怪,很难让人联想到是硬件出了问题, ...
- Kafka客户端内存缓冲GC处理机制--客户端内存
1.Kafka的客户端缓冲机制 首先,先得给大家明确一个事情,那就是在客户端发送消息给kafka服务器的时候,一定是有一个内存缓冲机制的. 也就是说,消息会先写入一个内存缓冲中,然后多条消息组成了一个 ...
- SpringMVC处理客户端请求的过程
SpringMVC处理客户端请求的过程 以程序部署在Tomcat上为例,网站程序使用SpringMVC框架开发. 1.客户端发起一个访问网站的请求(如: localhost:8080/index). ...
- Kafka 客户端实现逻辑分析
这里主要分析kafka 客户端实现 (代码分析以perl kafka实现为准) kafka客户端分为生产者和消费者,生产者发送消息,消费者获取消息. 在kafka协议里客户端通信中用到的最多的四个协议 ...
- 转:Kafka 客户端TimeoutException问题之坑
原文出自:http://www.jianshu.com/p/2db7abddb9e6 各种TimeoutException问题 会抛出org.apache.kafka.common.errors.Ti ...
- Erlang 编写 Kafka 客户端之最简单入门
Erlang 编写 Kafka 客户端之最简单入门 费劲周折,终于测通了 erlang 向kafka 发送消息,使用了ekaf 库,参考: An advanced but simple to use, ...
- kafka客户端发布record(消息)
kafka客户端发布record(消息)到kafka集群. 新的生产者是线程安全的,在线程之间共享单个生产者实例,通常单例比多个实例要快. 一个简单的例子,使用producer发送一个有序的key/v ...
随机推荐
- 定时任务框架-quartz
依赖 <!-- 定时任务jar --> <dependency> <groupId>org.quartz-scheduler</groupId> < ...
- 关于Java设计模式的一些概况
设计模式(Design pattern)在软件行业一直都扮演着很重要的角色.最近感觉自己对设计模式的知识有些遗忘了,虽然以前也看了很多,但是坦白说,其实并没有怎么理解.基本还是为了应付面试.然后,在工 ...
- OCP升级(3.6->3.7)
有个好文档还是靠普很多,感谢同事的文档.升级步骤记录如下 1.检查现有环境 [root@master ~]# etcd --version etcd Version: Git SHA: 1674e68 ...
- Ubuntu下Firefox无法播放视频的解决方法
Ubuntu为Firefox安装Adobe Flash Player 解决方法(解决火狐浏览器安装了三个flash插件中的第二个或者第三个插件而无法安装第一个adobe flash插件的方法):在新立 ...
- 十三.spring-boot使用spring-boot-thymeleaf
thymeleaf 比如freemaker的要高,thymeleaf是一个支持html原型的自然引擎,它在html 标签增加额外的属性来达到模板+数据的展示方式,由于 浏览器解释html时,忽略未定义 ...
- Codeforces Round #313 (Div. 1) Gerald's Hexagon
http://codeforces.com/contest/559/problem/A 题目大意:按顺序给出一个各内角均为120°的六边形的六条边长,求该六边形能分解成多少个边长为1的单位三角形. 解 ...
- 利用pycharm进行重构学习记录
pycharm是非常强大的pythonIDE,集成了很多实用的功能,其中就包括重构Refactor 记录下使用pycharm的重构 pycharm的Refactor默认在主菜单上就有了 Refacto ...
- eclipse package explorer视图中怎么让default package不显示?
如下图所示:
- hdu1227 Fast Food
题目链接:http://acm.hdu.edu.cn/showproblem.php? pid=1227 #include <iostream> #include <cstdio&g ...
- HDU oj password
#include<stdio.h> #include<string.h> main() { int m; scanf("%d",&m); ch ...