
python+selenium+unittest,爬虫电影网站
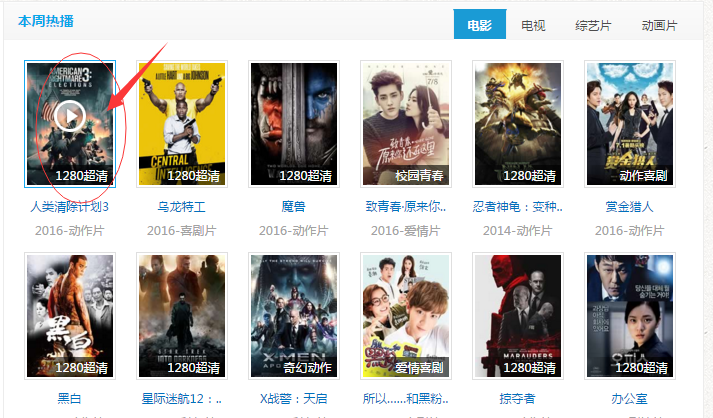
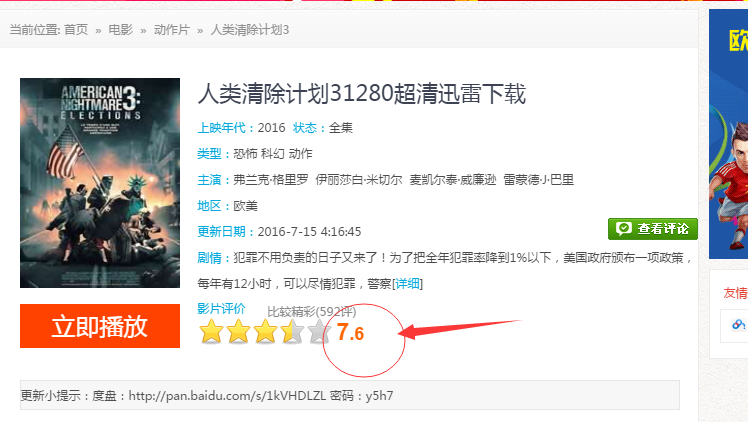
以前经常在这个网站上下载电影下来看,这个网站比较坑的就是,主页上只有电影的名称,但是评分是看不到的;只有再点击电影名字,进入电影主页时才能看到评分。一般下载的电影都是评分高的才看,低的就忽略掉了。每次都要来回去看评分,太麻烦了。So,我就写了一个小小的爬虫,暂时就叫爬虫好了。
在脚本中使用的是:python2.7 + selenium + unittest + chrome(其实我想用phantomjs的,但是在抓取评分的时候,老是抓取不到,好像是js搞的鬼)
其实流程很简单:1、进入主页获取电影的title和url,2、根据获取的url,获取该电影的评分score,3、保存结果到本地文件中
1、进入主页获取电影的title和url
2、根据获取的url,获取该电影的评分score
下面我就逐步分解:
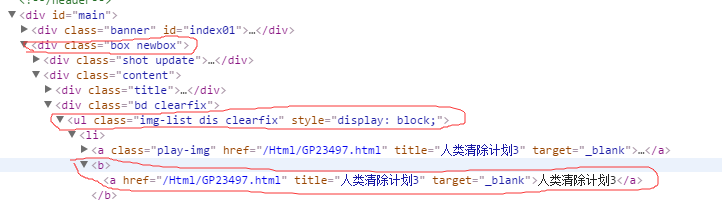
首先,进入该网站的主页,利用webdriver来定位电影,然后获取所有电影的属性:title,url,使用的定位是css
 def geturl(self): # 该函数是获取首页的电影的  title 和 url

         self.dr.get('http://www.xiamp4.com') # 网站首页

         urls = [] # 存放结果的list

         eles = self.dr.find_elements_by_css_selector('div.box.newbox ul.img-list.dis.clearfix b a') # 定位满足条件的所有电影,css定位

         for ele in eles:

             tmp = dict()

             url = ele.get_attribute('href') # 获取电影的url

             title = ele.get_attribute('title') # 获取电影的title

             tmp['url'] = url

             tmp['title'] = title

             urls.append(tmp) # 将电影的title和url放在一个字典中,然后添加到 urls中

         return urls
2、根据获取的url,获取该电影的评分score
     def getscore(self, url):

         # url = 'http://www.xiamp4.com/Html/GP23161.html'

         self.dr.get(url) # 进入电影的页面

         time.sleep(2)

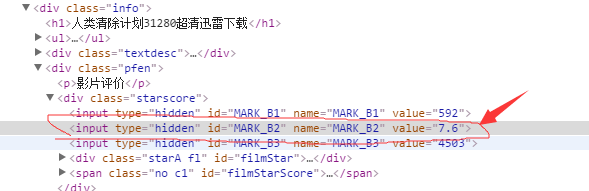
         ele = self.dr.find_element_by_css_selector('input#MARK_B2') # 定位评分的元素

         score = ele.get_attribute('value') # 获取元素value的值

         # print score

         return score    # 该函数的左右就是 根据参数电影的url,返回该电影的评分
下面是最终的代码:
 #coding=utf-8

 from selenium import webdriver

 import unittest

 import time

 class Spider(unittest.TestCase):

     def setUp(self):

         print '####################### Start #######################'

         self.dr = webdriver.Chrome()

         self.dr.implicitly_wait(10)

     def tearDown(self):

         self.dr.close()

         print '####################### End   #######################'

     def geturl(self):

         self.dr.get('http://www.xiamp4.com')

         urls = []

         eles = self.dr.find_elements_by_css_selector('div.box.newbox ul.img-list.dis.clearfix b a')

         for ele in eles:

             tmp = dict()

             url = ele.get_attribute('href')

             title = ele.get_attribute('title')

             tmp['url'] = url

             tmp['title'] = title

             urls.append(tmp)

         return urls

     def getscore(self, url):

         # url = 'http://www.xiamp4.com/Html/GP23161.html'

         self.dr.get(url)

         time.sleep(2)

         ele = self.dr.find_element_by_css_selector('input#MARK_B2')

         score = ele.get_attribute('value')

         # print score

         return score

     def test_run(self):

         moves = self.geturl()

         # print len(moves)

         for move in moves:

             move['score'] = self.getscore(move['url'])

         try:

             if len(moves) > 0:

                 with open('MoveMessage.txt', 'a') as f:

                         f.write('####################### Start #######################' + '\n')

                 for move in moves:

                     tmp = 'MoveName: %s\t,MoveScore: %s\t,MoveUrl: %s' % (move['title'],move['score'],move['url'])

                     print tmp

                     with open('MoveMessage.txt', 'a') as f:

                         f.write(tmp.encode('utf-8') + '\n')

                 with open('MoveMessage.txt', 'a') as f:

                         f.write('#######################  End  #######################' + '\n')

         except Exception,e:

             print 'Not found moves!',e

 if __name__ == '__main__':

     unittest.main()
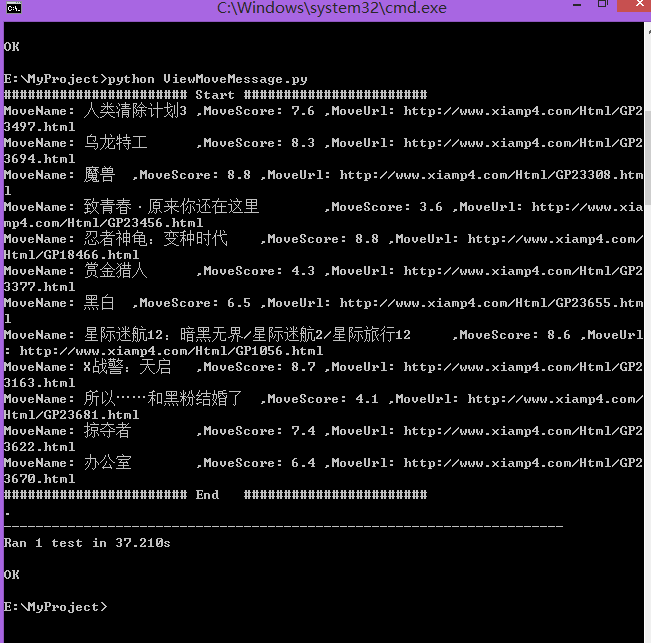
运行的最终结果:

python+selenium+unittest,爬虫电影网站的更多相关文章
- Python+selenium+unittest+HTMLTestReportCN单元测试框架分享
分享一个比较基础的,系统性的知识点.Python+selenium+unittest+HTMLTestReportCN单元测试框架分享 Unittest简介 unittest是Python语言的单元测 ...
- Python+Selenium+Unittest+Ddt+HTMLReport分布式数据驱动自动化测试框架结构
1.Business:公共业务模块,如登录模块,可以把登录模块进行封装供调用 ------login_business.py from Page_Object.Common_Page.login_pa ...
- python+selenium +unittest生成HTML测试报告
python+selenium+HTMLTestRunner+unittest生成HTML测试报告 首先要准备HTMLTestRunner文件,官网的HTMLTestRunner是python2语法写 ...
- 【爬虫】如何用python+selenium网页爬虫
一.前提 爬虫网页(只是演示,切勿频繁请求):https://www.kaola.com/ 需要的知识:Python,selenium 库,PyQuery 参考网站:https://selenium- ...
- Python Selenium unittest+HTMLTestRunner实现 自动化测试及发送测试报告邮件
1.UI测试框架搭建-目录结构 2. 文件介绍 2.1.baseinfo->__init__.py 配置文件定义基础参数 #-*-coding:utf-8-*- #测试用例配置参数 base_u ...
- python selenium --unittest 框架
转自:http://www.cnblogs.com/fnng/p/3300788.html 学习unittest 很好的一个切入点就是从selenium IDE 录制导出脚本.相信不少新手学习sele ...
- python + selenium + unittest 自动化测试框架 -- 入门篇
. 预置条件: 1. python已安装 2. pycharm已安装 3. selenium已安装 4. chrome.driver 驱动已下载 二.工程建立 1. New Project:建立自己的 ...
- Python+Selenium ----unittest单元测试框架
unittest是一个单元测试框架,是Python编程的单元测试框架.有时候,也做叫做“PyUnit”,是Junit的Python语言版本.这里了解下,Junit是Java语言的单元测试框架,Java ...
- windiows下搭建python+selenium+unittest+Chrome的Web自动化环境
一.selenium.unittest概念 Selenium 是用于测试 Web 应用程序用户界面 (UI) 的常用框架.它是一款用于运行端到端功能测试的超强工具.您可以使用多个编程语言编写测试,并且 ...
随机推荐
- THEOS makefile
转自https://www.h4ck.org.cn/2013/07/theos-makefile/ theos的makefile写法与其他linux/unix环境下的makefile写法大同小异,但是 ...
- C#人爱学不学9[C#5.0异步实例+WPF自己的MVVM Async应用 1/12]
文章摘要: 1. 通过简单DEMO.让读者理解Task和Task<T> 学习过程中,掌握async和await 2. 理解同步和异步的执行 3. Task.Factory.Start ...
- Road to the future——伪MVVM库Q.js
模仿Vuejs的伪MVVM库,下面是使用说明 项目地址:https://github.com/miniflycn/Q.js 相关项目:https://github.com/miniflycn/Ques ...
- struts2:数据校验,通过Action中的validate()方法实现校验(续:多业务方法时的不同验证处理)
前文:struts2:数据校验,通过Action中的validate()方法实现校验,图解 如果定义的Action中存在多个逻辑处理方法,且不同的处理逻辑可能需要不同的校验规则,在这种情况下,就需要通 ...
- Mac OS X Tips
命令行查看Mac OS X版本 $ sw_vers ProductName: Mac OS X ProductVersion: BuildVersion: 14D131 Mac OS X截图 不要使用 ...
- xml和xsd架构文档相关知识
1.使用架构(XSD)验证XML文件 2.使用自动生成工具: 工具目录:C:\Program Files (x86)\Microsoft SDKs\Windows\v8.0A\bin\NETFX 4. ...
- sqlite3基础
要使用sqlite,首先需要添加库文件libsqlite3.dylib.当你搜索libsqlite3关键字时,会发现还有一个libsqlite3.0.dylib的库文件,这里还是建议添加libsqli ...
- linux下mysql的root密码忘记解决方法
1.首先确认服务器出于安全的状态,也就是没有人能够任意地连接MySQL数据库. 因为在重新设置MySQL的root密码的期间,MySQL数据库完全出于没有密码保护的 状态下,其他的用户也可以任意地登录 ...
- 130 个你需要了解的 vim 命令
基础 :e filename Open filename for edition :w Save file :q Exit Vim :q! Quit without saving :x Write f ...
- tomcat的网站屏蔽IP的方法
<Host> <Valve className="org.apache.catalina.valves.RemoteAddrValve" deny=" ...