
spring boot 整合JPA多数据源
上个文章介绍了spring boot在使用Mybatis持久化技术的时候如何使用多数据源,今天再补充一个使用spring data jpa实现多数据源的使用情况,JPA是一套数据库持久化规范,或者称之为一套接口,可以类比于Java中的接口,既然有接口就有实现,Hibernate就是其中的一个实现。
本例为查询两个数据库test1和test2中的用户信息,可以共用一个实体类,当然如果有需要也可以操作不同的实体类。
1.项目的整体结构如下:
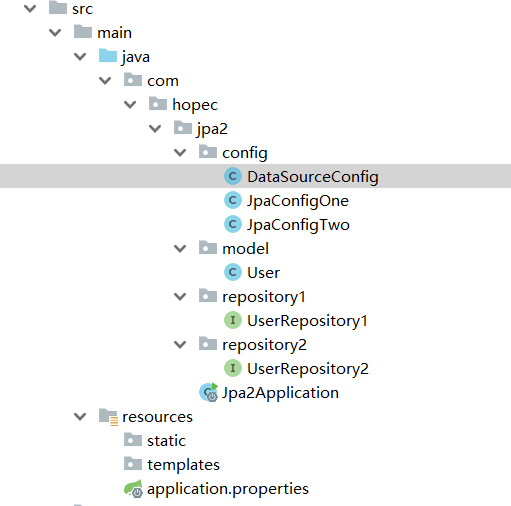
2.pom文件说明
<dependencies>

        <dependency>

            <groupId>org.springframework.boot</groupId>

            <artifactId>spring-boot-starter-data-jpa</artifactId>

        </dependency>

        <dependency>

            <groupId>org.springframework.boot</groupId>

            <artifactId>spring-boot-starter-web</artifactId>

        </dependency>

        <dependency>

            <groupId>com.alibaba</groupId>

            <artifactId>druid-spring-boot-starter</artifactId>

            <version>1.1.10</version>

        </dependency>

        <dependency>

            <groupId>mysql</groupId>

            <artifactId>mysql-connector-java</artifactId>

            <scope>runtime</scope>

            <version>5.1.27</version>

    </dependency>

        <dependency>

            <groupId>org.springframework.boot</groupId>

            <artifactId>spring-boot-starter-test</artifactId>

            <scope>test</scope>

            <exclusions>

                <exclusion>

                    <groupId>org.junit.vintage</groupId>

                    <artifactId>junit-vintage-engine</artifactId>

                </exclusion>

            </exclusions>

        </dependency>

    </dependencies>
pom文件中主要是需要锁定数据库驱动的版本,因为要使用多数据源,所以需要导入druid,因为后面要使用DruidDataSourceBuilder来初始化数据源。而spring-boot默认使用的HikariCP是不支持的。
3.项目配置文件
spring.datasource.one.type=com.alibaba.druid.pool.DruidDataSource

spring.datasource.one.url=jdbc:mysql://localhost:3306/test1

spring.datasource.one.username=root

spring.datasource.one.password=123456

spring.datasource.two.type=com.alibaba.druid.pool.DruidDataSource

spring.datasource.two.url=jdbc:mysql://localhost:3306/test2

spring.datasource.two.username=root

spring.datasource.two.password=123456

spring.jpa.properties.hibernate.ddl-auto=update  //每次启动项目如果发现实体类类更新则对应着更新表结构

spring.jpa.properties.show-sql=true                //在控制台打印sql语句

spring.jpa.properties.database=mysql

spring.jpa.properties.database-platform=mysql

spring.jpa.properties.hibernate.dialect=org.hibernate.dialect.MySQL57Dialect
注意两个数据库的配置信息的前缀不一样,后面将根据配置信息的前缀对数据源进行初始化,还有就是关于JPA的属性配置都需要在spring.jpa后面增加properties关键字,为什么这样做呢?是因为后面配置JPA的时候
不仅需要数据源还需要JpaProperties对象,看一下JpaProperties类:
    @ConfigurationProperties(prefix = "spring.jpa")

public class JpaProperties {

    /**

     * Additional native properties to set on the JPA provider.

     */

    private Map<String, String> properties = new HashMap<>();
我们自己定义的属性存到名为properties的HashMap中,再加上类的前缀为spring.jpa。所以想要spring boot自己读取需要按照其规则注入即为spring.jpa.properties。
4.用户类
    @Entity(name = "users")

public class User {

    @Id

    @GeneratedValue(strategy = GenerationType.IDENTITY)

    private Integer id;

    private String name;

    private String address;

    省略get set 方法................

}
用户类比较简单,只有几个基本的属性。@Entity注解的name的值对应数据库的表名。
5.配置数据源
    @Configuration

public class DataSourceConfig {

    @Bean

    @ConfigurationProperties(prefix = "spring.datasource.one")

    @Primary

    DataSource dsOne() {

        return DruidDataSourceBuilder.create().build();

    }

    //primary注解表示某个类存在多个实例时优先使用当前bean

    @Bean

    @ConfigurationProperties(prefix = "spring.datasource.two")

    DataSource dsTwo() {

        return DruidDataSourceBuilder.create().build();

    }

}
既然是多数据源那么肯定需要自己配置多个数据源的情况,注意这里需要增加@Primary注解,其含义就是表示某个类存在多个实例时优先使用当前实例,如果不加项目会报错,多个bean只能加一个,意思是dsTwo同样返回的DataSource,但是dsOne加了,其他的就不能再加了。
6.JPA配置
(1)第一个JPA的配置
    @Configuration

@EnableJpaRepositories(basePackages = "com.hopec.jpa2.repository1",transactionManagerRef = "platformTransactionManager1",entityManagerFactoryRef = "localContainerEntityManagerFactoryBean1")

public class JpaConfigOne {

    @Autowired

    @Qualifier(value = "dsOne")

    DataSource dsOne;

    @Autowired

    JpaProperties jpaProperties;

    @Bean

    @Primary //相应的需要添加上此注解

    LocalContainerEntityManagerFactoryBean localContainerEntityManagerFactoryBean1(EntityManagerFactoryBuilder factoryBuilder){

        return factoryBuilder.dataSource(dsOne)   //设置数据源

                .properties(jpaProperties.getProperties()) //获取配置信息

                .packages("com.hopec.jpa2.model")  //设置扫描的实体类的包

                .persistenceUnit("name1")           //持久化单元的名称 不同的对象的名字不同就可以

                .build();

    }

    @Bean

    PlatformTransactionManager platformTransactionManager1(EntityManagerFactoryBuilder factoryBuilder){

        LocalContainerEntityManagerFactoryBean bean = localContainerEntityManagerFactoryBean1(factoryBuilder);

        return new JpaTransactionManager(bean.getObject());

    }

}
(2)第二个JPA的配置
    @Configuration

@EnableJpaRepositories(basePackages = "com.hopec.jpa2.repository2",transactionManagerRef = "platformTransactionManager2",entityManagerFactoryRef = "localContainerEntityManagerFactoryBean2")

public class JpaConfigTwo {

    @Autowired

    @Qualifier(value = "dsTwo")

    DataSource dsTwo;

    @Autowired

    JpaProperties jpaProperties;

    @Bean

    LocalContainerEntityManagerFactoryBean localContainerEntityManagerFactoryBean2(EntityManagerFactoryBuilder factoryBuilder){

        return factoryBuilder.dataSource(dsTwo)   //设置数据源

                .properties(jpaProperties.getProperties()) //获取配置信息

                .packages("com.hopec.jpa2.model")  //设置扫描的实体类的包

                .persistenceUnit("name2")           //持久化单元的名称 不同的对象的名字不同就可以

                .build();

    }

    @Bean

    PlatformTransactionManager platformTransactionManager2(EntityManagerFactoryBuilder factoryBuilder){

        LocalContainerEntityManagerFactoryBean bean = localContainerEntityManagerFactoryBean2(factoryBuilder);

        return new JpaTransactionManager(bean.getObject());

    }

}
以上两个JPA的配置主要是注意包名路径的对应一定要保持一致。
7.持久层
(1)第一个持久层
public interface UserRepository1 extends JpaRepository<User,Integer>{

    @Query(value = "select * from users where id=(select max(id) from users)",nativeQuery = true)

    User findMaxIdUser();

    //自定义的属性如何进行匹配

    @Query(value = "insert into users(name,address) values(?1,?2)",nativeQuery = true)

    @Modifying

    @Transactional

    Integer addUser1(String name,String author);

    @Query(value = "insert into users(name,address) values(:name,:address)",nativeQuery = true)

    @Modifying

    @Transactional

    Integer addUser2(@Param("name") String name, @Param("address") String address);

    //自定义的对象与sql语句进行匹配

    @Query(value = "insert into users(name,address) values(:#{#user.name},:#{#user.address})",nativeQuery = true)

    @Modifying

    @Transactional

    Integer addUser3(@Param("user") User user);
这里其实不需要写这么复杂的,单纯查询所有用户信息,JpaRepository里面已经实现了,这里自定义查询和保存用户方法是为了多学习一点如何在JPA中自定义查询方法以及参数对应,也就是将自定义的方法中的普通参数或者对象与@Query中原生SQL的属性对应起来。
(2)第二个持久层
    public interface UserRepository2 extends JpaRepository<User,Integer>{

}
实际上在本例中是这样的,不需要第一个那么复杂,第一个只是作为扩展的参考。
8.测试
        @Test

    public void test1(){

        List<User> users = userRepository1.findAll();

        System.out.println(users);

        List<User> users1 = userRepository2.findAll();

        System.out.println(users1);

    }

    @Test

    public void test2(){

        User user = new User();

        user.setName("123");

        user.setAddress("石家庄");

        Integer r = userRepository1.addUser3(user);

        System.out.println(r);

    }
测试结果:

最后大功告成!
spring boot 整合JPA多数据源的更多相关文章
- Spring Boot2 系列教程(二十五)Spring Boot 整合 Jpa 多数据源
本文是 Spring Boot 整合数据持久化方案的最后一篇,主要和大伙来聊聊 Spring Boot 整合 Jpa 多数据源问题.在 Spring Boot 整合JbdcTemplate 多数据源. ...
- Spring Boot 整合 JPA 使用多个数据源
介绍 JPA(Java Persistence API)Java 持久化 API,是 Java 持久化的标准规范,Hibernate 是持久化规范的技术实现,而 Spring Data JPA 是在 ...
- spring boot 系列之四:spring boot 整合JPA
上一篇我们讲了spring boot 整合JdbcTemplate来进行数据的持久化, 这篇我们来说下怎么通过spring boot 整合JPA来实现数据的持久化. 一.代码实现 修改pom,引入依赖 ...
- Spring Boot整合JPA、Redis和Swagger2
好久没有总结了,最近也一直在学习.今天就把spring boot与其它技术的整合做个小总结,主要是jpa.redis和swagger2.公司里有用到这些,整合起来也很简单. 首先,新建一个Spring ...
- Spring Boot2 系列教程(二十)Spring Boot 整合JdbcTemplate 多数据源
多数据源配置也算是一个常见的开发需求,Spring 和 SpringBoot 中,对此都有相应的解决方案,不过一般来说,如果有多数据源的需求,我还是建议首选分布式数据库中间件 MyCat 去解决相关问 ...
- Spring Boot2 系列教程(二十四)Spring Boot 整合 Jpa
Spring Boot 中的数据持久化方案前面给大伙介绍了两种了,一个是 JdbcTemplate,还有一个 MyBatis,JdbcTemplate 配置简单,使用也简单,但是功能也非常有限,MyB ...
- Spring Boot从入门到精通之:二、Spring Boot整合JPA
springboot-jpa 开发工具 系统: windows10 开发工具: Intellij IDEA 2018.2.6 springboot: 2.0.6.RELEASE jdk: 1.8.0_ ...
- spring boot - 整合jpa
<dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring- ...
- spring boot 整合JPA bean注入失败
有时候报的错误让你匪夷所思,找错误得学会找根.源头在哪里? 比如:我们刚开始看的错误就是 org.springframework.beans.factory.UnsatisfiedDependency ...
随机推荐
- 代码审计之XSS及修复
xss在平时的测试中,还是比较重要的,如果存在储存型xss,就可以做很多事情了,打cookie,添加管理员等等很多操作. 以下所有代码都是我自己写的,可能有不美观,代码错误等等问题,希望大家可以指正. ...
- Kafka系列一之架构介绍和安装
Kafka架构介绍和安装 写在前面 还是那句话,当你学习一个新的东西之前,你总得知道这个东西是什么?这个东西可以用来做什么?然后你才会去学习它,使用它.简单来说,kafka既是一个消息队列,如今,它也 ...
- Scrapy项目 - 实现斗鱼直播网站信息爬取的爬虫设计
要求编写的程序可爬取斗鱼直播网站上的直播信息,如:房间数,直播类别和人气等.熟悉掌握基本的网页和url分析,同时能灵活使用Xmind工具对Python爬虫程序(网络爬虫)流程图进行分析. 一.项目 ...
- Spark 学习笔记之 Standalone与Yarn启动和运行时间测试
Standalone与Yarn启动和运行时间测试: 写一个简单的wordcount: 打包上传运行: Standalone启动: 运行时间: Yarn启动: 运行时间: 测试结果: Standalon ...
- 快学Scala 第二十课 (trait的构造顺序)
trait的构造顺序: 首先调用超类构造器 特质构造器在超类构造器之后,类构造器之前执行 特质从左向右被构造 每个特质当中,父特质先被构造 如果多个特质共有一个父特质,而那个父特质已经被构造,则不会被 ...
- Android的各大框架整理
OpenDanmaku :一个Android的弹幕控件 地址:https://github.com/linsea/OpenDanmaku AndroidViewAnimations:Andorid视 ...
- 响应系统设置的事件(Configuration类)
1.Configuration给我们提供的方法列表 densityDpi:屏幕密度 fontScale:当前用户设置的字体的缩放因子 hardKeyboardHidden:判断硬键盘是否可见,有两个可 ...
- Spring Boot 2.x 基础案例:整合Dubbo 2.7.3+Nacos1.1.3(配置中心)
本文原创首发于公众号:Java技术干货 1.概述 本文将Nacos作为配置中心,实现配置外部化,动态更新.这样做的优点:不需要重启应用,便可以动态更新应用里的配置信息.在如今流行的微服务应用下,将应用 ...
- 为你的Mysql排序查询增加一个排序号
排序号,在需要排序的查询中比较常见,今天再一次遇到这种场景,不常写,所以上手比较生疏,记录一下,或许对更多的人也有用处. 起初在网上进行了一下简单的搜索,但是文章都挺乱,可读性都不太高,经过一番调查, ...
- JDBC访问数据库的基本步骤
加载驱动 通过DriverManager对象获取连接对象Connection 通过连接对象获取会话 通过会话进行数据的增删改查,封装对象 关闭资源