
【Spark】RDD的依赖关系和缓存相关知识点
RDD的依赖关系
RDD和它依赖的父RDD的关系有两种不同的类型,即窄依赖(narrow dependency) 和宽依赖(wide dependency)。
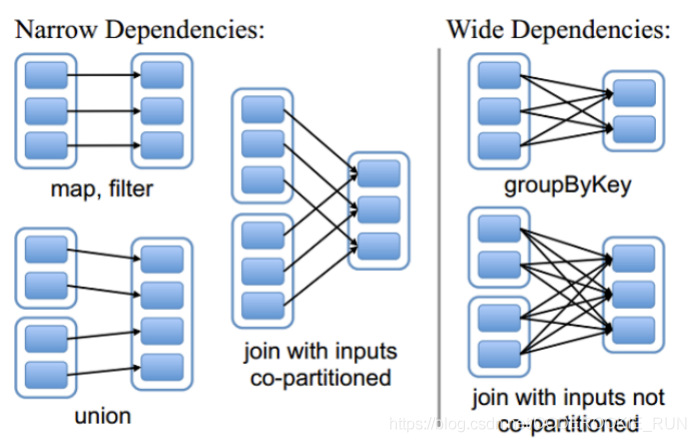
宽依赖
宽依赖指的是子RDD中的数据来源于父RDD中的多个分区,其实就是产生了shuffle
窄依赖
窄依赖指的是子RDD中的数据来源于父RDD当中的一个分区,也即没有产生shuffle
血统
Lineage —— 根据rdd之间的依赖关系,将依赖关系给记录下来叫做血统。
比如:
rdd1 ==> rdd2 ==> rdd3 ==> rdd4
记录下来每一个rdd的父rdd是谁,也记录下来每一个rdd的子rdd是谁,可以帮助我们做容灾
RDD缓存
概述
Spark速度非常快的原因之一,就是在不同操作中可以在内存中持久化或者缓存数据集。当持久化某个RDD后,每一个节点都将把计算分区结果保存在内存中,对此RDD或衍生出的RDD进行的其他动作中重用。这使得后续的动作变得更加迅速。RDD相关的持久化和缓存,是Spark最重要的特征之一。可以说,缓存是Spark构建迭代式算法和快速交互式查询的关键。
缓存方式
通过查看StorageLevel的源码可以拿到
object StorageLevel {

  //不缓存

  val NONE = new StorageLevel(false, false, false, false)

  //只在硬盘缓存

  val DISK_ONLY = new StorageLevel(true, false, false, false)

  //在硬盘缓存两份

  val DISK_ONLY_2 = new StorageLevel(true, false, false, false, 2)

  //只在内存缓存

  val MEMORY_ONLY = new StorageLevel(false, true, false, true)

  //在内存缓存两份

  val MEMORY_ONLY_2 = new StorageLevel(false, true, false, true, 2)

  //在内存序列化缓存

  val MEMORY_ONLY_SER = new StorageLevel(false, true, false, false)

  //在内存序列化缓存两份

  val MEMORY_ONLY_SER_2 = new StorageLevel(false, true, false, false, 2)

  //同时在内存和硬盘缓存

  val MEMORY_AND_DISK = new StorageLevel(true, true, false, true)

  //同时在内存和硬盘缓存两份(推荐)

  val MEMORY_AND_DISK_2 = new StorageLevel(true, true, false, true, 2)

  //同时在内存和硬盘序列化缓存

  val MEMORY_AND_DISK_SER = new StorageLevel(true, true, false, false)

  //同时在内存和硬盘序列化缓存两份

  val MEMORY_AND_DISK_SER_2 = new StorageLevel(true, true, false, false, 2)

  //对外内存

  val OFF_HEAP = new StorageLevel(false, false, true, false)

  ......

}
两种方法:
1.cache(),其实底层就是调用了persist,将数据仅仅的放到内存里面去,放一份
2.persist()
(1)无参,也是将只在内存中缓存一份数据
(2)带StorageLevel参数,一般选择MEMORY_AND_DISK_2
【Spark】RDD的依赖关系和缓存相关知识点的更多相关文章
- 大数据学习day23-----spark06--------1. Spark执行流程(知识补充:RDD的依赖关系)2. Repartition和coalesce算子的区别 3.触发多次actions时,速度不一样 4. RDD的深入理解(错误例子,RDD数据是如何获取的)5 购物的相关计算
1. Spark执行流程 知识补充:RDD的依赖关系 RDD的依赖关系分为两类:窄依赖(Narrow Dependency)和宽依赖(Shuffle Dependency) (1)窄依赖 窄依赖指的是 ...
- sparkRDD:第4节 RDD的依赖关系;第5节 RDD的缓存机制;第6节 DAG的生成
4. RDD的依赖关系 6.1 RDD的依赖 RDD和它依赖的父RDD的关系有两种不同的类型,即窄依赖(narrow dependency)和宽依赖(wide dependency ...
- Spark RDD概念学习系列之RDD的依赖关系(宽依赖和窄依赖)(三)
RDD的依赖关系? RDD和它依赖的parent RDD(s)的关系有两种不同的类型,即窄依赖(narrow dependency)和宽依赖(wide dependency). 1)窄依赖指的是每 ...
- RDD的依赖关系
RDD的依赖关系 Rdd之间的依赖关系通过rdd中的getDependencies来进行表示, 在提交job后,会通过在DAGShuduler.submitStage-->getMissingP ...
- 021 RDD的依赖关系,以及造成的stage的划分
一:RDD的依赖关系 1.在代码中观察 val data = Array(1, 2, 3, 4, 5) val distData = sc.parallelize(data) val resultRD ...
- Spark RDD 窄依赖研究
1.. 简介 spark从RDD依赖上来说分为窄依赖和宽依赖. 其中可以这样区分是哪种依赖:当父RDD的一个partition被子RDD的多个partitions引用到的时候则说明是宽依赖,否则为窄依 ...
- Spark RDD概念学习系列之rdd的依赖关系彻底解密(十九)
本期内容: 1.RDD依赖关系的本质内幕 2.依赖关系下的数据流视图 3.经典的RDD依赖关系解析 4.RDD依赖关系源码内幕 1.RDD依赖关系的本质内幕 由于RDD是粗粒度的操作数据集,每个Tra ...
- Spark RDD的依赖解读
在Spark中, RDD是有依赖关系的,这种依赖关系有两种类型 窄依赖(Narrow Dependency) 宽依赖(Wide Dependency) 以下图说明RDD的窄依赖和宽依赖 窄依赖 窄依赖 ...
- spark rdd 宽窄依赖理解
== 转载 == http://blog.csdn.net/houmou/article/details/52531205 Spark中RDD的高效与DAG图有着莫大的关系,在DAG调度中需要对计算过 ...
随机推荐
- 当文件目录变得杂乱不堪怎么办,python帮你轻松搞定
这几天和几个小伙伴,在一起合做一个ppt. 做ppt之前有原版的ppt,和一个word大纲,在制作过程中,又不断添加图片.视频等素材,最终,整个目录变得杂乱不堪(见下图-处理之前) 那我想,可不可以做 ...
- Xshell远程连接Linux系统
一般来说我们连接Linux,会使用到一些远程连接工具 比如:Xshell和Xftp Xshell:远程连接linux系统 Xftp:远程在Linux系统中上传或下载文件 Xshell和Xftp百度云链 ...
- [git] github上传项目(使用git)、删除项目、添加协作者
来源:http://www.cnblogs.com/sakurayeah/p/5800424.html (怕链接失败,所以直接就就复制过来啦,感谢作者) 一.注册github账号 github网址ht ...
- 几个可以提高工作效率的Python内置小工具
在这篇文章里,我们将会介绍4个Python解释器自身提供的小工具.这些小工具在笔者的日常工作中经常用到,减少了各种时间的浪费,然而,却很容易被大家忽略.每当有新来的同事看到我这么使用时,都忍不住感叹, ...
- pytorch seq2seq模型训练测试
num_sequence.py """ 数字序列化方法 """ class NumSequence: """ ...
- python中文语料分词处理,按字或者词cut_sentence
cut_sentence.py import string import jieba import jieba.posseg as psg import logging #关闭jieba日制 jieb ...
- JDBC中的时间处理
MySQL中常用的时间类有: java.sql.Date, Time, Timestamp 用的比较多的是ava.sql.Date和TimeStamp: 先看表结构 CREATE TABLE `t_u ...
- windows下部署.netcore+docker系列四 (部署程序,重点就要来了)
前面的都是为这章做准备,加油把骚年们 PS:C# 项目可以按照流程一步步来,java 偶然其他的可以找下其他的网上资源 1.在 VS2019中 添加docker 支持 (其实也就是追加一个Docker ...
- Python机器学习笔记:K-Means算法,DBSCAN算法
K-Means算法 K-Means 算法是无监督的聚类算法,它实现起来比较简单,聚类效果也不错,因此应用很广泛.K-Means 算法有大量的变体,本文就从最传统的K-Means算法学起,在其基础上学习 ...
- ES6中对数组的扩展
hello,大家好,我又来了. 前面讲了字符串和数值的扩展,今天要讲的是:数组的扩展.不知道大家能否跟得上这个节奏,你们在阅读中对讲解有存在疑惑,记得留言提出来,要真正地理解,否则白白 ...