
爬虫之Xpath案例
案例:使用XPath的爬虫
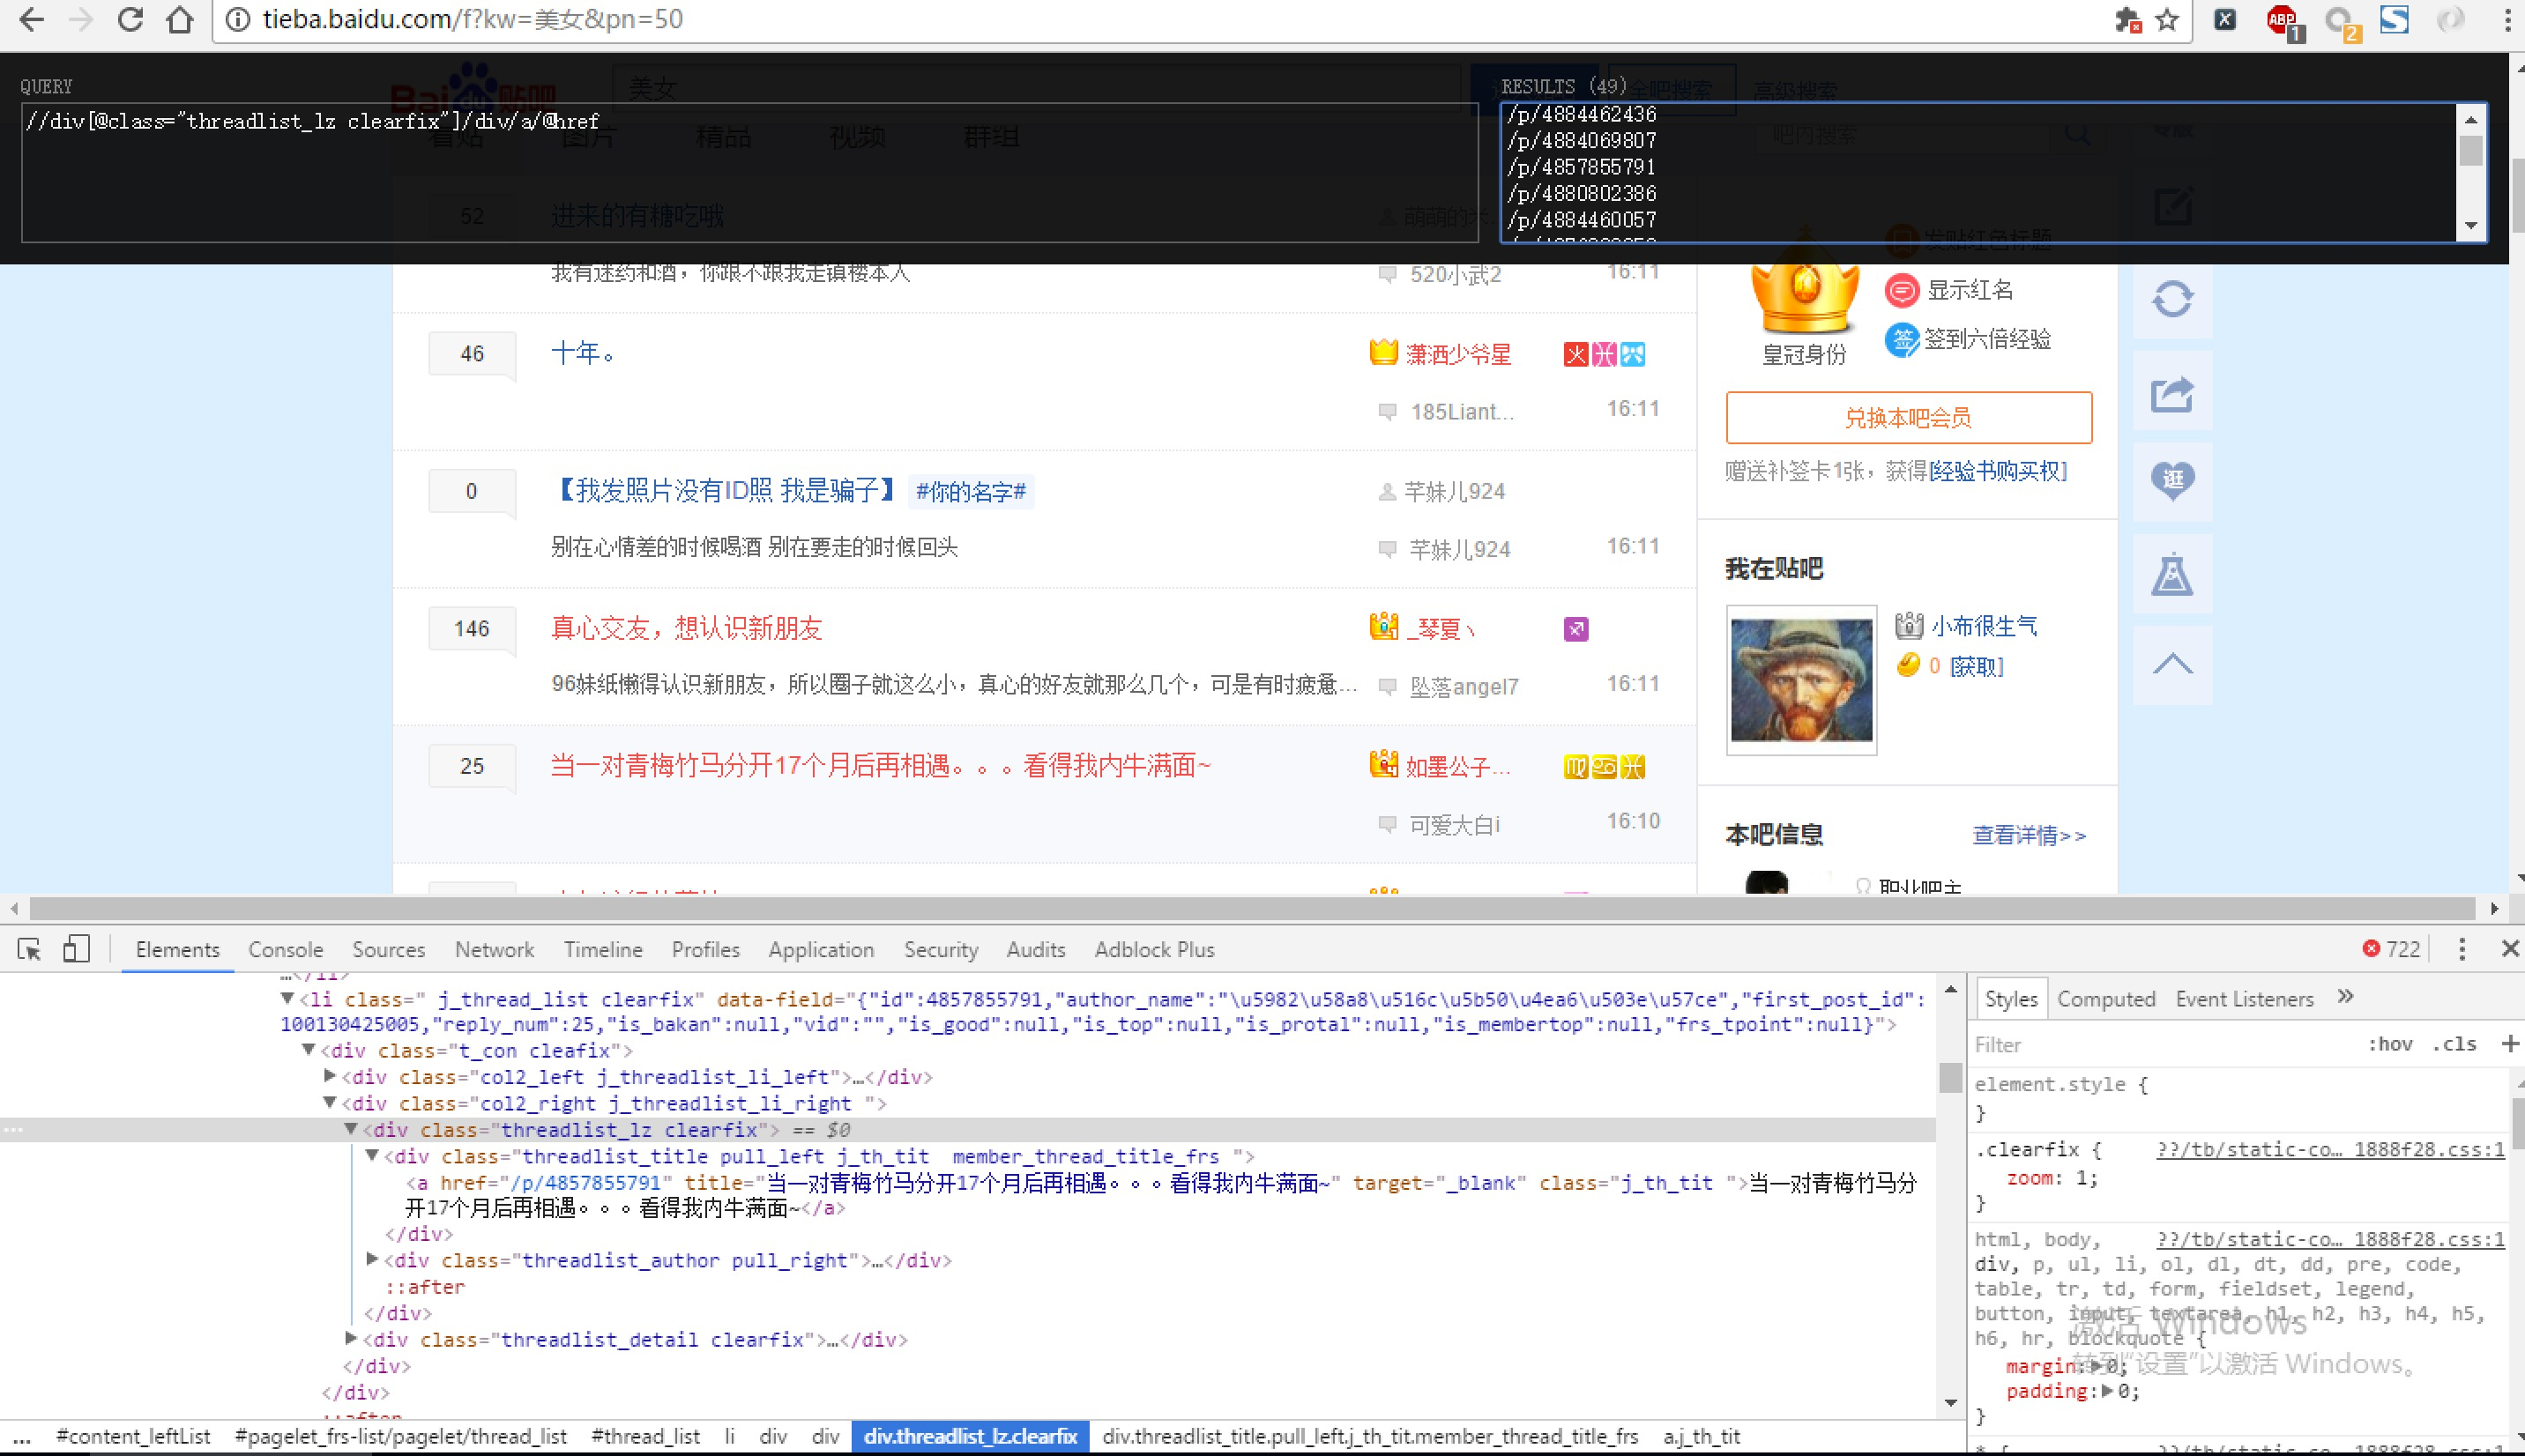
现在我们用XPath来做一个简单的爬虫,我们尝试爬取某个贴吧里的所有帖子,并且将该这个帖子里每个楼层发布的图片下载到本地。
# tieba_xpath.py

#!/usr/bin/env python

# -*- coding:utf-8 -*-

import os

import urllib

import urllib2

from lxml import etree

class Spider:

    def __init__(self):

        self.tiebaName = raw_input("请需要访问的贴吧:")

        self.beginPage = int(raw_input("请输入起始页:"))

        self.endPage = int(raw_input("请输入终止页:"))

        self.url = 'http://tieba.baidu.com/f'

        self.ua_header = {"User-Agent" : "Mozilla/5.0 (compatible; MSIE 9.0; Windows NT 6.1 Trident/5.0;"}

        # 图片编号

        self.userName = 1

    def tiebaSpider(self):

        for page in range(self.beginPage, self.endPage + 1):

            pn = (page - 1) * 50 # page number

            word = {'pn' : pn, 'kw': self.tiebaName}

            word = urllib.urlencode(word) #转换成url编码格式(字符串)

            myUrl = self.url + "?" + word

            # 示例:http://tieba.baidu.com/f? kw=%E7%BE%8E%E5%A5%B3 & pn=50

            # 调用 页面处理函数 load_Page

            # 并且获取页面所有帖子链接,

            links = self.loadPage(myUrl)  # urllib2_test3.py

    # 读取页面内容

    def loadPage(self, url):

        req = urllib2.Request(url, headers = self.ua_header)

        html = urllib2.urlopen(req).read()

        # 解析html 为 HTML 文档

        selector=etree.HTML(html)

        #抓取当前页面的所有帖子的url的后半部分,也就是帖子编号

        # http://tieba.baidu.com/p/4884069807里的 “p/4884069807”

        links = selector.xpath('//div[@class="threadlist_lz clearfix"]/div/a/@href')

        # links 类型为 etreeElementString 列表

        # 遍历列表,并且合并成一个帖子地址,调用 图片处理函数 loadImage

        for link in links:

            link = "http://tieba.baidu.com" + link

            self.loadImages(link)

    # 获取图片

    def loadImages(self, link):

        req = urllib2.Request(link, headers = self.ua_header)

        html = urllib2.urlopen(req).read()

        selector = etree.HTML(html)

        # 获取这个帖子里所有图片的src路径

        imagesLinks = selector.xpath('//img[@class="BDE_Image"]/@src')

        # 依次取出图片路径,下载保存

        for imagesLink in imagesLinks:

            self.writeImages(imagesLink)

    # 保存页面内容

    def writeImages(self, imagesLink):

        '''

            将 images 里的二进制内容存入到 userNname 文件中

        '''

        print imagesLink

        print "正在存储文件 %d ..." % self.userName

        # 1. 打开文件,返回一个文件对象

        file = open('./images/' + str(self.userName)  + '.png', 'wb')

        # 2. 获取图片里的内容

        images = urllib2.urlopen(imagesLink).read()

        # 3. 调用文件对象write() 方法,将page_html的内容写入到文件里

        file.write(images)

        # 4. 最后关闭文件

        file.close()

        # 计数器自增1

        self.userName += 1

# 模拟 main 函数

if __name__ == "__main__":

    # 首先创建爬虫对象

    mySpider = Spider()

    # 调用爬虫对象的方法,开始工作

    mySpider.tiebaSpider()
爬虫之Xpath案例的更多相关文章
- Python爬虫之xpath语法及案例使用
Python爬虫之xpath语法及案例使用 ---- 钢铁侠的知识库 2022.08.15 我们在写Python爬虫时,经常需要对网页提取信息,如果用传统正则表达去写会增加很多工作量,此时需要一种对数 ...
- 爬虫常用Xpath和CSS3选择器对比
爬虫常用Xpath和CSS3选择器对比 1. 简介 CSS是来配合HTML工作的,和Xpath对比起来,CSS选择器通常都比较短小,但是功能不够强大.CSS中的空白符' '和Xpath的'//'都表示 ...
- 中国爬虫违法违规案例汇总github项目介绍
中国爬虫违法违规案例汇总github项目介绍 GitHub - 本项目用来整理所有中国大陆爬虫开发者涉诉与违规相关的新闻.资料与法律法规.致力于帮助在中国大陆工作的爬虫行业从业者了解我国相关法律,避免 ...
- python爬虫:XPath语法和使用示例
python爬虫:XPath语法和使用示例 XPath(XML Path Language)是一门在XML文档中查找信息的语言,可以用来在XML文档中对元素和属性进行遍历. 选取节点 XPath使用路 ...
- 非常全的一份Python爬虫的Xpath博文
非常全的一份Python爬虫的Xpath博文 Xpath 是 python 爬虫过程中非常重要的一个用来定位的一种语法. 一.开始使用 首先我们需要得到一个 HTML 源代码,用来模拟爬取网页中的源代 ...
- Python爬虫(十三)_案例:使用XPath的爬虫
本篇是使用XPath的案例,更多内容请参考:Python学习指南 案例:使用XPath的爬虫 现在我们用XPath来做一个简单的爬虫,我们尝试爬取某个贴吧里的所有帖子且将该帖子里每个楼层发布的图片下载 ...
- 爬虫神器xpath的用法(三)
xpath的多线程爬虫 #encoding=utf-8 ''' pool = Pool(4) cpu的核数为4核 results = pool.map(爬取函数,网址列表) ''' from mult ...
- 爬虫神器XPath,程序员带你免费获取周星驰等明星热门电影
本教程由"做全栈攻城狮"原创首发,本人大学生一枚平时还需要上课,但尽量每日更新文章教程.一方面把我所习得的知识分享出来,希望能对初学者有所帮助.另一方面总结自己所学,以备以后查看. ...
- 互联网金融爬虫怎么写-第一课 p2p网贷爬虫(XPath入门)
版权声明:本文为博主原创文章,未经博主允许不得转载. 相关教程: 手把手教你写电商爬虫-第一课 找个软柿子捏捏 手把手教你写电商爬虫-第二课 实战尚妆网分页商品采集爬虫 手把手教你写电商爬虫-第三课 ...
随机推荐
- 2017 Multi-University Training Contest - Team 7
HDU6121 Build a tree 题目链接:http://acm.hdu.edu.cn/showproblem.php?pid=6121 题目意思:一棵 n 个点的完全 k 叉树,结点标号从 ...
- 微软构建高效DevOps团队培训总结
9.21和9.22这两天参加了微软DevOps的培训,主要是围绕TFS2015的不少新功能来讲的,相比较之前我们一直使用TFS2013来管理团队,确实强大了不少,也更加实用了. 首先,什么是DevOp ...
- python学习笔记(四)— 补充
函数return多个值 函数如果有多个return值,那么会生成一个元组里面 def hello(a,b,c,d): return a,b,c,d res =hello('aa','cc','dd', ...
- Linux 2.6 内核阅读笔记 中断和异常
2014年7月24日 中断门.陷阱门及中断门 中断是能够禁止的,能够通过告诉PIC停止对某个中断的公布.被禁止的中断是不会丢失的,在解除禁止后又会发送到CPU上. 禁止中断和屏蔽(mask)中断的不同 ...
- Python第一个爬虫学习
在网上查看大神的关于Python爬虫的文章,代码如下: #coding=utf-8 import urllib import re def getHtml(url): page = urllib.ur ...
- 马尔可夫随机场(Markov random fields) 概率无向图模型 马尔科夫网(Markov network)
上面两篇博客,解释了概率有向图(贝叶斯网),和用其解释条件独立.本篇将研究马尔可夫随机场(Markov random fields),也叫无向图模型,或称为马尔科夫网(Markov network) ...
- linux怎样使用top命令查看系统状态
有时候有很多问题只有在线上或者预发环境才能发现,而线上又不能Debug,所以线上问题定位就只能看日志,系统状态和Dump线程. Linux系统可以通过top命令查看系统的CPU.内存.运行时间.交换分 ...
- Python(线程进程2)
新进程的创建都是由一个已经存在的进程执行了一个用于创建进程的系统调用而创建的: 1. 在UNIX中该系统调用是:fork,fork会创建一个与父进程一模一样的副本,二者有相同的存储映像.同样的环境字符 ...
- DEPHI XE5 XE6 ANDROID IOS开发的几点体会
DEPHI XE5 XE6 ANDROID IOS开发的几点体会 2014-09-04 20:48 1.不纠结于APK或者APP的大小.现在的客户端设备都很廉价,300元以上的新安卓设备都不在乎软件的 ...
- SQL Server WITH ROLLUP、WITH CUBE、GROUPING语句的应用
CUBE:CUBE 生成的结果集显示了所选列中值的所有组合的聚合. ROLLUP:ROLLUP 生成的结果集显示了所选列中值的某一层次结构的聚合. GROUPING:当行由 CUBE 或 ROLLUP ...