
【原创】Python 二手车之家车辆档案数据爬虫
| 本文仅供学习交流使用,如侵立删! |
二手车之家车辆档案数据爬虫
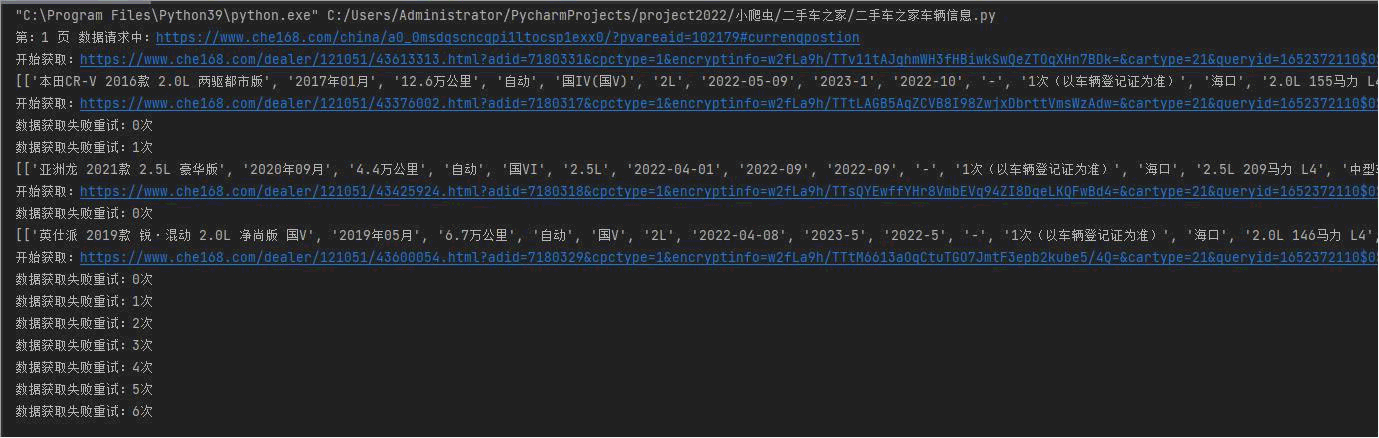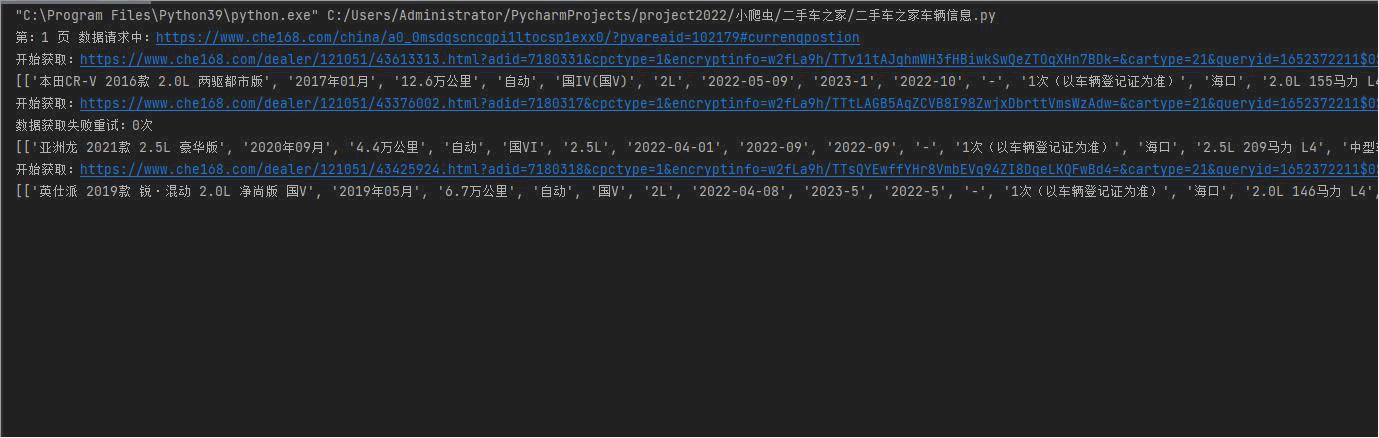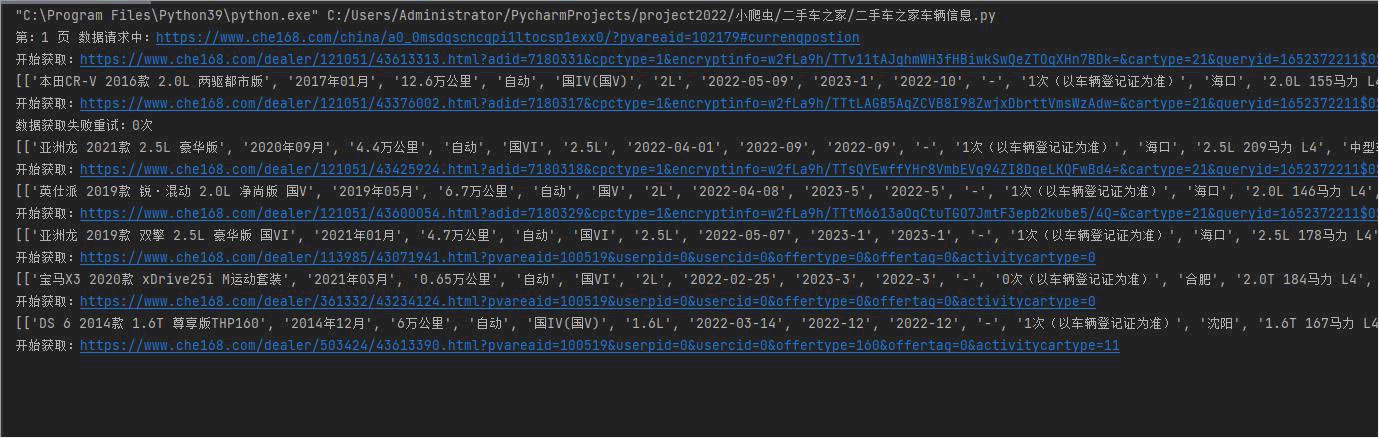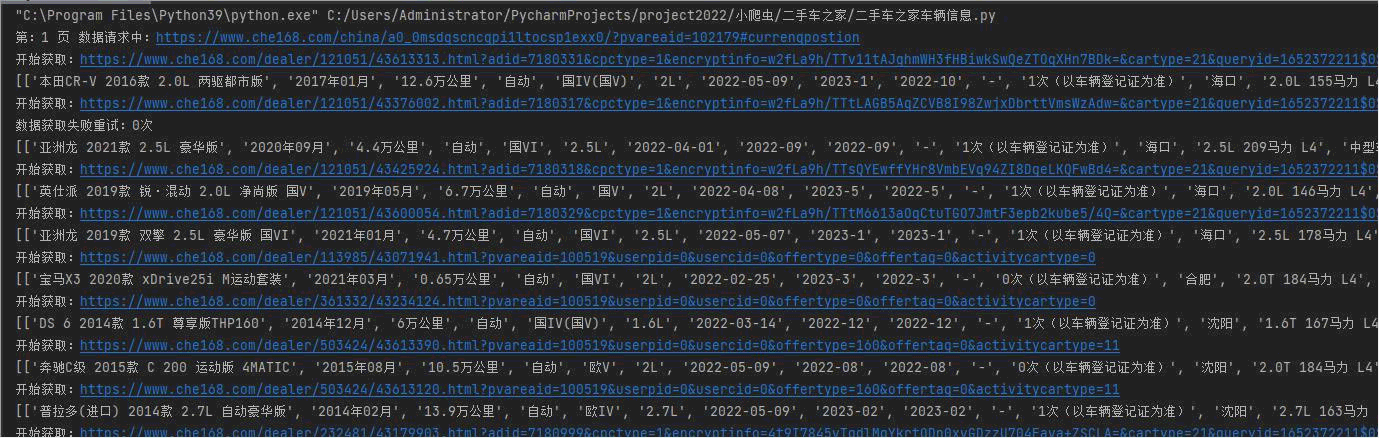
先上效果图

环境
- win10
- python3.9
- lxml、retrying、requests
需求分析
需求:
主要是需要车辆详情页中车辆档案的数据
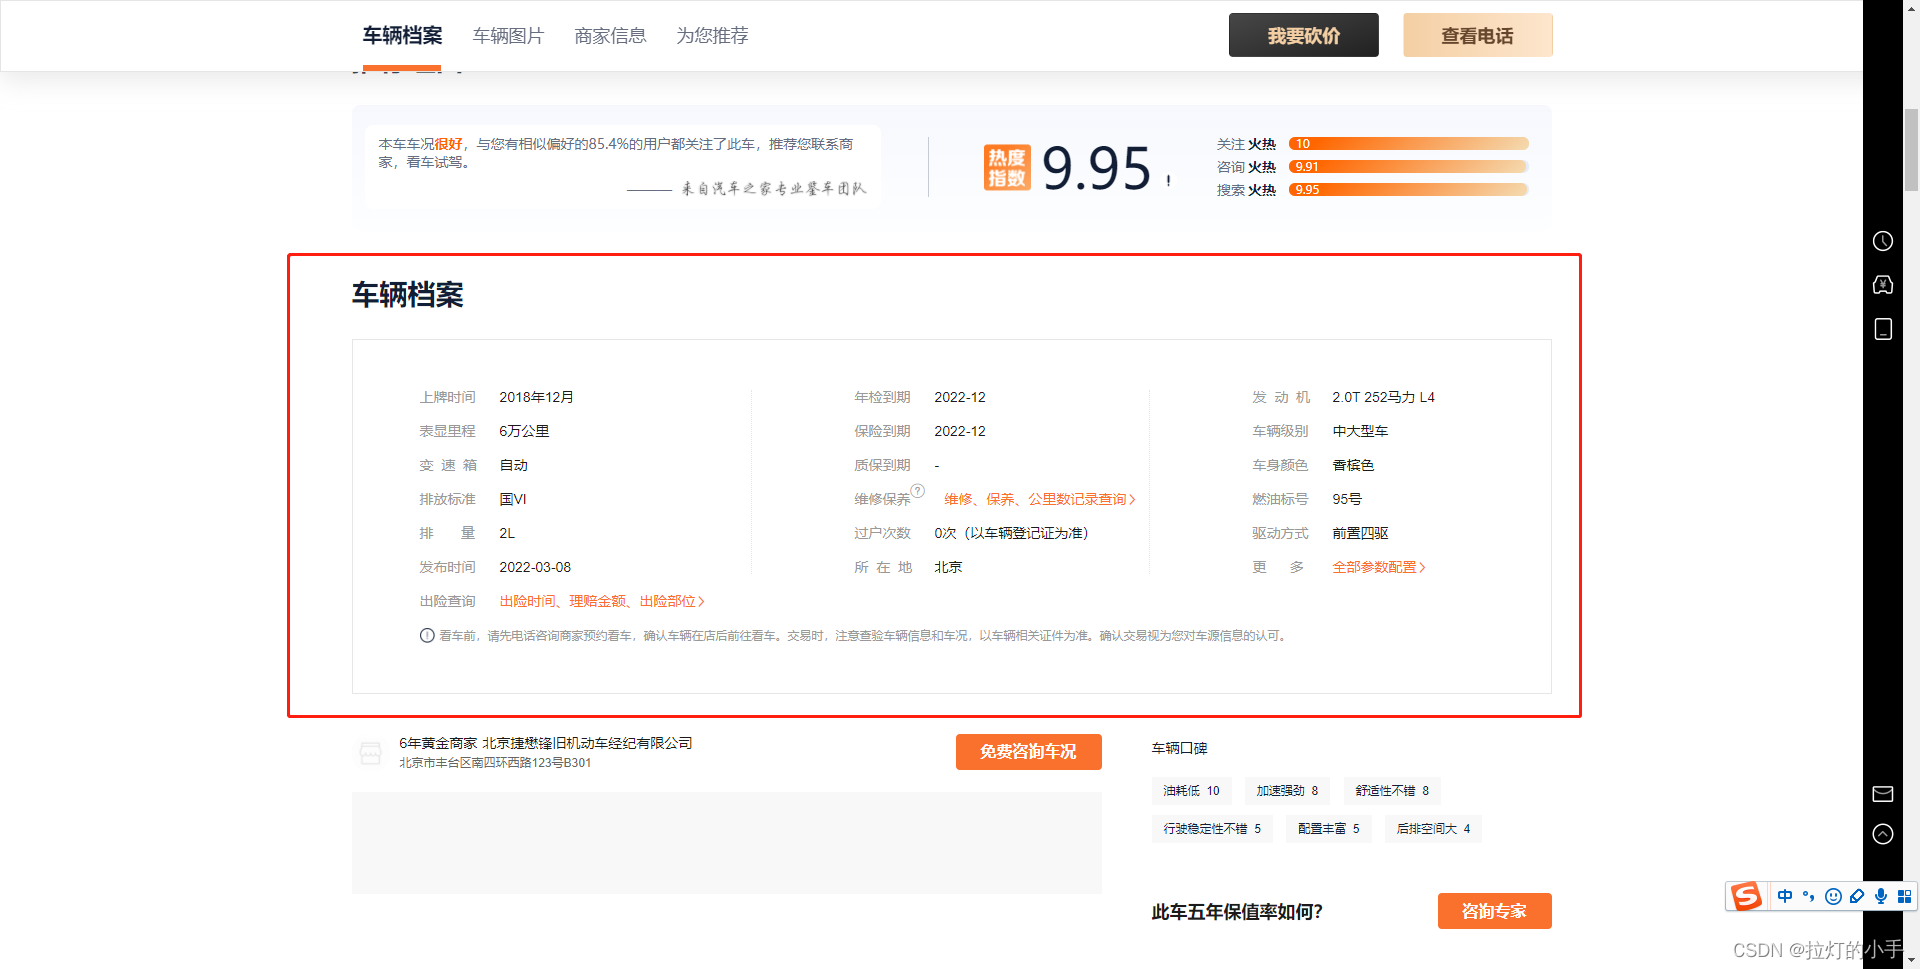
先抓包分析一波,网页抓包没有什么有用的,转战APP
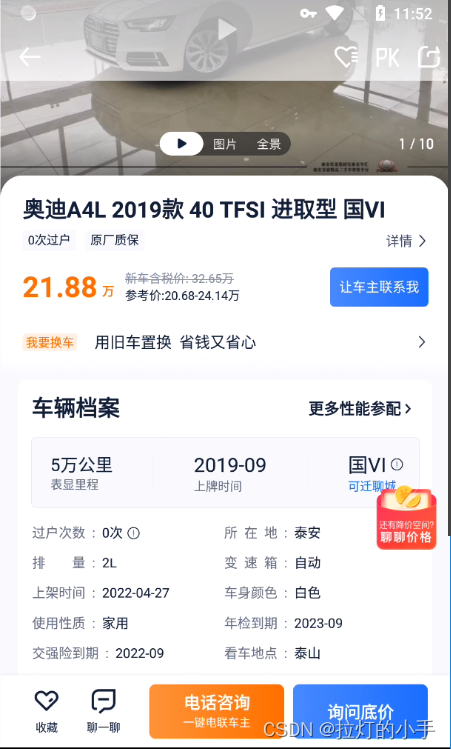
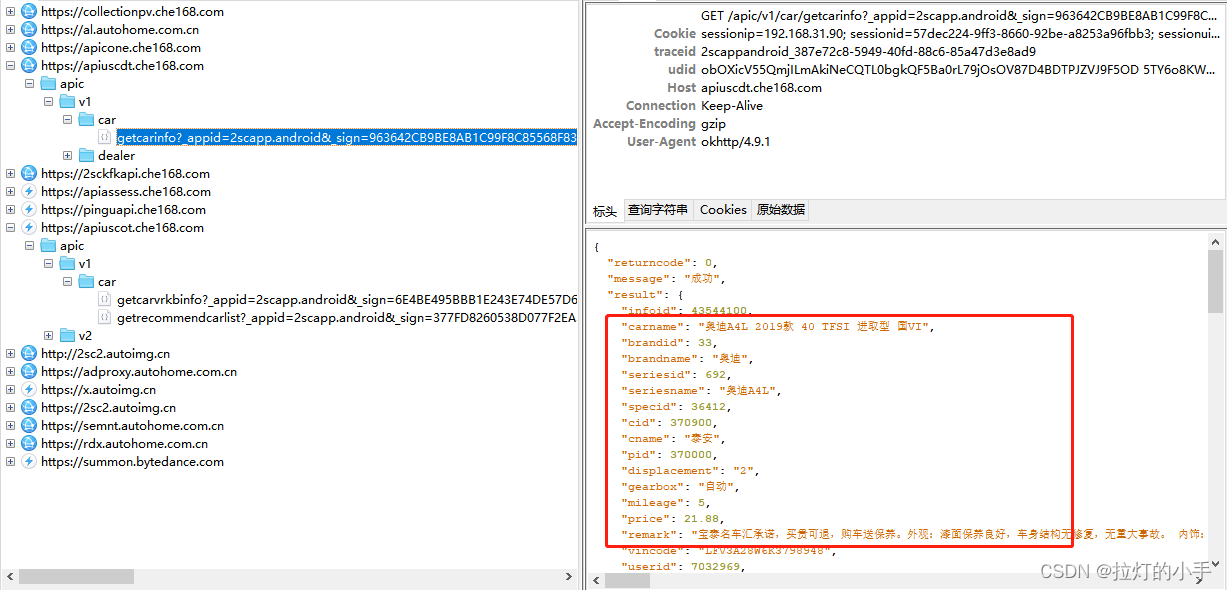
拿到数据接口就简单了,直接构造请求保存数据即可
获取车辆信息列表
    def _get_car_list(self, _url: str):

        """

        获取二手车信息列表

        """

        res = self._parse_url(_url=_url)

        ret = res.text  # 解析获得字符串类型数据

        result = etree.HTML(ret)  # 转换数据类型为HTML,方便使用xpath

        url_list = result.xpath('//*[@id="goodStartSolrQuotePriceCore0"]/ul/li/a/@href')

        if not url_list:

            print('获取完成!')

            return

        for i in url_list:

            # 有些车型url直接是带域名的

            if 'www.che168.com/' in i:

                yield 'https://' + i[2:]

            else:

                yield 'https://www.che168.com' + i
获取车辆详情信息
    def _get_car_info(self, _url: str):

        """

        获取车辆详情信息

        """

        res = self._parse_url(_url=_url)

        ret = res.text  # 解析获得字符串类型数据

        result = etree.HTML(ret)  # 转换数据类型为HTML,方便使用xpath

        # 标题

        title = result.xpath('//div[@class="car-box"]/h3//text()')

        title = title[1].strip() if len(title) > 1 else title[0].strip()

        # 上牌时间

        play_time = result.xpath('//*[@id="nav1"]/div[1]/ul[1]/li[1]/text()')

        play_time = play_time[0].strip() if play_time else '-'

        # 表显里程

        display_mileage = result.xpath('//*[@id="nav1"]/div[1]/ul[1]/li[2]/text()')

        display_mileage = display_mileage[0].strip() if display_mileage else '-'

        # 变速箱

        gearbox = result.xpath('//*[@id="nav1"]/div[1]/ul[1]/li[3]/text()')

        gearbox = gearbox[0].strip() if gearbox else '-'

        # 排放标准

        emission_standards = result.xpath('//*[@id="nav1"]/div[1]/ul[1]/li[4]/text()')

        emission_standards = emission_standards[0].strip() if emission_standards else '-'

        # 排量

        displacement = result.xpath('//*[@id="nav1"]/div[1]/ul[1]/li[5]/text()')

        displacement = displacement[0].strip() if displacement else '-'

        # 发布时间

        release_time = result.xpath('//*[@id="nav1"]/div[1]/ul[1]/li[6]/text()')

        release_time = release_time[0].strip() if release_time else '-'

        # 年检到期

        annual_inspection_expires = result.xpath('//*[@id="nav1"]/div[1]/ul[2]/li[1]/text()')

        annual_inspection_expires = annual_inspection_expires[0].strip() if annual_inspection_expires else '-'

        # 保险到期

        insurance_expires = result.xpath('//*[@id="nav1"]/div[1]/ul[2]/li[2]/text()')

        insurance_expires = insurance_expires[0].strip() if insurance_expires else '-'

        # 质保到期

        warranty_expires = result.xpath('//*[@id="nav1"]/div[1]/ul[2]/li[3]/text()')

        warranty_expires = warranty_expires[0].strip() if warranty_expires else '-'

        # 过户次数

        number_of_transfers = result.xpath('//*[@id="nav1"]/div[1]/ul[2]/li[5]/text()')

        number_of_transfers = number_of_transfers[0].strip() if number_of_transfers else '-'

        # 所在地

        location = result.xpath('//*[@id="nav1"]/div[1]/ul[2]/li[6]/text()')

        location = location[0].strip() if location else '-'

        # 发动机

        engine = result.xpath('//*[@id="nav1"]/div[1]/ul[3]/li[1]/text()')

        engine = engine[0].strip() if engine else '-'

        # 车辆级别

        vehicle = result.xpath('//*[@id="nav1"]/div[1]/ul[3]/li[2]/text()')

        vehicle = vehicle[0].strip() if vehicle else '-'

        # 车身颜色

        car_color = result.xpath('//*[@id="nav1"]/div[1]/ul[3]/li[3]/text()')

        car_color = car_color[0].strip() if car_color else '-'

        # 燃油标号

        fuel_label = result.xpath('//*[@id="nav1"]/div[1]/ul[3]/li[4]/text()')

        fuel_label = fuel_label[0].strip() if fuel_label else '-'

        # 驱动方式

        drive_mode = result.xpath('//*[@id="nav1"]/div[1]/ul[3]/li[5]/text()')

        drive_mode = drive_mode[0].strip() if drive_mode else '-'

        data = [[title, play_time, display_mileage, gearbox, emission_standards, displacement, release_time, annual_inspection_expires,

                 insurance_expires, warranty_expires, number_of_transfers, location, engine, vehicle, car_color, fuel_label, drive_mode, _url]]

        print(data)

        self._save_csv(data=data)
资源下载
https://download.csdn.net/download/qq_38154948/85358088
| 本文仅供学习交流使用,如侵立删! |
【原创】Python 二手车之家车辆档案数据爬虫的更多相关文章
- selenuim自动化爬取汽车在线谷米爱车网车辆GPS数据爬虫
#为了实时获取车辆信息,以及为了后面进行行使轨迹绘图,写了一个基于selelnium的爬虫爬取了车辆gps数据. #在这里发现selenium可以很好的实现网页解析和处理js处理 #导包 import ...
- Python爬取6271家死亡公司数据,一眼看尽十年创业公司消亡史!
小五利用python将其中的死亡公司数据爬取下来,借此来观察最近十年创业公司消亡史. 获取数据 F12,Network查看异步请求XHR,翻页. 成功找到返回json格式数据的url, 很多人 ...
- Python爬取6271家死亡公司数据,看十年创业公司消亡史
前言 文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. 作者: 朱小五 凹凸玩数据 PS:如有需要Python学习资料的小伙伴可以加 ...
- TOP100summit:【分享实录】链家网大数据平台体系构建历程
本篇文章内容来自2016年TOP100summit 链家网大数据部资深研发架构师李小龙的案例分享. 编辑:Cynthia 李小龙:链家网大数据部资深研发架构师,负责大数据工具平台化相关的工作.专注于数 ...
- python3 爬取汽车之家所有车型数据操作步骤(更新版)
题记: 互联网上关于使用python3去爬取汽车之家的汽车数据(主要是汽车基本参数,配置参数,颜色参数,内饰参数)的教程已经非常多了,但大体的方案分两种: 1.解析出汽车之家某个车型的网页,然后正则表 ...
- 利用Python进行数据分析(12) pandas基础: 数据合并
pandas 提供了三种主要方法可以对数据进行合并: pandas.merge()方法:数据库风格的合并: pandas.concat()方法:轴向连接,即沿着一条轴将多个对象堆叠到一起: 实例方法c ...
- 使用 Python 抓取欧洲足球联赛数据
Web Scraping在大数据时代,一切都要用数据来说话,大数据处理的过程一般需要经过以下的几个步骤 数据的采集和获取 数据的清洗,抽取,变形和装载 数据的分析,探索和预测 ...
- 如何用python抓取js生成的数据 - SegmentFault
如何用python抓取js生成的数据 - SegmentFault 如何用python抓取js生成的数据 1赞 踩 收藏 想写一个爬虫,但是需要抓去的的数据是js生成的,在源代码里看不到,要怎么才能抓 ...
- [原创].NET 分布式架构开发实战之三 数据访问深入一点的思考
原文:[原创].NET 分布式架构开发实战之三 数据访问深入一点的思考 .NET 分布式架构开发实战之三 数据访问深入一点的思考 前言:首先,感谢园子里的朋友对文章的支持,感谢大家,希望本系列的文章能 ...
随机推荐
- 好客租房22-react组件的两种创建方式(类组件)
2.2使用类创建组件 类组件:使用ES6的class创建的组件 约定1:类组件必须以大写字母开头 约定2:类组件应该继承react.component父类 从中可以使用父类的方法和属性 约定3:组件必 ...
- 每天一个 HTTP 状态码 203
203 Non-Authoritative Information 203 Non-Authoritative Information 'Non-Authoritative Informative' ...
- Three.js 打造缤纷夏日3D梦中情岛 🌊
声明:本文涉及图文和模型素材仅用于个人学习.研究和欣赏,请勿二次修改.非法传播.转载.出版.商用.及进行其他获利行为. 背景 深居内陆的人们,大概每个人都有过大海之梦吧.夏日傍晚在沙滩漫步奔跑:或是在 ...
- 常用排序算法(一)-java实现
排序算法总结 1.十大经典算法及性能 2.具体排序算法 1.冒泡排序 循环过程中比较相邻两个数大小,通过交换正确排位,循环整个数组即可完成排序 图片演示 代码实现Java //冒泡排序 public ...
- 技术分享 | Appium环境安装与架构介绍
原文链接 Appium架构 Appium 设计哲学 不需要为了自动化而重新编译或修改被测应用 不应该让移动端自动化测试限定在某种语言或者某个具体的框架 不要为了移动端的自动化测试而重新造轮子 移动端自 ...
- 七、服务器硬件及RAID配置实战
一.RAID磁盘阵列介绍 磁盘阵列的全名(Redundant Arrays of Inexpensive Disk,RAID),中文简称是独立冗余磁盘阵列.冗余(如果磁盘出现故障,可以保证数据不丢) ...
- 【SpringBoot】快速入门
博客主页:准Java全栈开发工程师 00年出生,即将进入职场闯荡,目标赚钱,可能会有人觉得我格局小.觉得俗,但不得不承认这个世界已经不再是以一条线来分割的平面,而是围绕财富旋转的球面,成为有钱人不是为 ...
- JS:typeof
想要弄明白某一个变量中保存的数据到底是什么数据类型,我们可以使用到typeof操作符. typeof操作符:检测变量的数据类型. 看例子! var a = "abc"; var b ...
- 基于Mybatis插件方式实现数据脱敏处理
一.项目介绍 1.项目背景 有时候我们数据库中存储一些敏感的信息比如手机号.银行卡号,我们希望我们查询出来的的时候对一些敏感信息做一些脱敏处理. 当面项目是基于自定义Mybatis插件方式实现数据脱敏 ...
- key可重复的Map
在正常的map操作中,key是不能重复的,如果希望key的内容可以重复,可以用IdentityHashMap 举个栗子 输出结果: public static void main(String[] a ...