
scrapy抓取拉勾网职位信息(一)——scrapy初识及lagou爬虫项目建立
本次以scrapy抓取拉勾网职位信息作为scrapy学习的一个实战演练
python版本:3.7.1
框架:scrapy(pip直接安装可能会报错,如果是vc++环境不满足,建议直接安装一个visual studio一劳永逸,如果报错缺少前置依赖,就先安装依赖)
本篇主要对scrapy生成爬虫项目做一个基本的介绍
tips:在任意目录打开cmd的方式可以使用下面这两种方式
- shift + 右键打开cmd(window10的powershell你可以简单理解为cmd升级版)
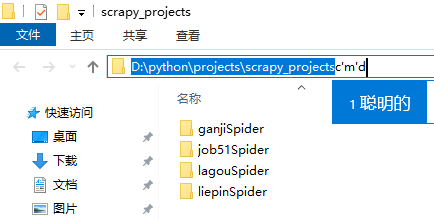
- 在路径框直接输入cmd,回车
1、建立一个scrapy项目
在cmd窗口中输入:scrapy startproject lagou,这样就创建了一个项目文件夹,文件夹的名字是lagou
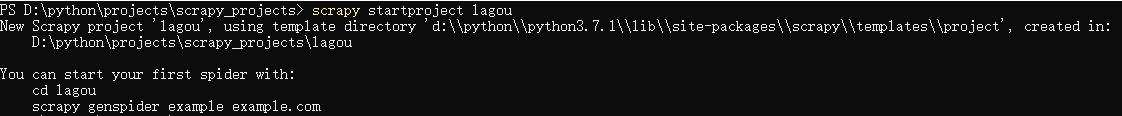
新生成一个scrapy项目,但是目前里面还没有一个爬虫,用pycharm打开外层lagou文件夹看看

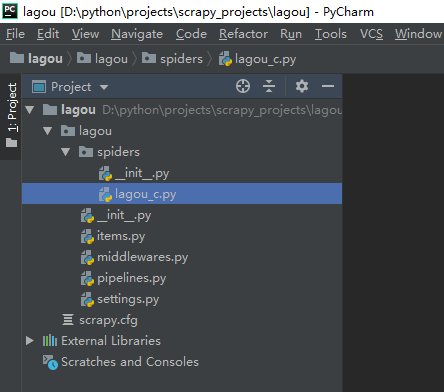
从结构可以看出生成的lagou项目文件夹里面生成了一些新的文件夹和文件,
__init__.py:两个文件内容都是空的,存在的唯一目的就是让它所在的文件夹成为一个python包。
items.py:主要是用来定义要提取的字段的,比如我们要提取招聘职位的名称,薪酬,都需要对字段进行定义
middlewares.py:中间件,包括spider middleware和downloader middleware,前者可以对请求进行修改(比如加入代理,设置UA都可以在这里进行),后者可以对下载的页面进行修改
pipelines.py:主要是用来进行数据清洗,存储的
settings.py:爬虫项目的全局配置,比如全局的UA,是否开启middlewares中间键,设置延迟等
2、生成一个爬虫(注意:一个项目文件夹下面可以有多个爬虫)
首先进入到外层的lagou文件夹下
cd lagou
查看有哪些爬虫模板命令:scrapy genspider -l
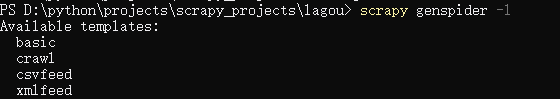
一般用的比较多是basic和crawl两种,basic适合主页比较简单,url基本一致的情况,crawl适合有多种标签类别的网站
针对拉勾网,这里我们选用crawl模板生成爬虫,爬虫名称是lagou_c,爬取的首页url是lagou.com
scrapy genspider -t crawl lagou_c lagou.com (-t crawl代表以crawl模板生成爬虫,如果不加这个参数以basic模板生成的爬虫scrapy genspider lagou_c lagou.com)
注意:爬虫名称一般设置为要爬取的url名称,如lagou.com,设置为lagou为爬虫名,但爬虫名和项目名不能重复,我这里修改爬虫名为lagou_c

这样我们就建立了一个名称为lagou_c的爬虫项目,再次用pycharm打开可以看到多了一个lagou_c.py文件,这个文件就是爬虫的入口,它主要是用来产生新的请求和对返回的response进行解析。
scrapy抓取拉勾网职位信息(一)——scrapy初识及lagou爬虫项目建立的更多相关文章
- scrapy抓取拉勾网职位信息(三)——爬虫rules内容编写
在上篇中,分析了拉勾网需要跟进的页面url,本篇开始进行代码编写. 在编写代码前,需要对scrapy的数据流走向有一个大致的认识,如果不是很清楚的话建议先看下:scrapy数据流 本篇目标:让拉勾网爬 ...
- scrapy抓取拉勾网职位信息(四)——对字段进行提取
上一篇中已经分析了详情页的url规则,并且对items.py文件进行了编写,定义了我们需要提取的字段,本篇将具体的items字段提取出来 这里主要是涉及到选择器的一些用法,如果不是很熟,可以参考:sc ...
- scrapy抓取拉勾网职位信息(二)——拉勾网页面分析
网站结构分析: 四个大标签:首页.公司.校园.言职 我们最终是要得到详情页的信息,但是从首页的很多链接都能进入到一个详情页,我们需要对这些标签一个个分析,分析出哪些链接我们需要跟进. 首先是四个大标签 ...
- scrapy抓取拉勾网职位信息(八)——使用scrapyd对爬虫进行部署
上篇我们实现了分布式爬取,本篇来说下爬虫的部署. 分析:我们上节实现的分布式爬虫,需要把爬虫打包,上传到每个远程主机,然后解压后执行爬虫程序.这样做运行爬虫也可以,只不过如果以后爬虫有修改,需要重新修 ...
- scrapy抓取拉勾网职位信息(六)——反爬应对(随机UA,随机代理)
上篇已经对数据进行了清洗,本篇对反爬虫做一些应对措施,主要包括随机UserAgent.随机代理. 一.随机UA 分析:构建随机UA可以采用以下两种方法 我们可以选择很多UserAgent,形成一个列表 ...
- scrapy抓取拉勾网职位信息(七)——数据存储(MongoDB,Mysql,本地CSV)
上一篇完成了随机UA和随机代理的设置,让爬虫能更稳定的运行,本篇将爬取好的数据进行存储,包括本地文件,关系型数据库(以Mysql为例),非关系型数据库(以MongoDB为例). 实际上我们在编写爬虫r ...
- scrapy抓取拉勾网职位信息(七)——实现分布式
上篇我们实现了数据的存储,包括把数据存储到MongoDB,Mysql以及本地文件,本篇说下分布式. 我们目前实现的是一个单机爬虫,也就是只在一个机器上运行,想象一下,如果同时有多台机器同时运行这个爬虫 ...
- scrapy抓取拉勾网职位信息(五)——代码优化
上一篇我们已经让代码跑起来,各个字段也能在控制台输出,但是以item类字典的形式写的代码过于冗长,且有些字段出现的结果不统一,比如发布日期. 而且后续要把数据存到数据库,目前的字段基本都是string ...
- 【图文详解】scrapy爬虫与动态页面——爬取拉勾网职位信息(2)
上次挖了一个坑,今天终于填上了,还记得之前我们做的拉勾爬虫吗?那时我们实现了一页的爬取,今天让我们再接再厉,实现多页爬取,顺便实现职位和公司的关键词搜索功能. 之前的内容就不再介绍了,不熟悉的请一定要 ...
随机推荐
- Java 异常(Java Exception)
Java异常 异常指不期而至的各种状况,如:文件找不到.网络连接失败.非法参数等.异常是一个事件,它发生在程序运行期间,干扰了正常的指令流程.Java通 过API中Throwable类的众多子类 ...
- spoj104 highways 生成树计数(矩阵树定理)
https://blog.csdn.net/zhaoruixiang1111/article/details/79185927 为了学一个矩阵树定理 从行列式开始学(就当提前学线代了.. 论文生成树的 ...
- 【51NOD-0】1137 矩阵乘法
[算法]简单数学 [题解] 对于A*B=C C中第i行第j列的数字由A中第i行和B中的j列的数字各自相乘后相加得到. 所以两个矩阵能相乘要求A的列数等于B的行数,复杂度为O(n3). #include ...
- 如何设计一个优雅健壮的Android WebView?(下)
转:如何设计一个优雅健壮的Android WebView?(下) 前言 在上文<如何设计一个优雅健壮的Android WebView?(上)>中,笔者分析了国内WebView的现状,以及在 ...
- 基本控件文档-UIKit结构图---iOS-Apple苹果官方文档翻译
本系列所有开发文档翻译链接地址:iOS7开发-Apple苹果iPhone开发Xcode官方文档翻译PDF下载地址 UIKit结构图 //转载请注明出处--本文永久链接:http://www.cnbl ...
- Intersecting Lines (计算几何基础+判断两直线的位置关系)
题目链接:http://poj.org/problem?id=1269 题面: Description We all know that a pair of distinct points on a ...
- JAVA list 列表 字典 dict
import java.util.ArrayList; import java.util.HashMap; import java.util.Map; import java.util.Set; pu ...
- bzoj 1503 平衡树
我们可以用一颗平衡树维护每个人的工资,因为工资的变化会影响到后面所有的人,所以我们打一个标签,向平衡树里插入的时候减去这个标签的值,这样代表改变了之后的零点,,这样维护这个标签就好了,输出的时候要加上 ...
- hdu 1233 还是畅通工程 (最小生成树)
题目链接:http://acm.hdu.edu.cn/showproblem.php?pid=1233 还是畅通工程 Time Limit: 4000/2000 MS (Java/Others) ...
- 上传漏洞新姿势(限Linux)
服务器:Linux当前环境:nginx/1.4.7PHP版本:PHP Version 7.0.0 上传情况简介:上传 111.jpg111 确实可以成功的但是上传 1.php.jpg1111.1 ...