
Gradient Optimization
Gradient Optimization
Gradient Descent
- Batch Gradient Descent
- Mini-Batch Gradient Descent
- Stochastic Gradient Descent
Mini-Batch Gradient Descent
- 参数
- Mini-Batch Size: 一个Batch样本所含的样本数
- 参数效果
- 通过设置Mini-Batch Size可以将Mini-Batch转为Stochastic Gradient Descent和Bath Gradient Descent
- 当Mini-Batch Size == m时, Mini-Batch Gradient Descent为Batch Gradient Descent; 当Mini-Batch Size == 1时, Mini-Batch Gradient Descent为Stochastic Gradient Descent; 一般Mini-Batch Size的大小为2的幂次方, 主要考虑到与计算机内存对齐, 一般Mini-Batch Size设置在64-512
- 特点对比
- Batch Gradient Descent: 当数据量大的时候程序运行很慢
- Stochastic Gradient Descent: 一般不采用此方法, 因为此Gradient Descent方法每迭代一个样本就会更新参数\(W\)和\(b\), 在梯度下降的时候有很多噪音; 但是它可以应用到在线学习上
- Mini-Batch Gradient Descent: 当数据量较大的时候可以加快收敛速度, 但是当在梯度下降的时候, 容易产生震荡(oscillate), 如图

- 其中, +表示\(J_{min}\), 在使用Mini-Batch Gradient Descent的时候, 容易在数值方向产生震荡, 我们期望的是缩小竖直方向上的震荡, 在水平方向上加快收敛的速率, 对于这个问题, 解决方案是在Update Parameters的时候, 采用Momentum, RMSProp或者Adam的方法更新参数\(W\)和\(b\), 在下面就会提到
处理震荡
- 指数权重均值(Exponentially Weighted Average, 简称EMA), 后面的Momentum, RMSProp和Adam都需要EMA
- 以一年的中所有天数的温度为例, 如图
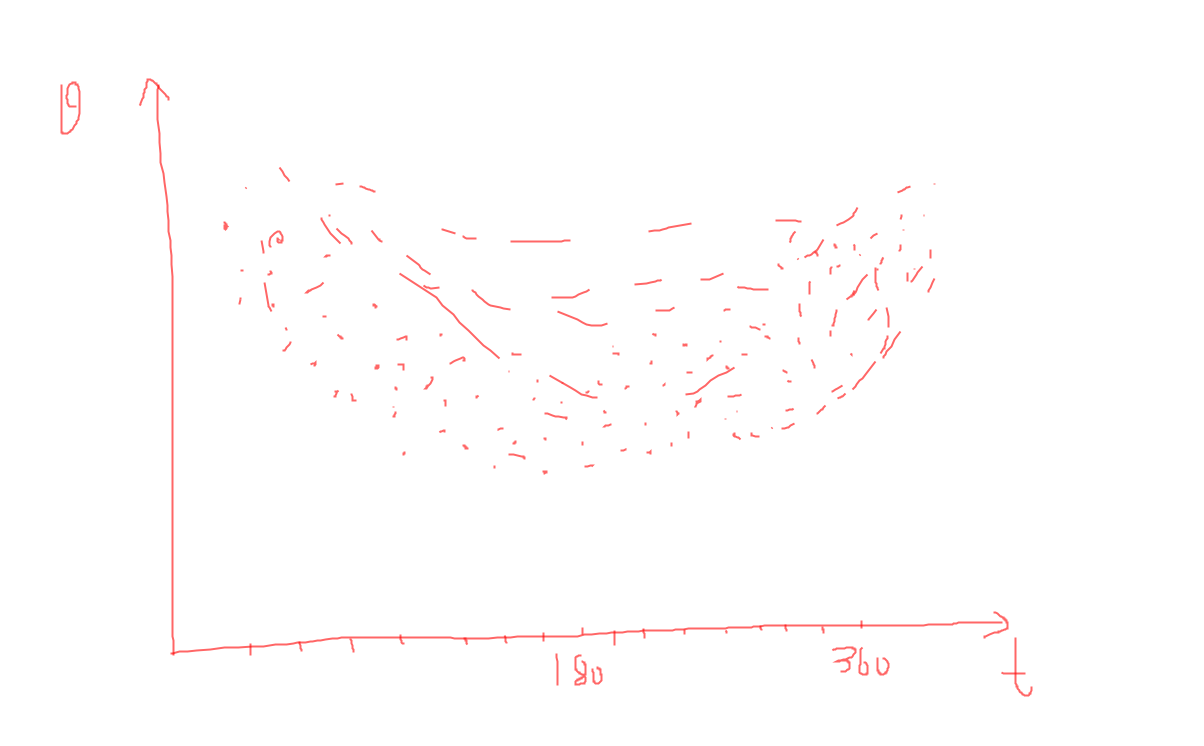
- 由上图可知, \(\theta\)为气温, \(t\)为天数, 总体来说中间时刻气温低一点, 两侧高一点
- 定义
- \(v_t=\beta{v_{t-1}}+(1-\beta)\theta_t\), 其中\(\beta\)为EMA中的一个参数, 一般他的取值范围在\(0.9\le \beta \le 0.99\); \(v_t\)表示的就是EMA; \(\theta_t\)为第\(t\)天的气温; \(\beta{v_t}\)表示的是前\(t\)天的关注度, 后面的\((1-\beta)\theta_t\)是对当前天气温的关注度, 最左侧的\(v_t\)才是我们对当前天的EMA; EMA公式有递归的感觉
Momentum
- 公式
- \(v_{dW^{[l]}}=\beta{v_{dW^{[l]}}}+(1-\beta)dW^{[l]}\), 其中, \(dW^{[l]}\)是第\(l\)层的梯度矩阵, 其他与EMA中的是一样的
- 返现与EMA中不同的是这里的\(\beta{v_{dW^{[l]}}}\)不是\(\beta{v_{dW^{[l-1]}}}\), 因为我们在实现该算法的时候采用先默认赋予0值, 再在每一次迭代时累加, 下面的RMSProp和Adam也是如此
- 更新参数
- \(W^{[l]}=W^{[l]}-\alpha{v_{dW^{[l]}}}\)
- 公式
RMSProp
- 公式
- \(s_{dW^{[l]}}=\beta{v_{dW^{[l]}}}+(1-\beta)(dW^{[l]})^2\), 其中, 与Momentum不同的就是此处\((dW^{[l]})^2\)
- 更新参数
- \(W^{[l]}=W^{[l]}-\alpha{dW^{[l]}\over{\sqrt{s_{dW^{[l]}}+\epsilon}}}\), 其中\(\epsilon \approx 10^{-8}\)
- 公式
Adam
- Adam算法是Momentum与RMSProp的结合
- 公式
- \(v_{dW^{[l]}}=\beta_1{v_{dW^{[l]}}}+(1-\beta_1)dW^{[l]}\)
- \(v^{correct}_{dW^{[l]}}={v_{dW^{[l]}}\over{1-(\beta_1)^t}}\), 其中t表示深度学习算法迭代到第t次, 这一步是\(v_{dW^{[l]}}\)的修正, 在后面即使使用\(v^{correct}_{dW^{[l]}}\)
- \(s_{dW^{[l]}}=\beta_2{v_dW^{[l]}}+(1-\beta_1)(dW^{[l]})^2\)
- \(s^{correct}_{dW^{[l]}}={s_{dW^{[l]}}}\over{1-(\beta_2)^t}\),其中t表示深度学习算法迭代到第t次, 这一步是\(s_{dW^{[l]}}\)的修正, 在后面即使使用\(s^{correct}_{dW^{[l]}}\)
- Adam结合了之前的Momentum与RMSProp算法, 同时增加了校正EMA的步骤, 因为在Momentum和RMSProp算法都有\(\beta\)和\(s\), 所有在这里为了区分, 使用了\(v\)与\(s\), \(\beta_1\)与\(\beta_2\)
- 更新参数
- \(W^{[l]}=W^{[l]}-\alpha{v_{dW^{[l]}}^{[l]}\over{\sqrt{s_{dW^{[l]}}+\epsilon}}}\), 其中\(\epsilon \approx 10^{-8}\)
使用代码实现的大致思路
- 选择Mini-Batch Gradient Descent
- Shuffle原始数据
- 选择Mini-Batch Size进行Gradient Descent
- 在迭代Update Parameters时, 先为Momentum, RMSProp或者Adam需要的\(v\), \(s\)变量赋予0值, 维度与对应的\(dW\)一致
- 迭代即可
学习率\(\alpha\)的衰减
- 一般来说我们只需要直接固定\(\alpha\)的值, 随后根据结果进行调整, 但是在数据量很大的时候就会比较浪费时间, 于是使用到了\(alpha\)的衰减
- 定义
- \(\alpha={1\over{1+decay\_rate\times{epoch}}}\alpha_0\)
Gradient Optimization的更多相关文章
- ( 转) Awesome Image Captioning
Awesome Image Captioning 2018-12-03 19:19:56 From: https://github.com/zhjohnchan/awesome-image-capti ...
- ICCV 2017论文分析(文本分析)标题词频分析 这算不算大数据 第一步:数据清洗(删除作者和无用的页码)
IEEE International Conference on Computer Vision, ICCV 2017, Venice, Italy, October 22-29, 2017. IEE ...
- 近年Recsys论文
2015年~2017年SIGIR,SIGKDD,ICML三大会议的Recsys论文: [转载请注明出处:https://www.cnblogs.com/shenxiaolin/p/8321722.ht ...
- SciPy和Numpy处理能力
1.SciPy和Numpy的处理能力: numpy的处理能力包括: a powerful N-dimensional array object N维数组: advanced array slicing ...
- [CS231n-CNN] Training Neural Networks Part 1 : activation functions, weight initialization, gradient flow, batch normalization | babysitting the learning process, hyperparameter optimization
课程主页:http://cs231n.stanford.edu/ Introduction to neural networks -Training Neural Network ________ ...
- (转) An overview of gradient descent optimization algorithms
An overview of gradient descent optimization algorithms Table of contents: Gradient descent variants ...
- An overview of gradient descent optimization algorithms
原文地址:An overview of gradient descent optimization algorithms An overview of gradient descent optimiz ...
- 【论文翻译】An overiview of gradient descent optimization algorithms
这篇论文最早是一篇2016年1月16日发表在Sebastian Ruder的博客.本文主要工作是对这篇论文与李宏毅课程相关的核心部分进行翻译. 论文全文翻译: An overview of gradi ...
- [CS231n-CNN] Linear classification II, Higher-level representations, image features, Optimization, stochastic gradient descent
课程主页:http://cs231n.stanford.edu/ loss function: -Multiclass SVM loss: 表示实际应该属于的类别的score.因此,可以发现,如果实际 ...
随机推荐
- (原创)Log4Net 在多层项目中的使用小记
这几天刚好在调整一个项目,把一些自己不是很清楚的东西先试验一下,这篇文章主要是对我在项目中需要使用Log4Net的一些记录.网上有很多相关的教程,但是各有各的说法,我结合我自己这个项目的需要,首先,项 ...
- [JQuery]ScrollMe滚动特效插件
最近考完试,一切顺利,昨晚闲着无聊把最近要用的一个插件翻译了一下:ScrollMe. (╯‵□′)╯︵┻━┻地址请戳: /* ScrollMe -李明夕翻译(╯‵□′)╯︵┻━┻ */ ScrollM ...
- 数独高阶技巧入门之七——AIC & Nice Loop
AIC(交替推理链,Alternate Inference Chain) 在简单异数链一文中我们介绍过XY-Chain技法,AIC可以看作是XY-Chain的扩展.有别于XY-Chain仅局限于双值格 ...
- C#字典 Dictionary<Tkey,Tvalue> 之线程安全问题 ConcurrentDictionary<Tkey,Tvalue> 多线程字典
ConcurrentDictionary<Tkey,Tvalue> Model #region 程序集 mscorlib, Version=4.0.0.0, Culture=neutra ...
- Ray tracing performance benchmark
accel. avg size 3.14accel. avg depth 16.15accel. max size 8accel. max depth 20accel. GPIT 3.00 MB tr ...
- MySQL不带where条件的UPDATE和DELETE 限制操作说明
本文来自 网易云社区 . 数据安全是业务的基石,但是DBA 总会遇到救火情况,业务误删除全表或者误更新错全表业务数据,导致服务不可用 sql_safe_updates参数可以限制不带where条件的u ...
- 514. Freedom Trail
In the video game Fallout 4, the quest "Road to Freedom" requires players to reach a metal ...
- CVE-2012-2122-Mysql身份认证漏洞及利用
一.漏洞简介 当连接MariaDB/MySQL时,输入的密码会与期望的正确密码比较,由于不正确的处理,会导致即便是memcmp()返回一个非零值,也会使MySQL认为两个密码是相同的.按照公告说法大约 ...
- SSO单点登录入门
1,SSO简介 SSO(Single Sign-On,单点登录)是身份管理中的一部分.SSO 的一种较为通俗的定义是:SSO 是指访问同一服务器不同应用中的受保护资源的同一用户,只需要登录一次,即通过 ...
- jquery源码解析:jQuery延迟对象Deferred(工具方法)详解2
请接着上一课继续看. $.Deferred()方法中,有两个对象,一个是deferred对象,一个是promise对象. promise对象有以下几个方法:state,always,then,prom ...