
[CS231n-CNN] Linear classification II, Higher-level representations, image features, Optimization, stochastic gradient descent
课程主页:http://cs231n.stanford.edu/
loss function:
-Multiclass SVM loss:
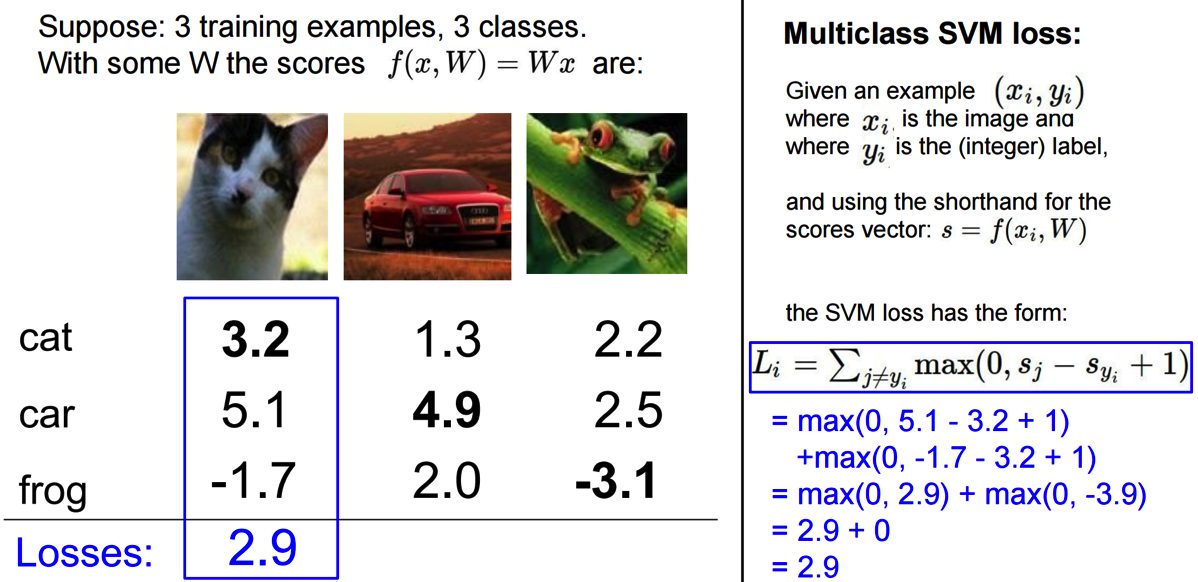
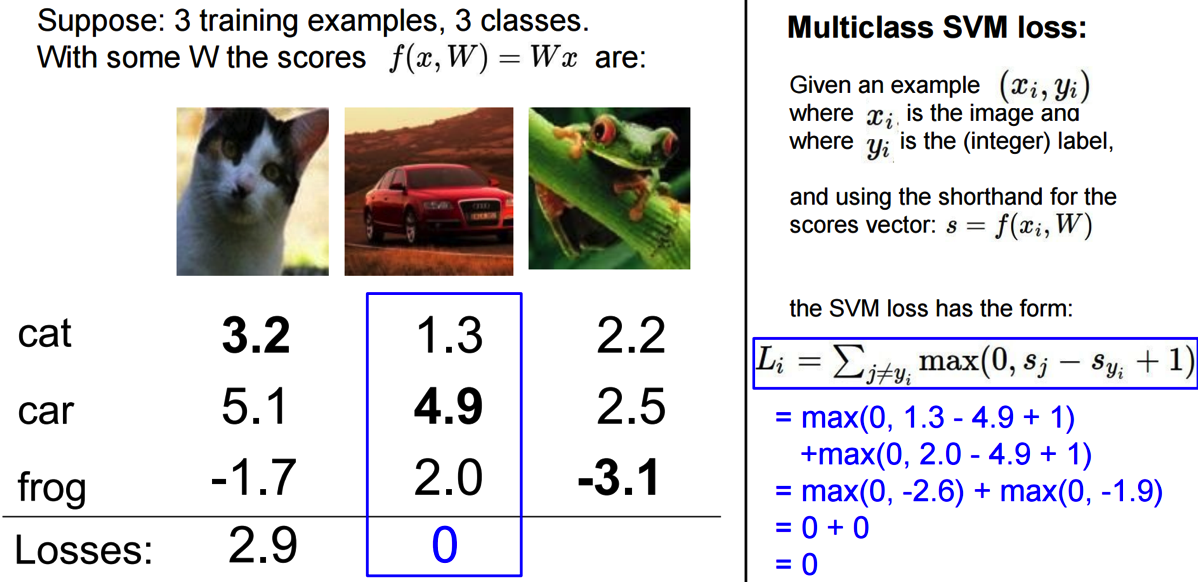
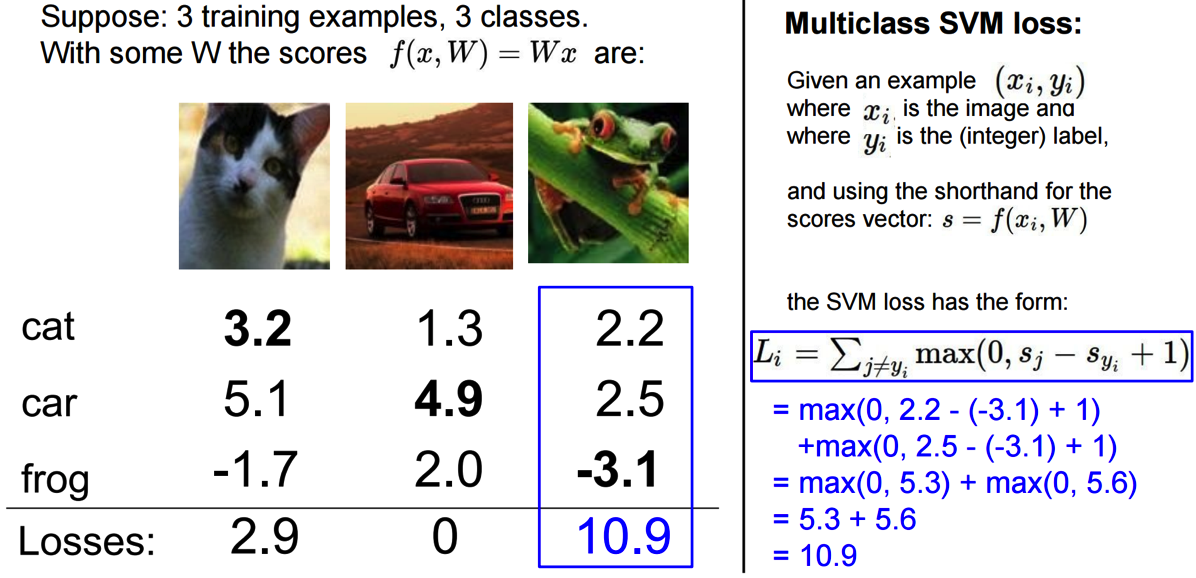
 表示实际应该属于的类别的score。因此,可以发现,如果实际所属的类别score越小,那么loss function算出来的就会越大,这样才符合常理。
最后取平均:
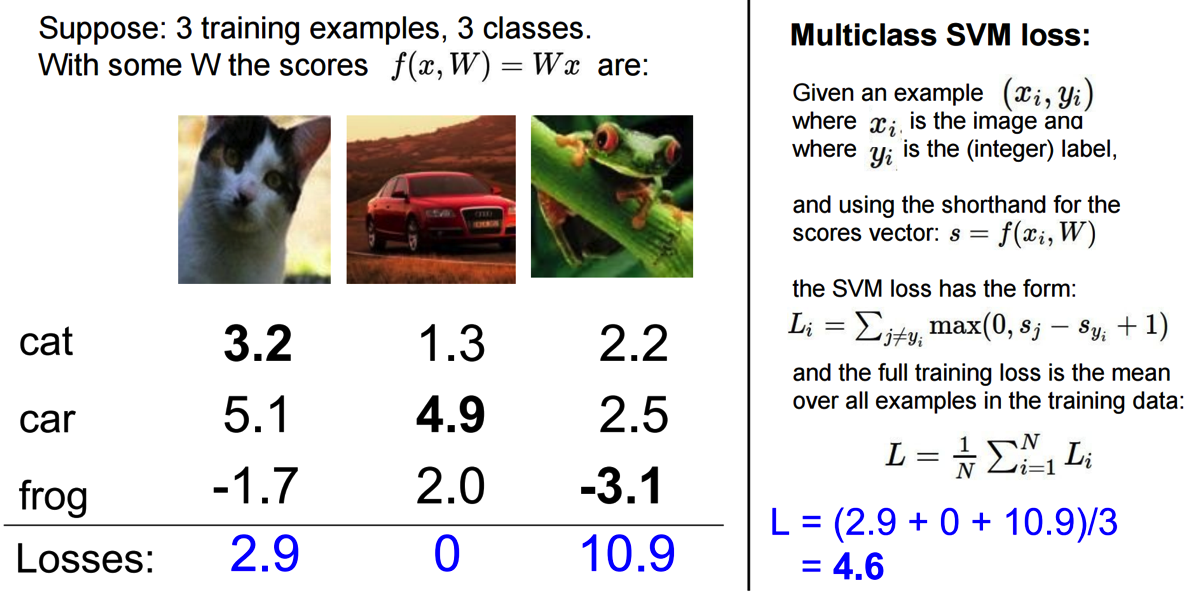
*问题:
1⃣️:
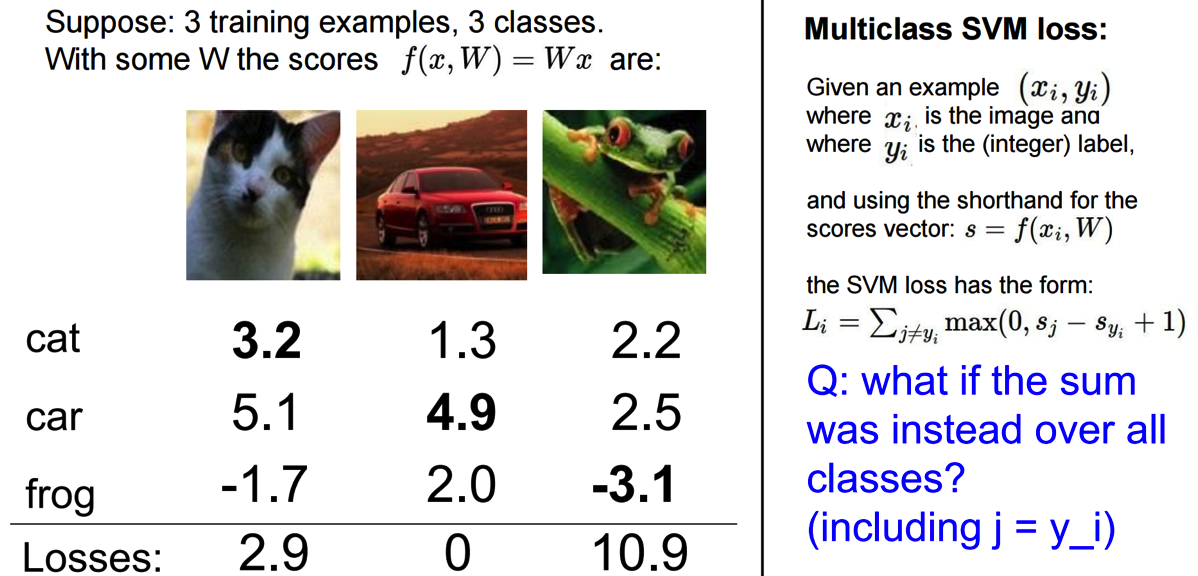
因为include j=y_i其实就是最后加上常数1,对结果没有任何影响。
2⃣️:
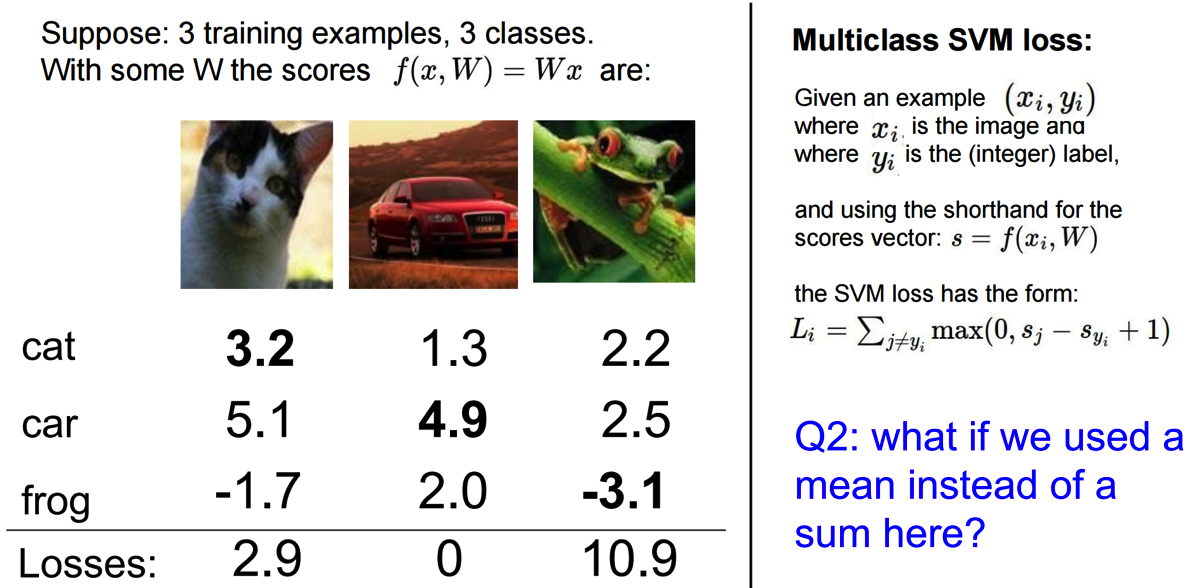
因为mean和sum成正比,因此对最后的结果都没影响,所以为了方便计算,无需求mean。
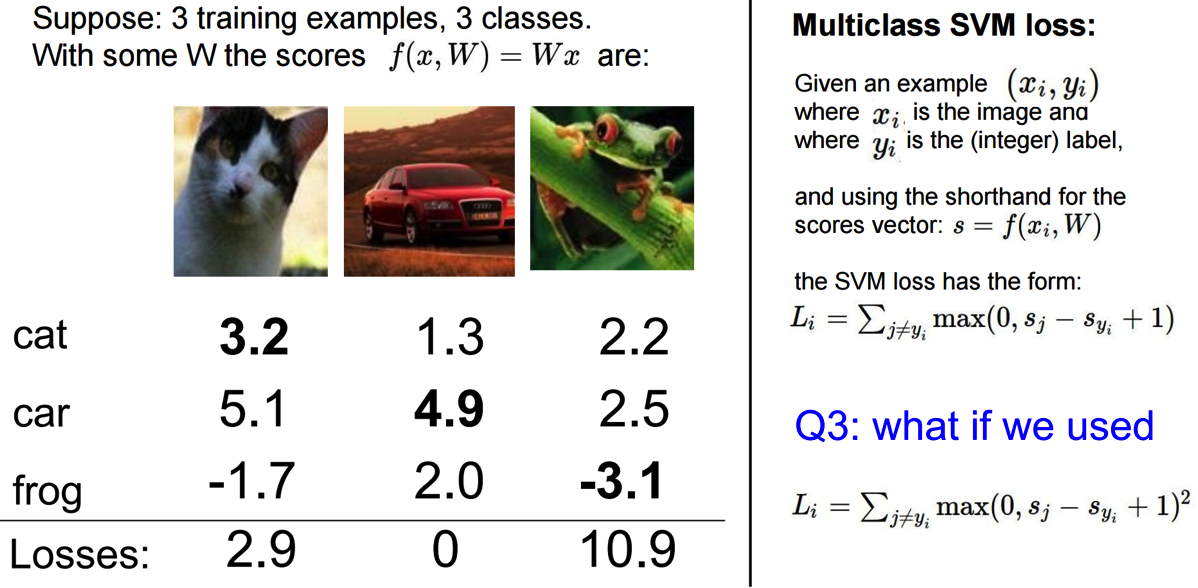
这两种loss function结果会有所区别,但两者都可以。第一种更常见。
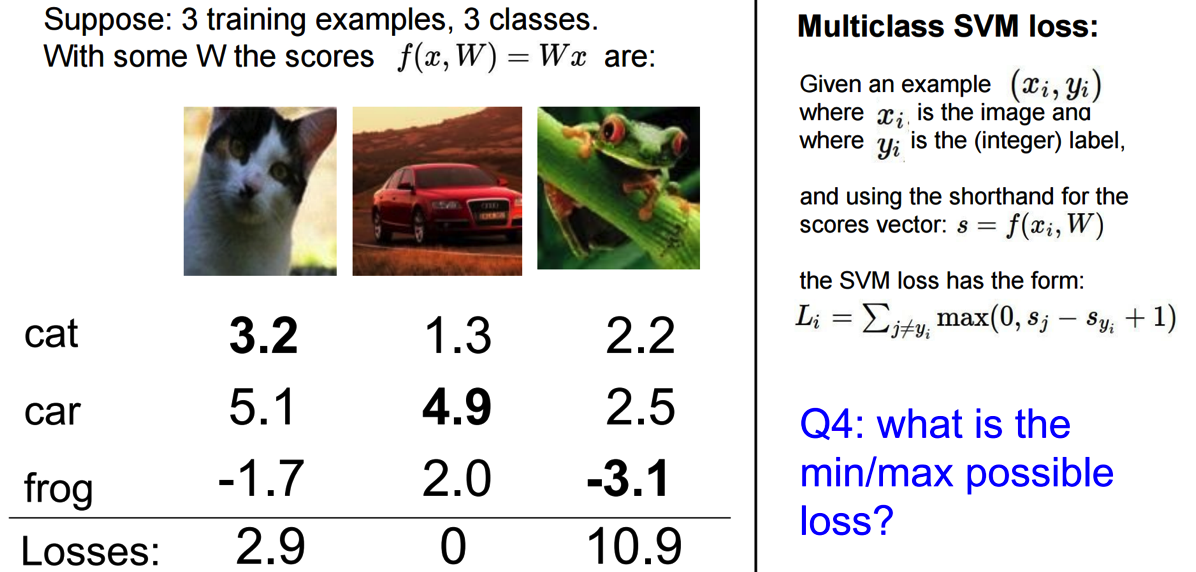
min:0(最完美的)
max:正无穷(最不完美的)
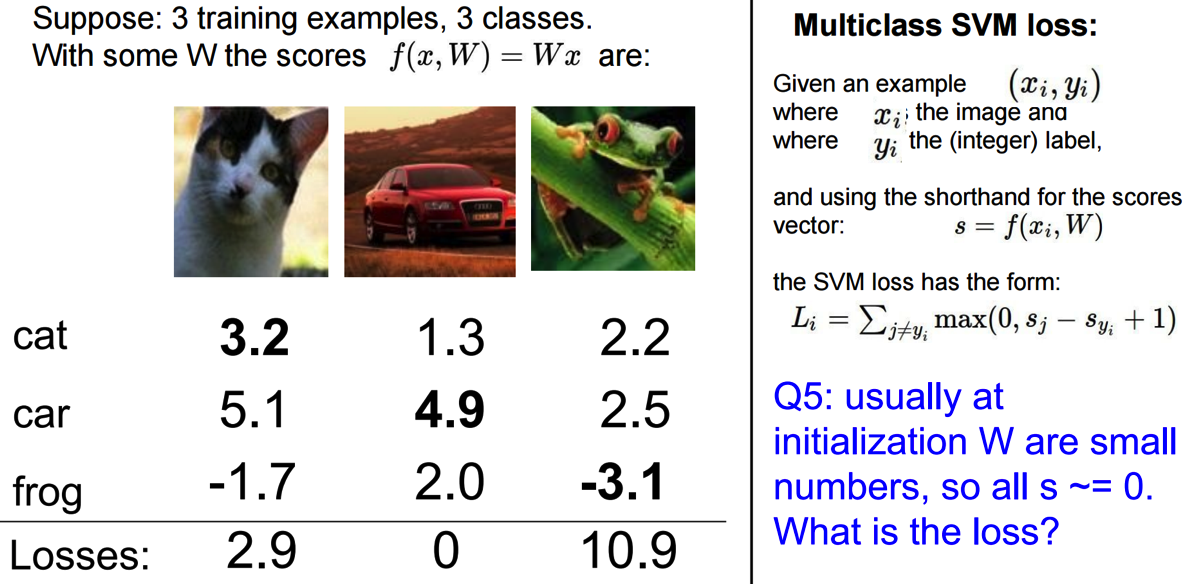
 和
 都很小,所以结果会是number_of_classes - 1.
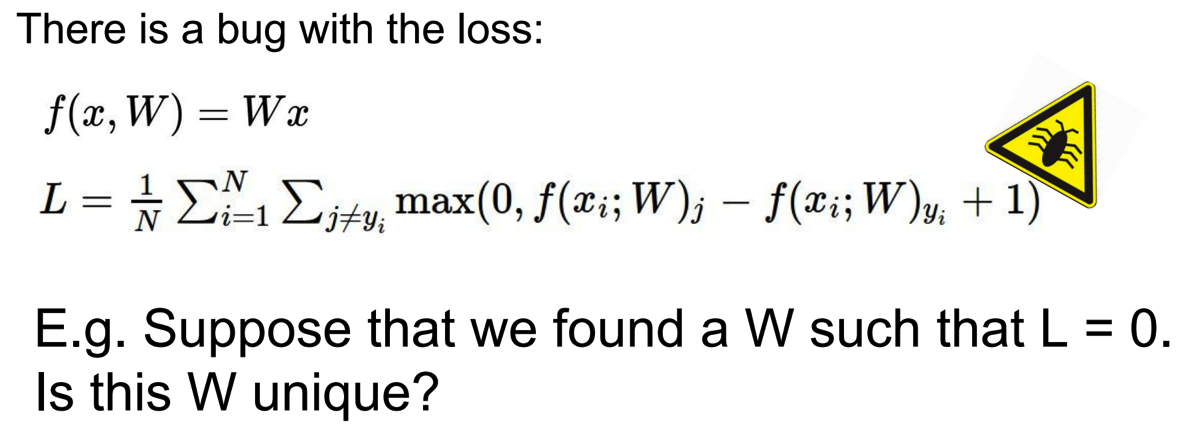
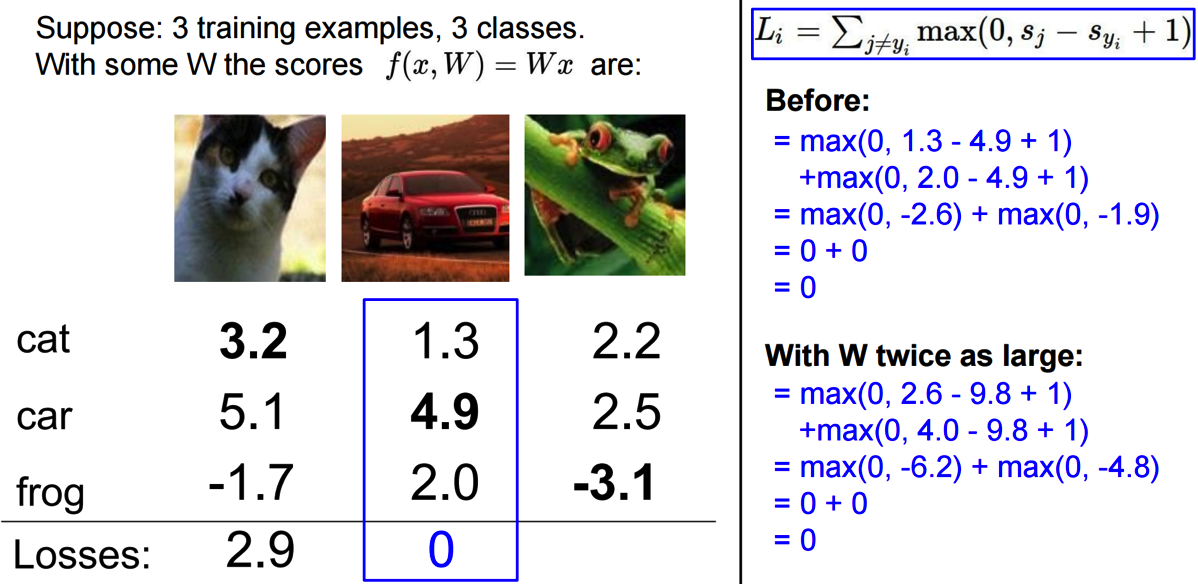
如果每个的都分队的话,w无论乘以多少倍(w不唯一),结果都是一样的。
在w不唯一的情况下,我们如何得到我们最想要的一组w的值呢?因此,我们需要一种方法可以measure niceness of w.
正则化的目的是防止过拟合。
-引出:Weight Regularisation
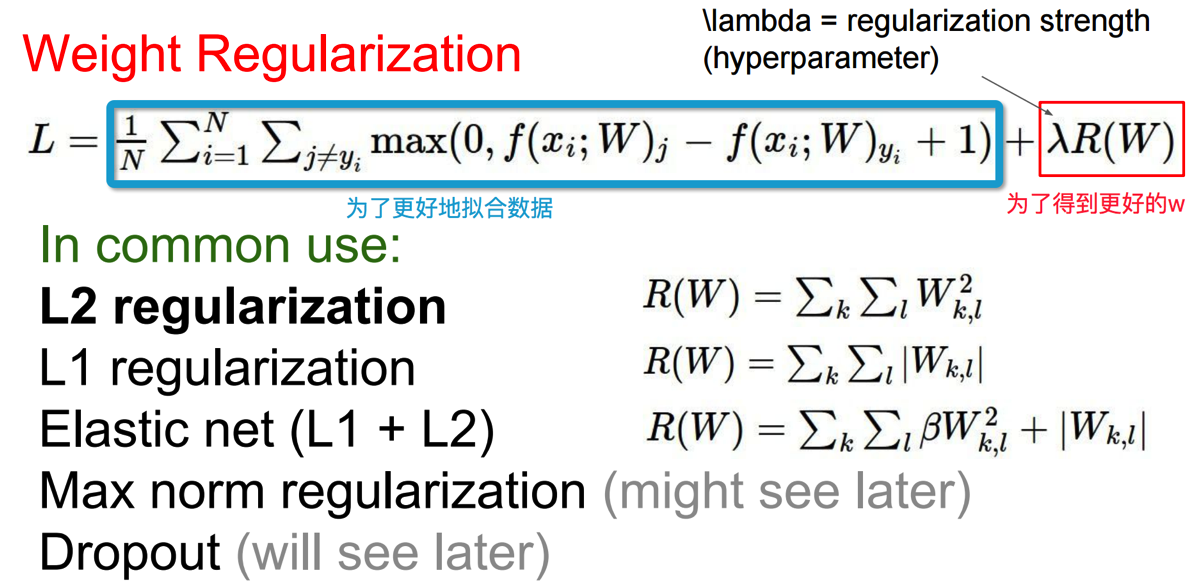
我们不仅仅想要w能够很好的拟合数据,而且还想得到更好的w。
motivation:
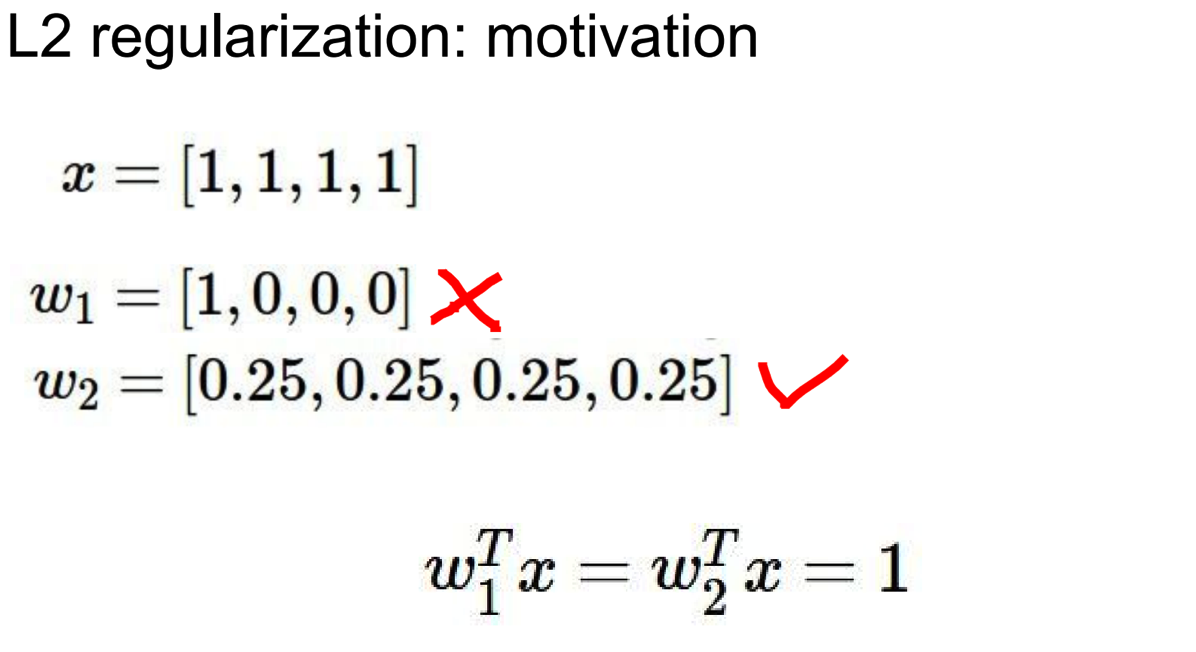
w1只与一个feature有关,忽略了其他的feature。虽然w1和w2的值相同。(详细的介绍参考cs229)
__________________________________________________________________________________________________________
-Softmax function(a different form loss function: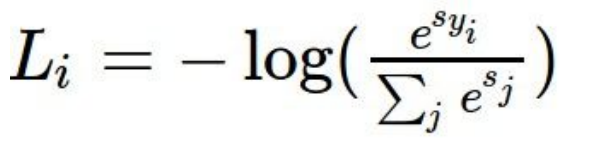 )
(之前用的是svm,即: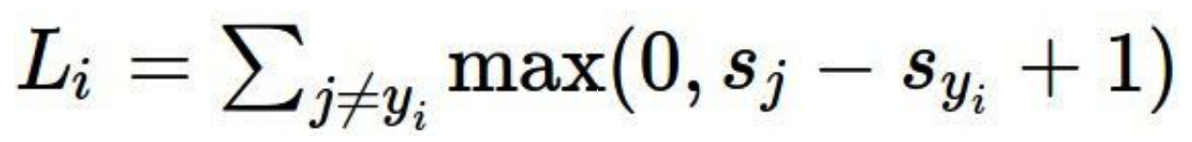 )
计算方法:
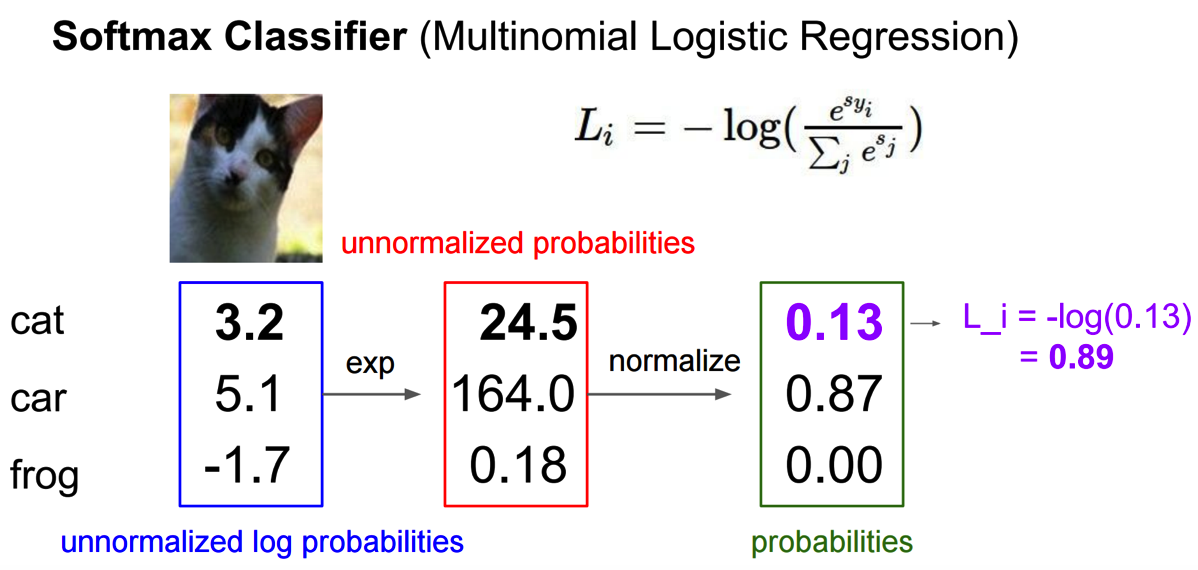
*问题:
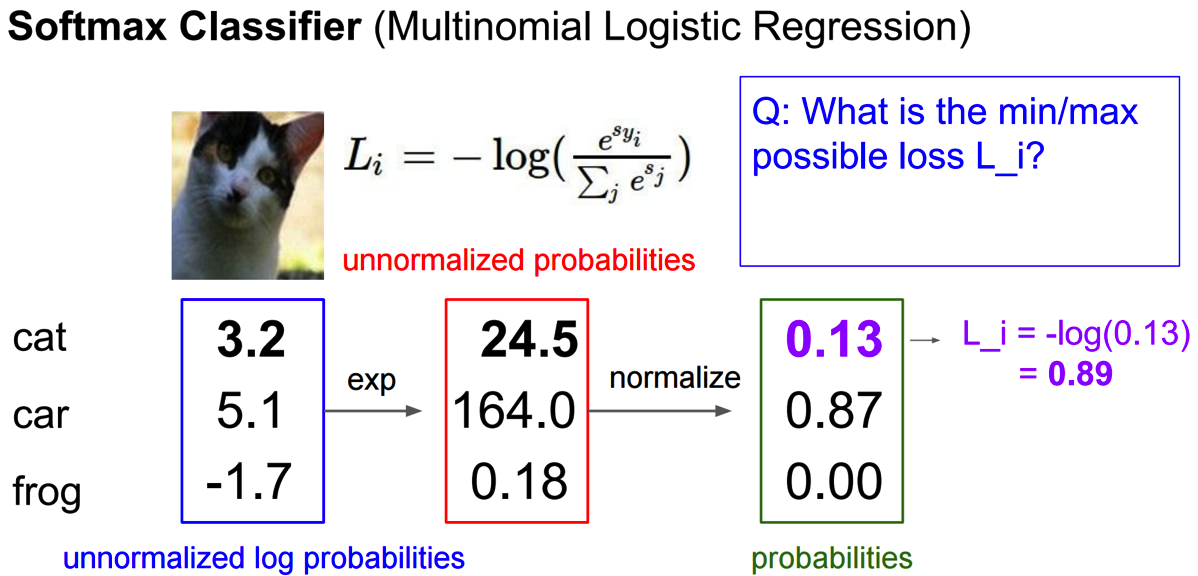
min:0 (全部分对)
max:无穷大 (严重分错)
所以,最大值和最小值是一样的,也符合常理。
比较:
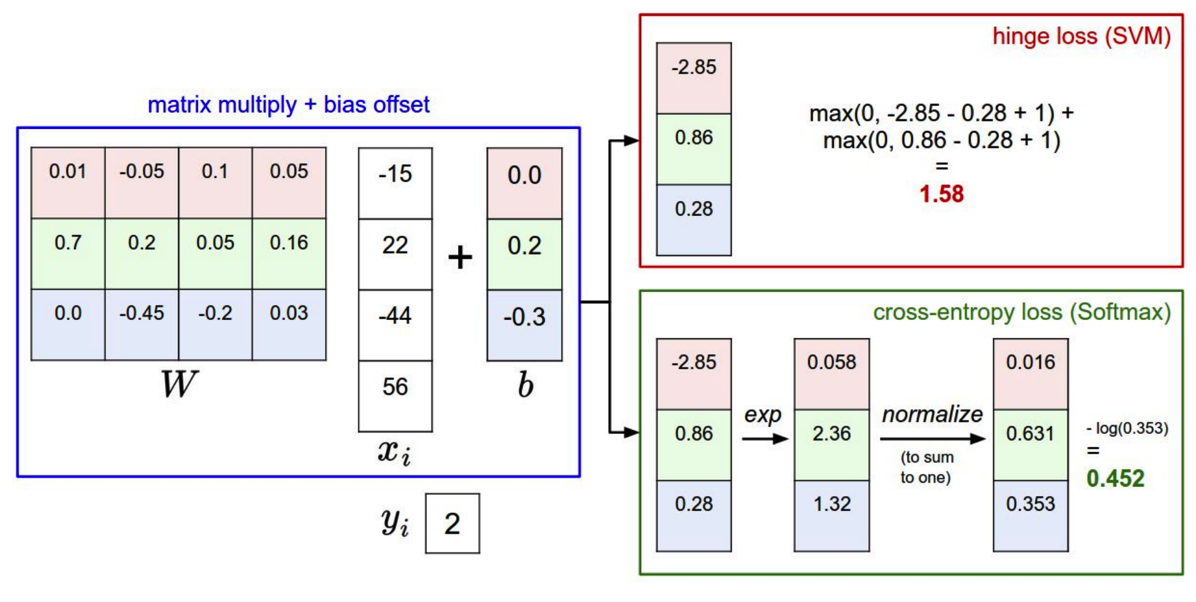
问题:
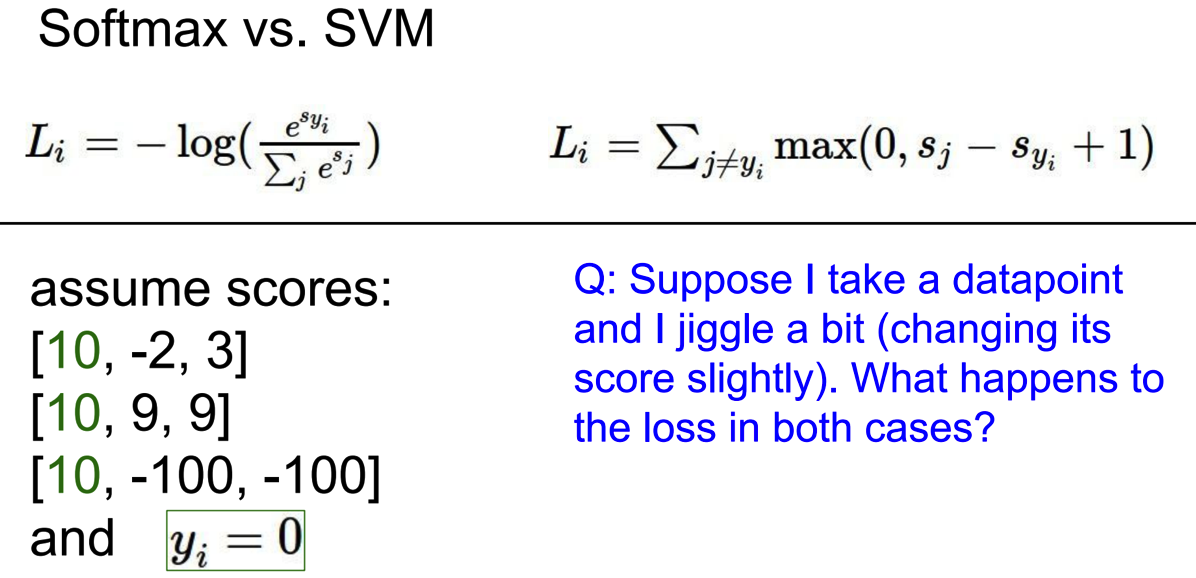
10是正确的score。
如果把第三个数据[10,-100,100]稍微变一下,两种loss function会有什么样的变化?
svm:会保持不变,因为根据公式里,只要(-x)-(100)+1<0,它都会被认为是0.所以,对结果不会产生任何影响。
softmax:会产生better loss。
有学生提问:为什么是svm中是+1,可以改为0吗?
回答:必须要一个正数(详细解释请看cs229,margin)
demo : http://vision.stanford.edu/teaching/cs231n/linear-classify-demo/
_________________________________________________________________________________________________________________________________
-Optimization
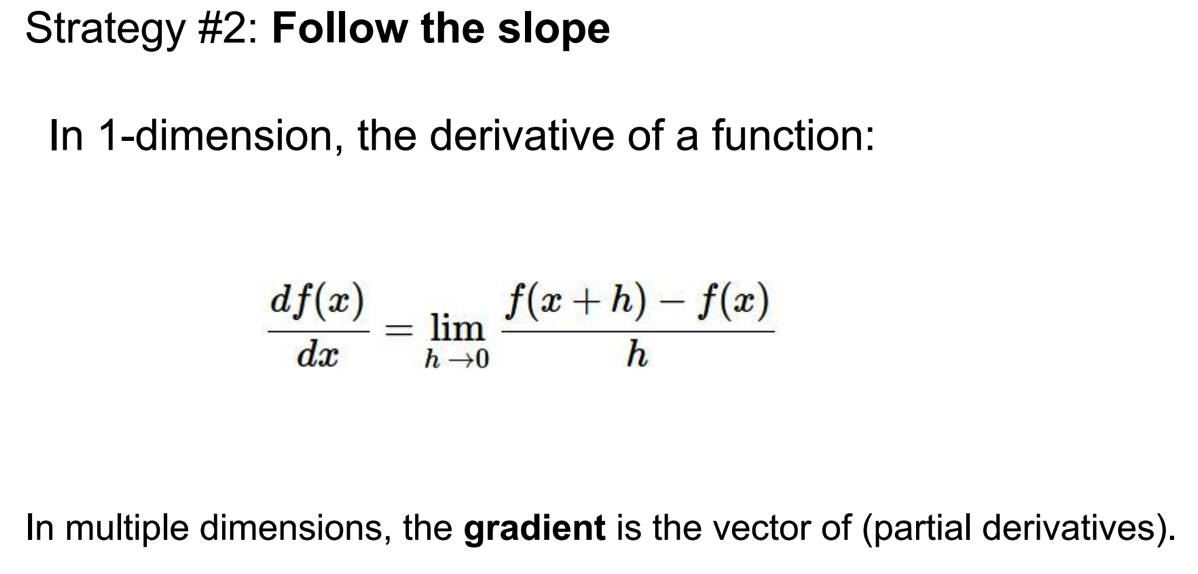
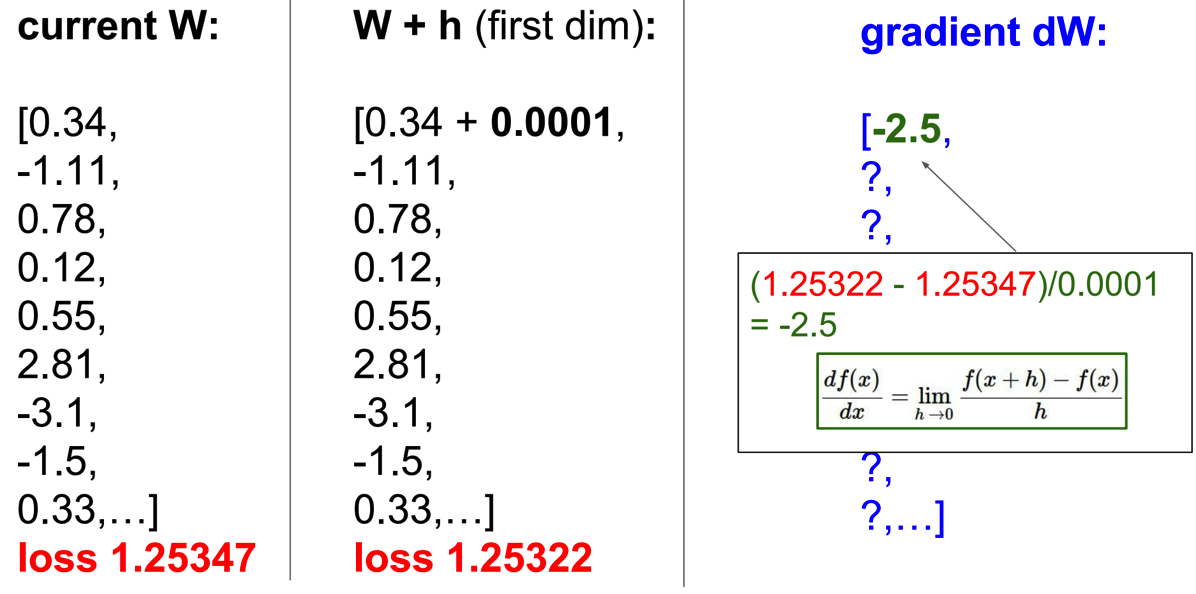
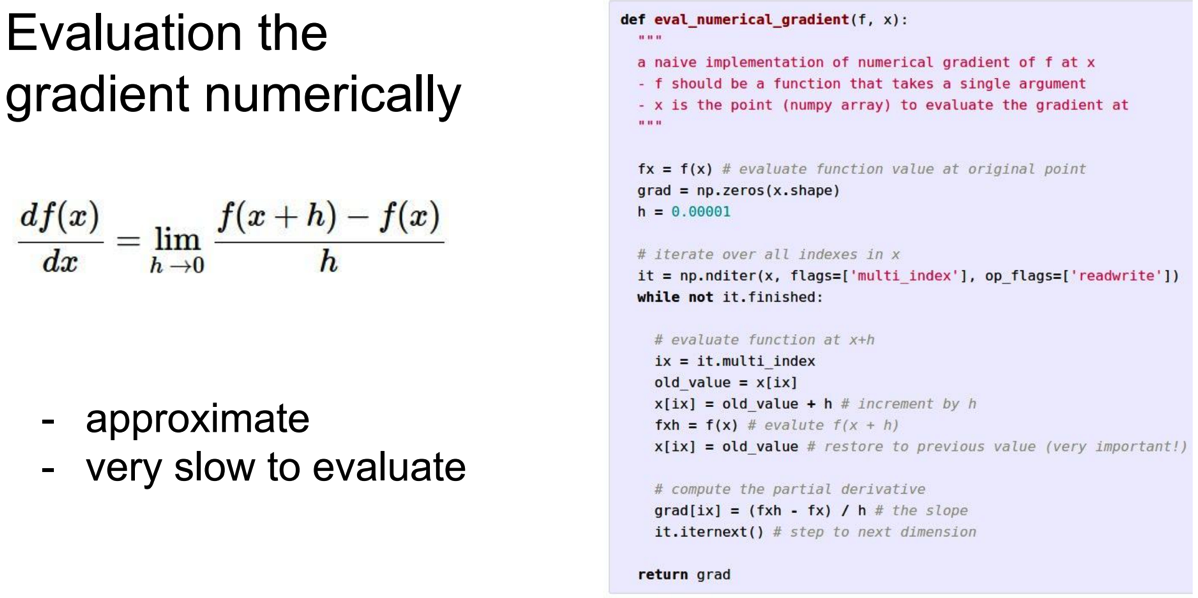
因为参数有成千上万个,如果改变一个参数计算一次loss的话,会非常耗时。
引出微积分(莱布尼茨和牛顿发现的):
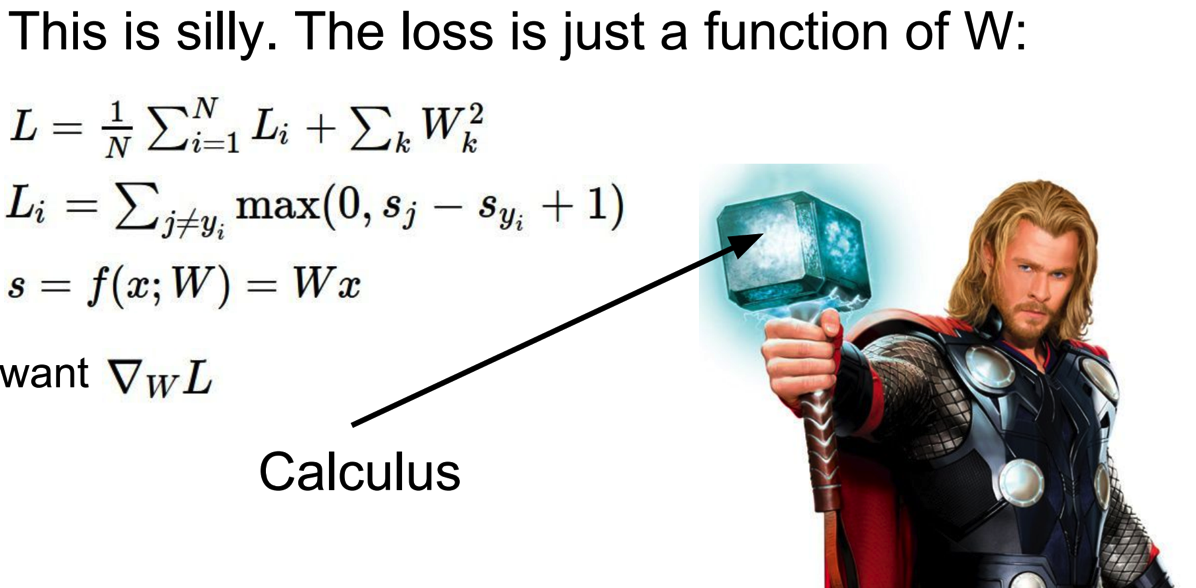
通过直接计算导数就可以了。
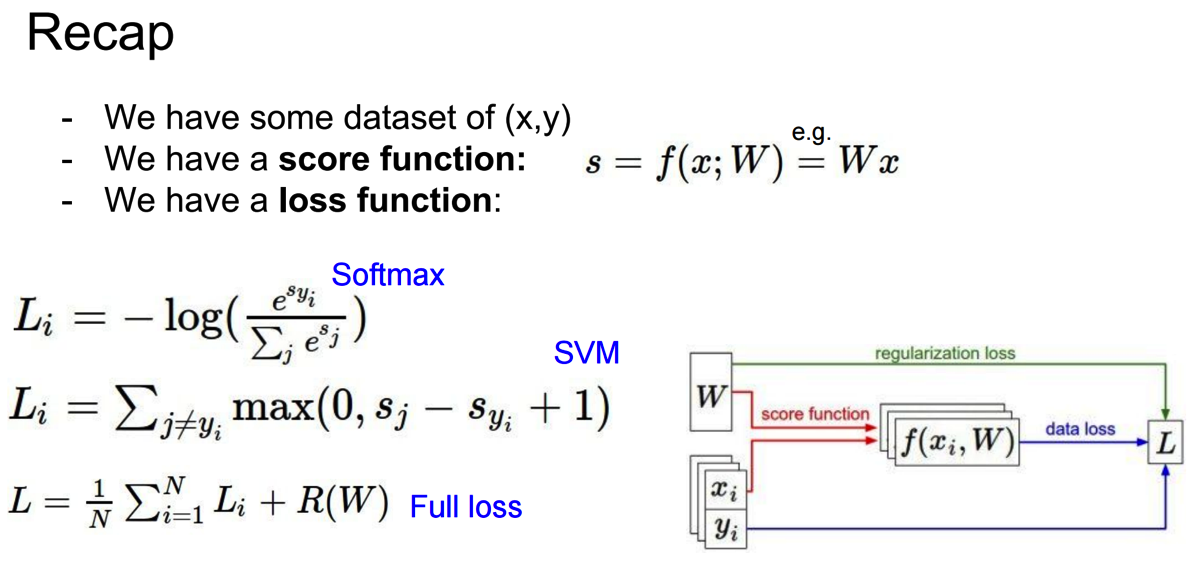
总结:
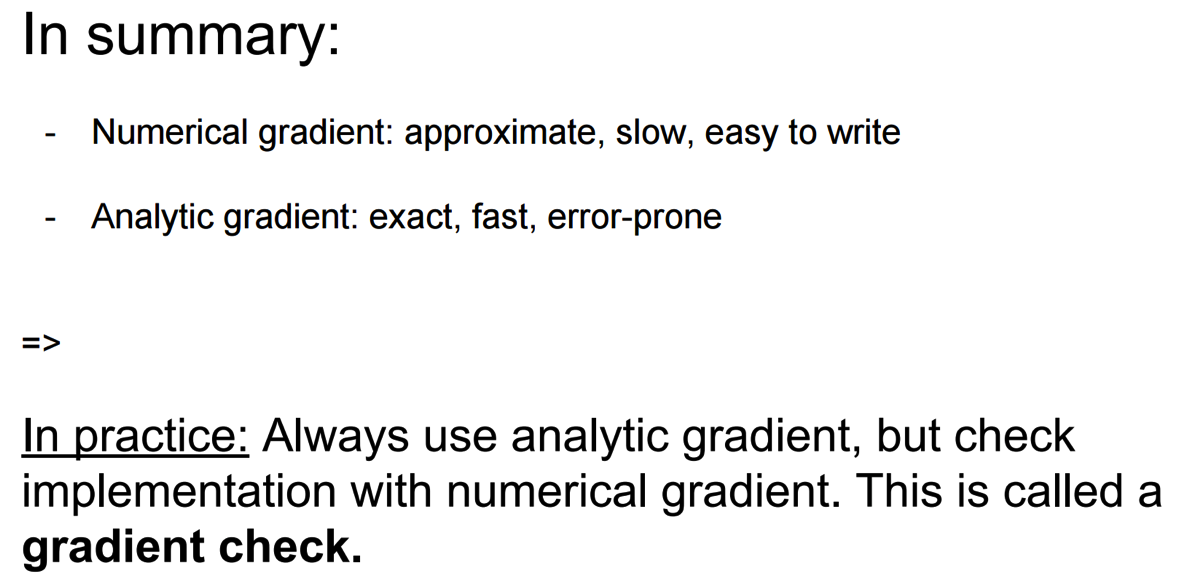
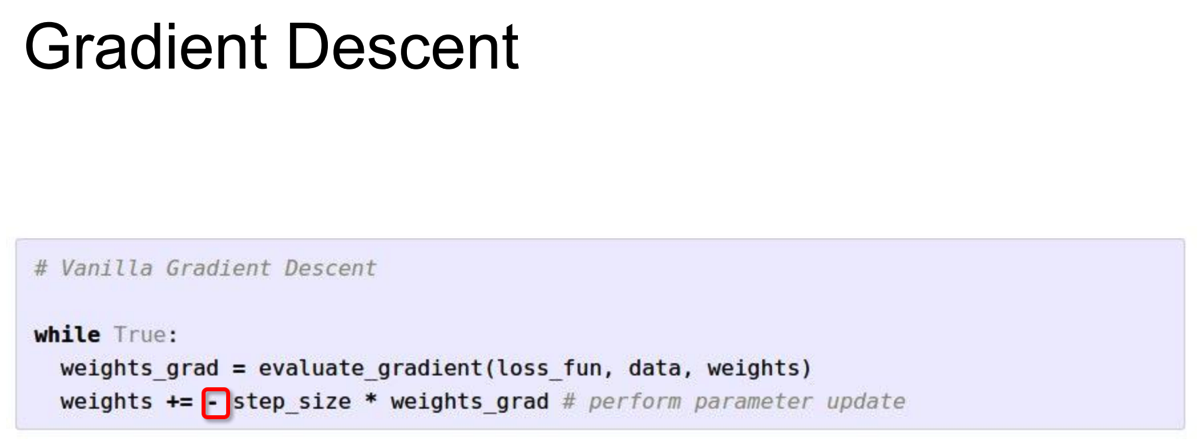
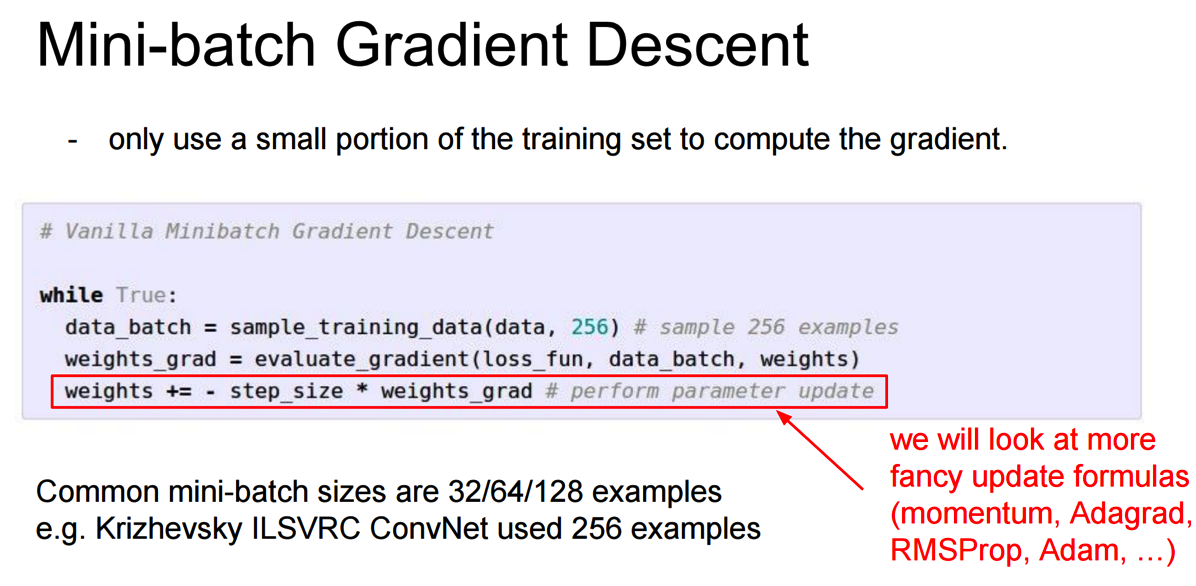
更有效的方法:不把所有的训练数据拿来训练,而是每次随机抽取部分数据拿来训练。虽然每次的结果会有波动,但是总的趋势是下降的。
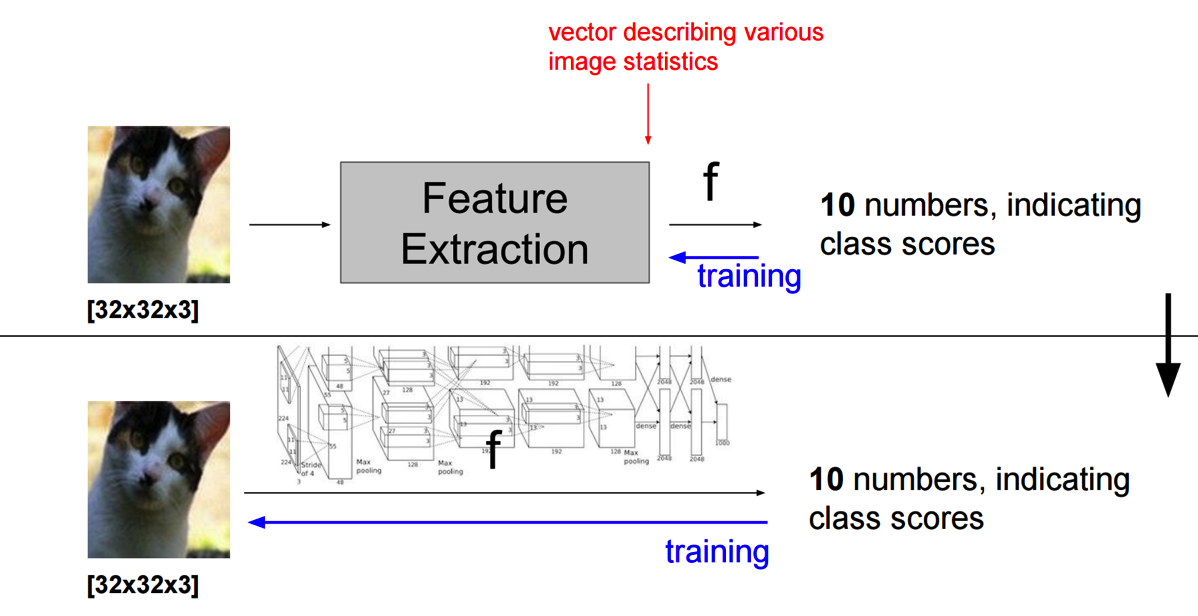
下面的那种不需要feature extraction,直接training出10numbers。
[CS231n-CNN] Linear classification II, Higher-level representations, image features, Optimization, stochastic gradient descent的更多相关文章
- 线性回归、梯度下降(Linear Regression、Gradient Descent)
转载请注明出自BYRans博客:http://www.cnblogs.com/BYRans/ 实例 首先举个例子,假设我们有一个二手房交易记录的数据集,已知房屋面积.卧室数量和房屋的交易价格,如下表: ...
- Linear Regression and Gradient Descent (English version)
1.Problem and Loss Function Linear Regression is a Supervised Learning Algorithm with input matrix ...
- [CS231n-CNN] Image classification and the data-driven approach, k-nearest neighbor, Linear classification I
课程主页:http://cs231n.stanford.edu/ Task: Challenges: _________________________________________________ ...
- Higher level thinking
「Higher level thinking」-- 出自 Ray Dalio 的<Principles>(PDF 原文:Principles by Ray Dalio) Higher le ...
- 从损失函数优化角度:讨论“线性回归(linear regression)”与”线性分类(linear classification)“的联系与区别
1. 主要观点 线性模型是线性回归和线性分类的基础 线性回归和线性分类模型的差异主要在于损失函数形式上,我们可以将其看做是线性模型在多维空间中“不同方向”和“不同位置”的两种表现形式 损失函数是一种优 ...
- 斯坦福机器学习视频笔记 Week1 Linear Regression and Gradient Descent
最近开始学习Coursera上的斯坦福机器学习视频,我是刚刚接触机器学习,对此比较感兴趣:准备将我的学习笔记写下来, 作为我每天学习的签到吧,也希望和各位朋友交流学习. 这一系列的博客,我会不定期的更 ...
- 斯坦福机器学习视频笔记 Week1 线性回归和梯度下降 Linear Regression and Gradient Descent
最近开始学习Coursera上的斯坦福机器学习视频,我是刚刚接触机器学习,对此比较感兴趣:准备将我的学习笔记写下来, 作为我每天学习的签到吧,也希望和各位朋友交流学习. 这一系列的博客,我会不定期的更 ...
- machine learning (7)---normal equation相对于gradient descent而言求解linear regression问题的另一种方式
Normal equation: 一种用来linear regression问题的求解Θ的方法,另一种可以是gradient descent 仅适用于linear regression问题的求解,对其 ...
- Logistic Regression Using Gradient Descent -- Binary Classification 代码实现
1. 原理 Cost function Theta 2. Python # -*- coding:utf8 -*- import numpy as np import matplotlib.pyplo ...
随机推荐
- Nodejs学习笔记(十三)— PM2
目录 简介 pm2安装 操作 启动 关闭 其它方式启动/关闭 从PM2中删除 重载和重启 查看详细信息 多项目操作 集群 其它操作 写在之后... 简介 PM2 pm2是一个内置负载均衡的node.j ...
- 旋转V字俄罗斯方块
实现效果如图,也就是一个图像的旋转.注意,旋转后的文字是相对应的,而且文字还是立起的.第一次点击时显示,第二次点击时开始旋转.下面是我做这个效果的记录,方法这么差,我也就不说什么了. 先上HTML/C ...
- paip.互联网产品要成功的要素
paip.互联网产品要成功的要素 作者Attilax 艾龙, EMAIL:1466519819@qq.com 来源:attilax的专栏 地址:http://blog.csdn.net/atti ...
- atitit.ajax 最佳实践跟框架选型 o99
atitit.ajax 最佳实践跟框架选型 1. 选型框架dwr/dwr3 跟jq 1 2. DWR方便的地方分为两个地方. 1 3. dwr 优点: 1 4. 缺点: 2 5. 根jq的区别 2 1 ...
- atitit.提升开发效率---mda 软件开发方式的革命--(2)
atitit.提升开发效率---mda 软件开发方式的革命--(2) 1. 一个完整的MDA规范包含: 1 2. 一个完整的MDA应用程序包含: 1 3. MDA能够带来的最大的三个好处是什么? 2 ...
- Leetcode 20 Valid Parentheses stack的应用
判断括号是否合法 1.用stack存入左括号“([{”,遇到相应的右括号“)]}”就退栈 2.判断stack是否为空,可以判断是否合法 class Solution { public: bool is ...
- 重学JAVA基础(八):锁的基本知识
1.线程状态 如上图,当我们新建一个线程,并start后,其实不一定会马上执行,因为只有操作系统调度了我们的线程,才能真正进行执行,而操作系统也随时可以运行其他线程,这时线程又回到可运行状态.这个过程 ...
- 重学JAVA基础(七):线程的wait、notify、notifyAll、sleep
/** * 测试thread的wait notify notifyAll sleep Interrupted * @author tomsnail * @date 2015年4月20日 下午3:20: ...
- css3动画特效:纯css3制作win8加载动画特效
Windows 8 完整效果如上图:这个里面可能是css冲突,喜欢的可以自己去体征一下: css特效代码: <style type="text/css"> ...
- TextEdit 回车事件
<dxe:TextEdit Name="txtSearchPatientName" KeyDown="txtSearchPatientName_KeyDown_1& ...