
scrapy实验1 爬取中国人寿官网新闻,保存为xml
一、scrapy 实验 爬中国人寿新闻,保存为xml
如需转发,请注明出处:小婷儿的python https://www.cnblogs.com/xxtalhr/p/10517297.html
链接:https://pan.baidu.com/s/1HeIbBuAWjk8uNRl7ZIXh-A
提取码:z3hh
1.1 代码结构
scrapy框架具体内容,请参考
1、scrapy(一)scrapy 安装问题 https://www.cnblogs.com/xxtalhr/p/9170437.html
2、Scrapy 框架(二)数据的持久化 https://www.cnblogs.com/xxtalhr/p/9164186.html
3、scrapy (三)各部分意义及框架示意图详解 https://www.cnblogs.com/xxtalhr/p/9170343.html
4、scrapy (四)基本配置 https://www.cnblogs.com/xxtalhr/p/9169484.html
5、scrapy shell https://www.cnblogs.com/xxtalhr/p/9158651.html

1.2 书写 spiders
 # -*- coding: utf-8 -*-

 import scrapy

 import json

 class RrSpider(scrapy.Spider):

     name = 'rr'

     allowed_domains = ['www.chinalife.com.cn']

     start_urls = ['https://www.chinalife.com.cn/chinalife/xwzx/gsxw/7934bcc5-%d.html' % (i) for i in range(1, 12)]

     def parse(self, response):

         news = response.xpath('//div[@class="easysite-article-content"]/ul/li')

         print('========================================', len(news))

         items = []

         fp = open('./xml-4.xml', 'a', encoding='utf-8')#打开文件,不用手动创建

         for new in news:

             new_date = new.xpath('./span/text()').extract()[0]

             new_title = new.xpath('.//div/span/a/@title').extract_first()

             new_info = new.xpath('.//div/a/span/text()').extract_first()

             new_link = 'https://www.chinalife.com.cn/' + new.xpath('.//div/span/a/@href').extract_first()

             item = {}

             item['date'] = new_date

             item['title'] = new_title

             item['info'] = new_info

             item['link'] = new_link

             fp.write(json.dumps(item))#写入文件

             items.append(item)

             print('+++++++++++++++++++++++++++++++', new_date, new_info, new_link, new_title,)

         fp.close()

         return items
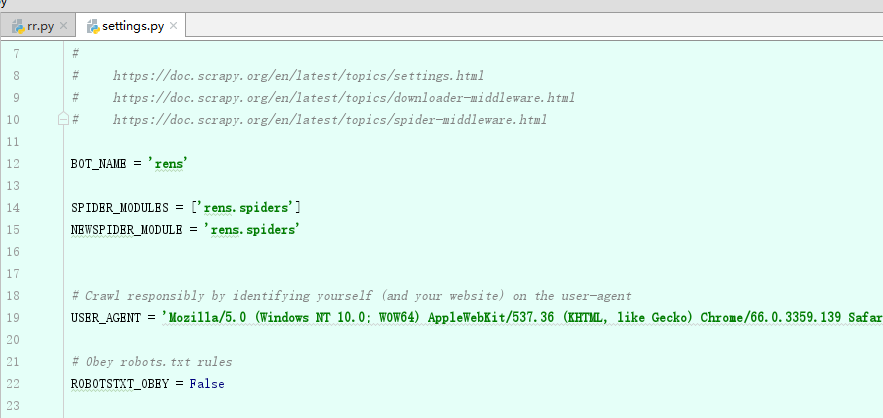
二、修改 setting中 USER_AGENT 和 ROBOTSTXT_OBEY
三、 终端 执行命令
scrapy crawl rr -o renshou.xml
# ('json', 'jsonlines', 'jl', 'csv', 'xml', 'marshal', 'pickle')

欢迎关注小婷儿的博客:
csdn:https://blog.csdn.net/u010986753
博客园:http://www.cnblogs.com/xxtalhr/
有问题请在博客下留言或加作者微信:tinghai87605025 或 QQ :87605025
python QQ交流群:py_data 483766429
OCP培训说明连接:https://mp.weixin.qq.com/s/2cymJ4xiBPtTaHu16HkiuA
OCM培训说明连接:https://mp.weixin.qq.com/s/7-R6Cz8RcJKduVv6YlAxJA
小婷儿的python正在成长中,其中还有很多不足之处,随着学习和工作的深入,会对以往的博客内容逐步改进和完善哒。
重要的事多做几遍。。。。。。

scrapy实验1 爬取中国人寿官网新闻,保存为xml的更多相关文章
- 爬虫之爬取斗鱼官网LOL部分主播的状态
一个爬虫小程序 爬取主播的排名及观看人数 import re import requests import request class Spider(): url = 'https://www.dou ...
- 实战爬取Plati官网游戏实时最低价格-Python
需要修改url中的id_r="这个",这个id需要从Battlefield V (plati.ru)中获取,其实也是这个链接中的#s24235. 配合了e-mail推送,其实这个e ...
- Scrapy实战篇(一)之爬取链家网成交房源数据(上)
今天,我们就以链家网南京地区为例,来学习爬取链家网的成交房源数据. 这里推荐使用火狐浏览器,并且安装firebug和firepath两款插件,你会发现,这两款插件会给我们后续的数据提取带来很大的方便. ...
- Python Scrapy 爬取煎蛋网妹子图实例(一)
前面介绍了爬虫框架的一个实例,那个比较简单,这里在介绍一个实例 爬取 煎蛋网 妹子图,遗憾的是 上周煎蛋网还有妹子图了,但是这周妹子图变成了 随手拍, 不过没关系,我们爬图的目的是为了加强实战应用,管 ...
- Python的scrapy之爬取顶点小说网的所有小说
闲来无事用Python的scrapy框架练练手,爬取顶点小说网的所有小说的详细信息. 看一下网页的构造: tr标签里面的 td 使我们所要爬取的信息 下面是我们要爬取的二级页面 小说的简介信息: 下面 ...
- 使用 Scrapy 爬取去哪儿网景区信息
Scrapy 是一个使用 Python 语言开发,为了爬取网站数据,提取结构性数据而编写的应用框架,它用途广泛,比如:数据挖掘.监测和自动化测试.安装使用终端命令 pip install Scrapy ...
- 爬取西刺网的免费IP
在写爬虫时,经常需要切换IP,所以很有必要自已在数据维护库中维护一个IP池,这样,就可以在需用的时候随机切换IP,我的方法是爬取西刺网的免费IP,存入数据库中,然后在scrapy 工程中加入tools ...
- python爬虫基础应用----爬取校花网视频
一.爬虫简单介绍 爬虫是什么? 爬虫是首先使用模拟浏览器访问网站获取数据,然后通过解析过滤获得有价值的信息,最后保存到到自己库中的程序. 爬虫程序包括哪些模块? python中的爬虫程序主要包括,re ...
- selenium爬取煎蛋网
selenium爬取煎蛋网 直接上代码 from selenium import webdriver from selenium.webdriver.support.ui import WebDriv ...
随机推荐
- js-MediumGrade-base.js
// 1.JavaScript 中的类型包括 Number(数字) String(字符串) Boolean(布尔) Symbol(符号)(第六版新增) Object(对象) Function(函数) ...
- 【读书笔记】iOS-iCloud介绍
iCloud是一种面向消费者市场的云存储服务,苹果公司已经做了大量的工作让用户能够平滑过渡到iCloud,不过对开发者而言这意味着新的负担. 怎样使用iCloud? 你可以使用2种方式在你的应用中使用 ...
- 【读书笔记】iOS-UDID
UIDevice类可以返回当前iOS设备的UDID,以前开发者通常使用UDID作为识别每台设备的唯一标识,然后从iOS5开始,苹果公司将这一功能标记为废止并不推荐使用,苹果公司在iOS6之后将这个功能 ...
- React 入门学习笔记整理(五)—— state
1.state 1)组件本省也是有状态的,定义在组件内部的state中,state的状态只能由组件自身改变,任何其他组件都不能改变. 当需要改变state时,通过调用setState方法来改变,set ...
- Salesforce小知识:累计汇总字段类型
累计汇总字段类型的定义 Salesforce中可以在两个对象之间建立关系.一个对象的某一条记录可以有若干条相关联的其他对象记录. 累计汇总字段可以将这些相关联的记录中的某些字段值汇总起来,显示给用户. ...
- (后端)java回调机制
转自强哥: 所谓回调,就是客户程序C调用服务程序S中的某个函数A,然后S又在某个时候反过来调用C中的某个函数B,对于C来说,这个B便叫做回调函数.例如Win32下的窗口过程函数就是一个典型的回调函数. ...
- javascript中的异步编程
正常情况下js都是顺序执行的,但是也有很多场景下实际上是异步操作: 1.定时器都是异步操作 2.事件绑定都是异步操作 3.AJAX中一般我们都采取异步操作(也可以同步) 4.回调函数可以理解为异步(不 ...
- SQL Server ltrim(rtrim()) 去不掉空格
原因:中间存在回车符或者换行符,所以要先将此符号替换掉: LTRIM(RTRIM(REPLACE(REPLACE( A,char(13),''),char(10),'') )) LTRIM(A) -- ...
- .net core 导出Excel(epplus 创建excel )
[Route("getopenfrequencyexcel")] [HttpGet] public IActionResult GetOpenFrequencyExcel(int ...
- Hbase-2.0.0_03_Hbase数据模型
1. hbase数据模型 1.1. HBase数据模型术语 Table HBase表由多行组成. Row HBase中的一行由一个行键和一个或多个列组成,列的值与这些列相关联.存储行时,按行键按字母顺 ...