
JStorm:概念与编程模型
1、集群架构
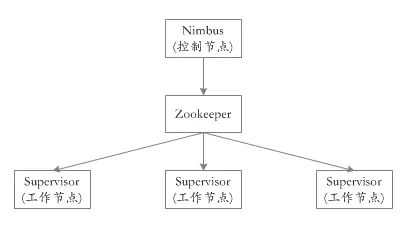
JStorm从设计的角度,就是一个典型的调度系统,简单集群的架构如下图所示,其中Nimbus可增加一个备节点,多个Supervisor节点组成任务执行集群。
1.1、Nimbus
Nimbus是作为整个集群的调度器角色,负责分发topology代码、分配任务,监控集群运行状态等,其主要通过ZK与supervisor交互。可以和Supervisor运行在同一物理机上,JStorm中Nimbus可采用主从备份,支持热切。
1.2、Supervisor
Supervisor 是集群中任务的执行者,负责运行具体任务以及关闭任务。其从ZK中监听nimbus的指令,然后接收分发代码和任务并执行、监控反馈任务执行情况。
1.3 、Zookeeper
ZK是整个系统中的协调者,Nimbus的任务调度通过ZK下发至Supervisor来执行。
2、Topology编程模型
Topology是一个可以在JStorm中运行的任务的抽象表达,在JStorm的topology中,有两种组件:spout和bolt。下面是一张比较经典的Topology结构图。每一个topology,既可以有多个spout,代表同时从多个数据源接收消息,也可以多个bolt,来执行不同的业务逻辑。一个topology会一直运行直到你手动kill掉,JStorm自动重新分配执行失败的任务。
在JStorm中有对于流stream的抽象,流是一个不间断的无界的连续tuple,注意JStorm在建模事件流时,把流中的事件抽象为tuple即元组。
我们可以认为spout就是一个一个的水龙头,并且每个水龙头里流出的水是不同的tuple,我们想拿到哪种水tuple就拧开哪个水龙头,然后使用管道将水龙头的水tuple导向到一个水处理器(bolt),水处理器bolt处理后再使用管道导向另一个处理器或者存入容器中。
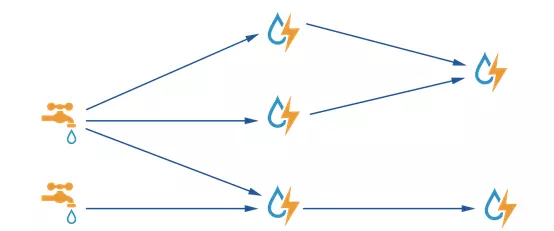
JStorm将上图抽象为Topology即拓扑,拓扑结构是有向无环的,拓扑是Jstorm中最高层次的一个抽象概念,它可以被提交到Jstorm集群执行,一个拓扑就是一个数据流转换图,图中每个节点是一个spout或者bolt,图中的边表示bolt订阅了哪些流,当spout或者bolt发送元组到流时,它就发送元组到每个订阅了该流的bolt。
2.1、spout
JStorm认为每个stream都有一个stream源,也就是原始元组的源头,所以它将这个源头抽象为spout,spout可能是连接消息中间件(如MetaQ, Kafka, TBNotify等),并不断发出消息,也可能是从某个队列中不断读取队列元素并装配为tuple发射。
JStorm框架对spout组件定义了一个主要方法:nextTuple,顾名思义,就是获取下一条消息。执行时,可以理解成JStorm框架会不停地调这个接口,以从数据源拉取数据并往bolt发送数据。
Tuple是一次消息传递的基本单元,tuple里的每个字段一个名字,并且不同tuple的对应字段的类型必须一样。tuple的字段类型可以是: integer, long, short, byte, string, double, float, boolean和byte array。还可以自定义类型,只要实现对应的序列化器。
JStorm中与spout相关的接口主要是ISpout和IRichSpout、IBatchSpout,后两接口实现了对ISpout接口的上层封装。
ISpout接口主要方法:
open:在worker中初始化该ISpout时调用,一般用来设置一些属性:比如从spring容器中获取对应的Bean。
close:和open相对应(在要关闭的时候调用)。
activate:从非活动状态变为活动状态时调用。
deactivate:和activate相对应(从活动状态变为非活动状态时调用)。
nextTuple:JStorm希望在每次调用该方法的时候,它会通过collector.emit发射一个tuple。
ack:jstorm发现msgId对应的tuple被成功地完整消费会调用该方法。
fail:和ack相对应(jstorm发现某个tuple在某个环节失败了)。和ack一起保证tuple一定被处理。
2.2、bolt
JStorm将tuple的中间处理过程抽象为Bolt,bolt可以消费任意数量的输入流,只要将流方向导向该bolt,同时它也可以发送新的流给其他bolt使用,这样一来,只要打开特定的spout(管口)再将spout中流出的tuple导向特定的bolt,然后bolt对导入的流做处理后再导向其他bolt或者目的地。
bolt代表处理逻辑,bolt收到消息之后,对消息做处理(即执行用户的业务逻辑),处理完以后,既可以将处理后的消息继续发送到下游的bolt,这样会形成一个处理流水线(不过更复杂的情况应该是个有向图);也可以直接结束。
bolt组件主要方法:execute,这个接口就是用户用来处理业务逻辑的地方。
通常一个流水线的最后一个bolt,会做一些数据的存储工作,比如将实时计算出来的数据写入DB、HBase等,以供前台业务进行查询和展现。Bolts可以发射多条消息流, 使用OutputFieldsDeclarer.declareStream定义stream,使用OutputCollector.emit来选择要发射的stream。
在保证不丢消息的场景中,在bolts必须要为它处理的每一个tuple调用OutputCollector的ack方法,以通知JStorm这个tuple被处理完成了,从而通知这个tuple的发射者spouts。 一般的流程是: bolts处理一个输入tuple, 发射0个或者多个tuple, 然后调用ack通知JStorm自己已经处理过这个tuple了。JStorm提供了一个IBasicBolt会自动调用ack。
JStorm中与Bolt相关的接口主要是IBolt,IRichBolt,IBasicBolt和IBatchBolt,后面接口实现了对IBolt接口的上层封装。
IBolt接口的主要方法:
prepare:在worker中初始化该IBolt时调用,一般用来设置一些属性:比如从spring容器中获取对应的Bean。
cleanup:和prepare相对应(在显示关闭topology的时候调用)
execute:处理jstorm发送过来的tuple。
2.3、Tuple
JStorm将流中数据抽象为tuple,一个tuple就是一个值列表value list,list中的每个value都有一个name,tuple可以由任意类型组合而成,因为storm是分布式的,所以它需要知道在task间如何序列化和反序列化数据的。storm使用Kryo进行序列化,Kryo是java开发中一个快速灵活序列器。默认情况下,storm可以序列化基础类型,比如字符串,字节,数组,ArrayList, HashMap, HashSet和 Clojure 集合类型,如果需要使用其他类型,需要自定义序列器。拓扑的每个节点都要说明它所发射出的元组的字段的name,其他节点只需要订阅该name就可以接收处理。
在spout和Bolt组件中,使用declareOutputFields方法定义发射出的tuple的字段名。
3、小结
本文主要讲述了JStorm中集群的架构以及Topology编程模型方面的概念知识。
https://www.jianshu.com/p/36394f897d36
https://yq.aliyun.com/articles/709401
JStorm:概念与编程模型的更多相关文章
- spark概念、编程模型和模块概述
http://blog.csdn.net/pipisorry/article/details/50931274 spark基本概念 Spark一种与 Hadoop 相似的通用的集群计算框架,通过将大量 ...
- 云巴:基于MQTT协议的实时通信编程模型
概要 有人常问,云巴实时通信系统到底提供了一种怎样的服务,与其他提供推送或 IM 服务的厂商有何本质区别.其实,从技术角度分析,云巴与其它同类厂商都是面向开发者的通信服务,宏观的编程模型都是大同小异, ...
- Spark入门实战系列--3.Spark编程模型(上)--编程模型及SparkShell实战
[注]该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取 .Spark编程模型 1.1 术语定义 l应用程序(Application): 基于Spar ...
- Linux IO模型和网络编程模型
术语概念描述: IO有内存IO.网络IO和磁盘IO三种,通常我们说的IO指的是后两者. 阻塞和非阻塞,是函数/方法的实现方式,即在数据就绪之前是立刻返回还是等待. 以文件IO为例,一个IO读过程是文件 ...
- Spark中文指南(入门篇)-Spark编程模型(一)
前言 本章将对Spark做一个简单的介绍,更多教程请参考:Spark教程 本章知识点概括 Apache Spark简介 Spark的四种运行模式 Spark基于Standlone的运行流程 Spark ...
- ASP.NET编程模型之ASP.NET页面生命周期图解
ASP.NET编程模型中ASP.NET页面生命周期是指什么呢?它包括什么呢?ASP.NET编程模型之ASP.NET页面生命周期具体的过程有哪些呢?下面就开始我们的讲解吧: ASP.NET 页运行时,此 ...
- 并行计算基础&编程模型与工具
在当前计算机应用中,对快速并行计算的需求是广泛的,归纳起来,主要有三种类型的应用需求: 计算密集(Computer-Intensive)型应用,如大型科学project计算与数值模拟: 数据密集(Da ...
- .Net插件编程模型:MEF和MAF[转载]
.Net插件编程模型:MEF和MAF MEF和MAF都是C#下的插件编程框架,我们通过它们只需简单的配置下源代码就能轻松的实现插件编程概念,设计出可扩展的程序.这真是件美妙的事情! 今天抽了一点时间, ...
- 老李分享: 并行计算基础&编程模型与工具 1
老李分享: 并行计算基础&编程模型与工具 在当前计算机应用中,对高速并行计算的需求是广泛的,归纳起来,主要有三种类型的应用需求: 计算密集(Computer-Intensive)型应用,如 ...
随机推荐
- MySQL参数配置
参数名称 参数说明 缺省值 最低版本要求 user 数据库用户名(用于连接数据库) 所有版本 passWord 用户密码(用于连接数据库) 所有版本 useUnicode 是否使用Unicode字符集 ...
- Leetcode No.119 Pascal's Triangle II(c++实现)
1. 题目 1.1 英文题目 Given an integer rowIndex, return the rowIndexth (0-indexed) row of the Pascal's tria ...
- iOS基于AVFoundation实现朗读文字
iOS基于AVFoundation实现朗读文字 1.心理建设 众所周知AVFoundation的朗读是个智障语气,所以想不花钱就只能忍着. 2.speechManager @import AVFoun ...
- 谷粒商城--分布式基础篇(P1~P27)
谷粒商城--分布式基础篇P1~P27 去年3月份谷粒商城分布式基础.进阶.高级刚出的时候就开始学了,但是中途因为一些事就中断了,结果一直到现在才有时间重新开始学,看到现在网上这么多人都学完了,确实感觉 ...
- LeetCode解题记录(贪心算法)(二)
1. 前言 由于后面还有很多题型要写,贪心算法目前可能就到此为止了,上一篇博客的地址为 LeetCode解题记录(贪心算法)(一) 下面正式开始我们的刷题之旅 2. 贪心 763. 划分字母区间(中等 ...
- CQOI 2021 游记
CQOI 2021 游记 Stage -1 \(\texttt{NOIP}\) 考的比较爆炸所以觉得自己没啥指望了. Stage 0
- matlab——线性规划
@ 目录 前言 一.基本概念 二.matlab实现 1.常用函数 2.常见变形 参考书目 前言 线性规划是数学规划中的一个重要分支,常用于解决如何利用现有资源来安排生产,以取得最大经济效益的问题.本文 ...
- 在Ubuntu20中安装Elasticsearch和Kibana6.8.1版本 母胎教学
首先,我们在Ubuntu中安装Elasticsearch6.8.1命令如下: $ docker pull elasticsearch:6.8.1 拉取完成后,创建Elasticsearch6.8.1容 ...
- java并发编程基础——线程的创建
一.基础概念 1.进程和线程 进程:每个进程都有独立的代码和数据空间(进程上下文),进程间的切换会有较大的开销,一个进程包含1--n个线程.(进程是资源分配的最小单位) 线程:同一类线程共享代码和数据 ...
- Tbase读写分离与分库分表
一.读写分离 1.1 what 读写分离 读写分离,基本的原理是让主数据库处理事务性增.改.删操作(INSERT.UPDATE.DELETE),而从数据库处理SELECT查询操作.数据库复制被用来把事 ...