
python爬虫:抓取下载电影文件,合并ts文件为完整视频
目标网站:https://www.88ys.cc/vod-play-id-58547-src-1-num-1.html 反贪风暴4
对电影进行分析
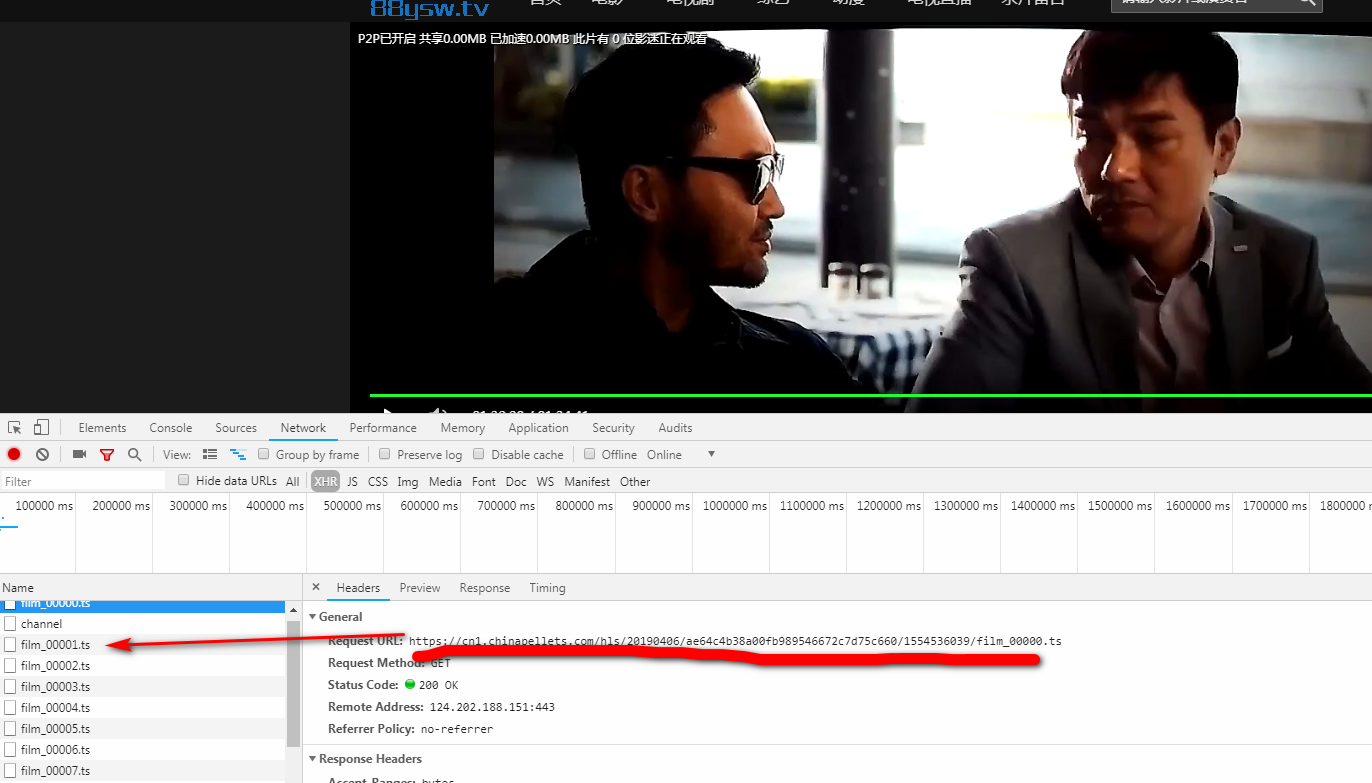
我们发现,电影是按片段一点点加载出来的,我们分别抓取所有ts文件,然后合并成一个完整的文件即可下载到完整电影
代码如下:
# https://www.88ys.cc/vod-play-id-58547-src-1-num-1.html 电影地址

import requests

import os

import time

from multiprocessing import Pool

def run(i):

    url = 'https://cn1.chinapellets.com/hls/20190406/ae64c4b38a00fb989546672c7d75c660/1554536039/film_0%04d.ts'%i

    print("开始下载:"+url)

    headers = {"User-Agent": "Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/69.0.3497.92 Safari/537.36"}

    r = requests.get(url, headers = headers)

    # print(r.content)

    with open('./mp4/{}'.format(url[-:]),'wb') as f:

        f.write(r.content)

def merge(t,cmd):

    time.sleep(t)

    res=os.popen(cmd)

    print(res.read())

if __name__ == '__main__':

    # 创建进程池,执行10个任务

    pool = Pool()

    for i in range():

        pool.apply_async(run, (i,)) #执行任务

    pool.close()

    pool.join()

    #调用合并

    merge(,"copy /b mp4\\*.ts mp4\\new.mp4")

    print('ok!处理完成')
因为单个进程下载太慢了,这里用到了进程池,这样基本达到了,最大网速
运行过程:
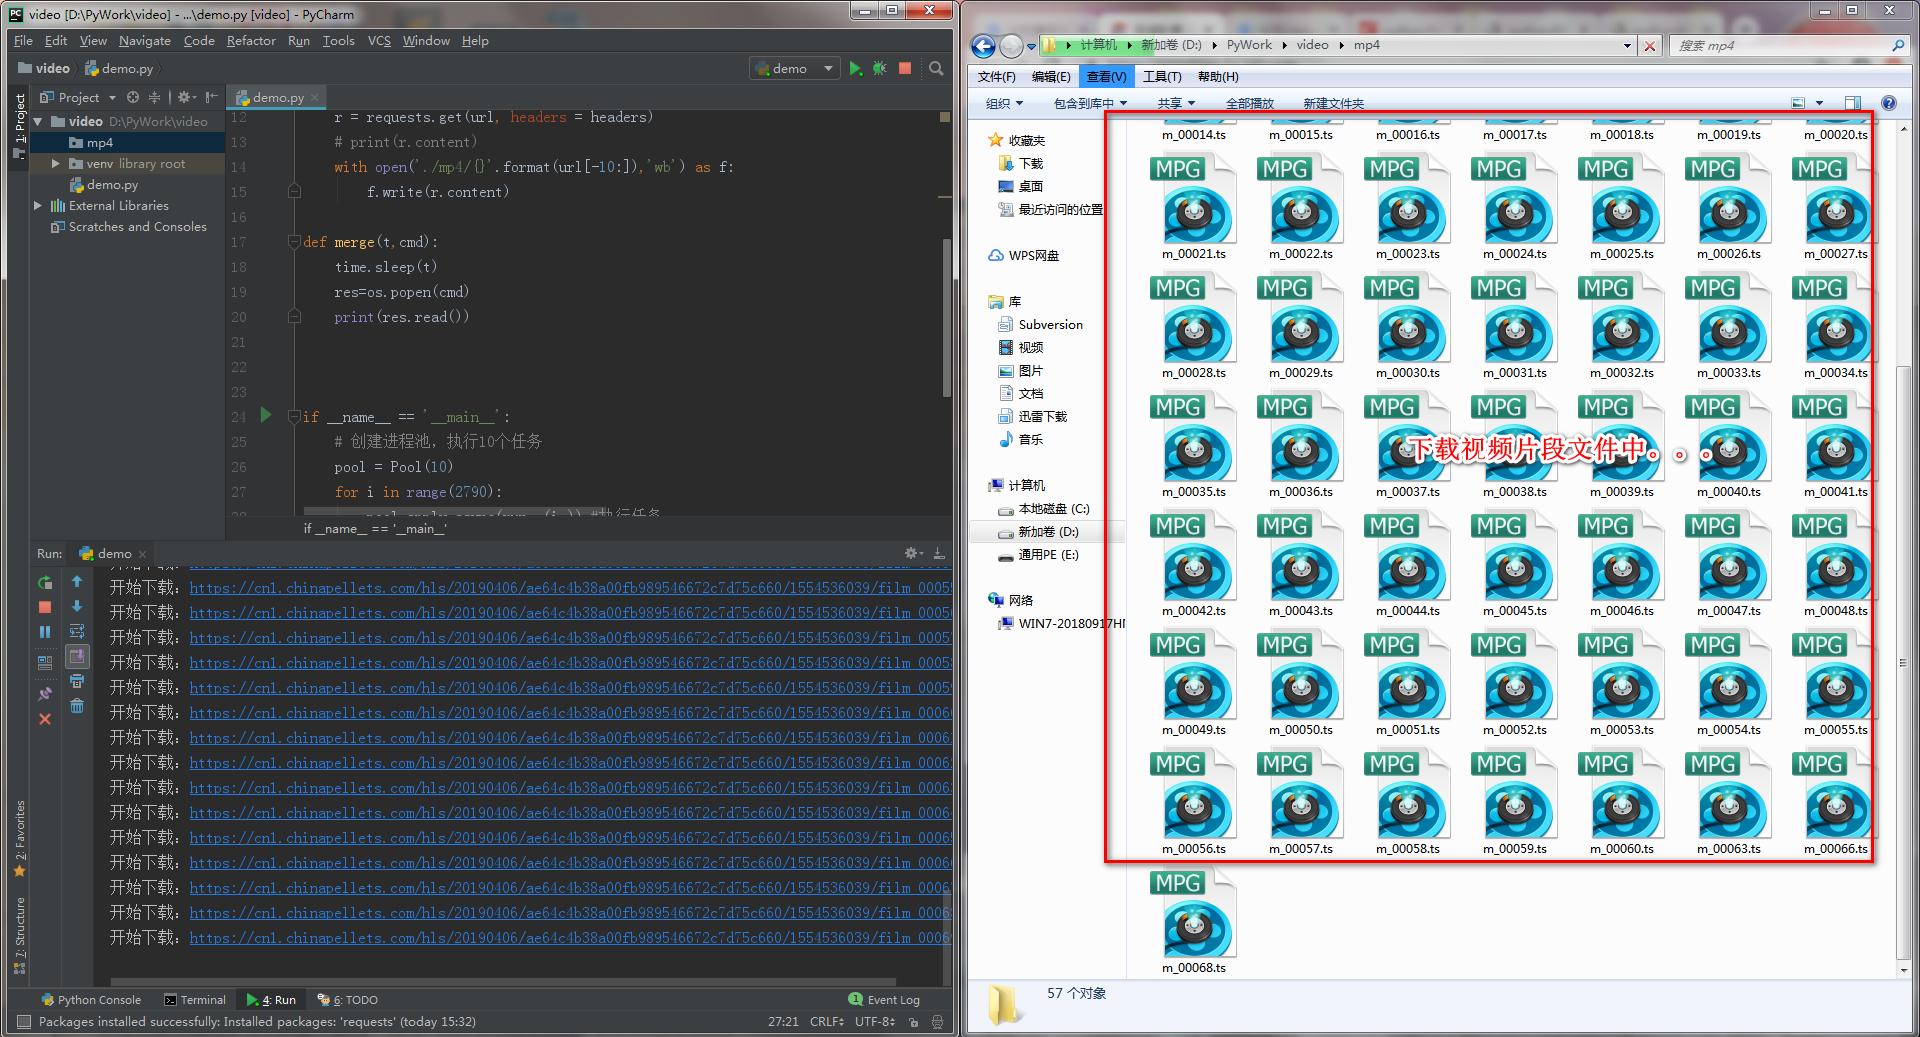
下载完成:

python爬虫:抓取下载电影文件,合并ts文件为完整视频的更多相关文章
- Python爬虫----抓取豆瓣电影Top250
有了上次利用python爬虫抓取糗事百科的经验,这次自己动手写了个爬虫抓取豆瓣电影Top250的简要信息. 1.观察url 首先观察一下网址的结构 http://movie.douban.com/to ...
- python爬虫抓取豆瓣电影
抓取电影名称以及评分,并排序(代码丑炸) import urllib import re from bs4 import BeautifulSoup def get(p): t=0 k=1 n=1 b ...
- python 爬虫抓取心得
quanwei9958 转自 python 爬虫抓取心得分享 urllib.quote('要编码的字符串') 如果你要在url请求里面放入中文,对相应的中文进行编码的话,可以用: urllib.quo ...
- Python爬虫抓取东方财富网股票数据并实现MySQL数据库存储
Python爬虫可以说是好玩又好用了.现想利用Python爬取网页股票数据保存到本地csv数据文件中,同时想把股票数据保存到MySQL数据库中.需求有了,剩下的就是实现了. 在开始之前,保证已经安装好 ...
- Python小爬虫——抓取豆瓣电影Top250数据
python抓取豆瓣电影Top250数据 1.豆瓣地址:https://movie.douban.com/top250?start=25&filter= 2.主要流程是抓取该网址下的Top25 ...
- python爬虫抓取哈尔滨天气信息(静态爬虫)
python 爬虫 爬取哈尔滨天气信息 - http://www.weather.com.cn/weather/101050101.shtml 环境: windows7 python3.4(pip i ...
- 用python+selenium抓取豆瓣电影中的正在热映前12部电影并按评分排序
抓取豆瓣电影(http://movie.douban.com/nowplaying/chengdu/)中的正在热映前12部电影,并按照评分排序,保存至txt文件 #coding=utf-8 from ...
- Python Spider 抓取猫眼电影TOP100
""" 抓取猫眼电影TOP100 """ import re import time import requests from bs4 im ...
- Python爬虫 -- 抓取电影天堂8分以上电影
看了几天的python语法,还是应该写个东西练练手.刚好假期里面看电影,找不到很好的影片,于是有个想法,何不搞个爬虫把电影天堂里面8分以上的电影爬出来.做完花了两三个小时,撸了这么一个程序.反正蛮简单 ...
随机推荐
- Linux内核分析(第五周)
系统调用的三层皮(下) 一.给MenuOs增加time和time-asm命令 ls rm menu -rf git clone xx(克隆新版本) cd menu make rootfs(自动编译生成 ...
- Linux内核分析第二周总结
计算机是如何工作的? 计算机的"三大法宝": 存储程序计算机 函数调用堆栈 中断机制 堆栈是计算机运行高级语言的基础 函数调用堆栈: 32位X86通过函数调用堆栈来传递参数 使用e ...
- rabbitmq windows 安装,更改配置文件路径的问题(管理页面不显示的问题)
路径中的advanced和rabbitmq是advanced.config和rabbitmq.config的文件名而不是文件夹名 并将这两个环境变量加到path里. 完成后,执行命令:rabbitmq ...
- Eclipse导入包提示Setting build path has encountered a problem
Eclipse无法导入jar包时, 提示:“Setting build path” has encountered a problem,Could not write file D:\\workspa ...
- python 如何写CMD命令工具
#-*- coding: UTF- -*- import argparse import sys: sys.argv.append('--help') parser = argparse.Argume ...
- SQLSERVER 设置自动备份数据库
1. SQLSERVER 简单的设置 计划任务 进行 备份数据库的操作. 首先需要打开 一些设置 执行 命令如下: sp_configure ; GO RECONFIGURE; GO sp_confi ...
- 1019C Sergey's problem(思维)
题意: 找出来一个点集S 使得S中的点不能互相通过一步到达 并且S中的点 可以在小于等于2的步数下到达所有的点 要父结点 不要子结点 这样就求出来一个点集S‘ 而S'中可能存在 v -> u ...
- 洛谷P3380 【模板】二逼平衡树(树套树,树状数组,线段树)
洛谷题目传送门 emm...题目名写了个平衡树,但是这道题的理论复杂度最优解应该还是树状数组套值域线段树吧. 就像dynamic ranking那样(蒟蒻的Sol,放一个link骗访问量233) 所有 ...
- Vitrualbox 桥接网卡界面名称未指定、Filters currently installed on the system have reached the limit、不能为虚拟电脑 打开一个新任务
1. 桥接网卡界面名称未指定 http://wenku.baidu.com/link?url=VFG0hknsDX3VPXQoX5f-g1wUX_LBl-lOj0ZqD222kM31iVCPJKVu3 ...
- Problem C: 多线程 解题报告
Problem C: 多线程 Description 多线程是一种常见的加速手段,利用多个线程同时处理不同的任务可以一定程度上减少总耗时,达到提高效率的目的.然而,多个线程间的执行顺序是完全不可控的, ...