
Scrapy爬取携程桂林问答
guilin.sql:
CREATE TABLE `guilin_ask` (
  `id` INT(11) NOT NULL AUTO_INCREMENT COMMENT '主键',
  `question` VARCHAR(255) DEFAULT NULL COMMENT '问题的标题',
  `full_question` VARCHAR(255) DEFAULT NULL COMMENT '问题的详情',
  `keyword` VARCHAR(255) DEFAULT NULL COMMENT '关键字',
  `ask_time` VARCHAR(255) DEFAULT NULL COMMENT '提问时间',
  `accept_answer` TEXT COMMENT '提问者采纳的答案',
  `recommend_answer` TEXT COMMENT '旅游推荐的答案',
  `agree_answer` TEXT COMMENT '赞同数最高的答案',
  PRIMARY KEY (`id`),
  UNIQUE KEY `question` (`question`)
) ENGINE=INNODB DEFAULT CHARSET=utf8 COMMENT='桂林_问答表'
guilin.py:
# -*- coding: utf-8 -*-

import scrapy
from scrapy import Request

from QuestionAndAnswer.items import QuestionandanswerItem
from pyquery import PyQuery as pq

class GuilinSpider(scrapy.Spider):
    name = 'guilin'
    allowed_domains = ['you.ctrip.com']

    def start_requests(self):
        # 重写start_requests方法
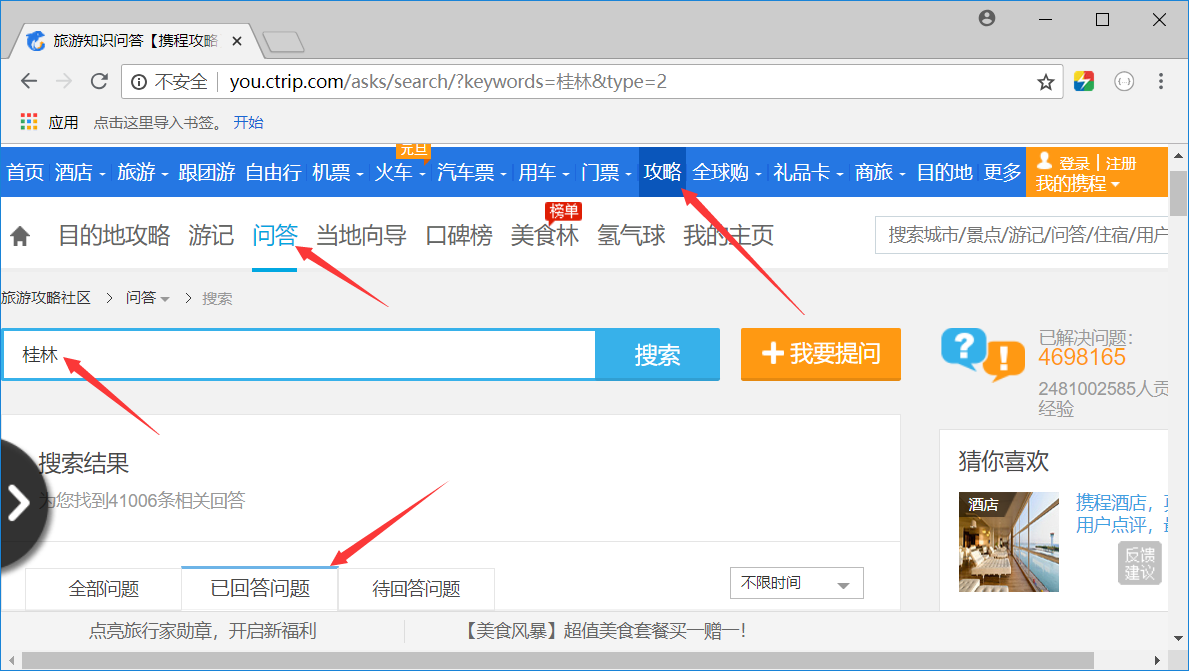
        ctrip_url = "http://you.ctrip.com/asks/search/?keywords=%e6%a1%82%e6%9e%97&type=2"
        # 携程~攻略~问答~桂林~已回答问题

        yield Request(ctrip_url, callback=self.list_page)

    def list_page(self, response):
        result = pq(response.text)
        # 调用pyquery.PyQuery
        result_list = result(".cf")
        # 问题列表
        question_urls = []
        # 问题链接列表
        for ask_url in result_list.items():
            question_urls.append(ask_url.attr("href"))
        while None in question_urls:
            question_urls.remove(None)
            # 去除None

        for url in question_urls:
            yield response.follow(url, callback=self.detail_page)

        result.make_links_absolute(base_url="http://you.ctrip.com/")
        # 把相对路径转换成绝对路径
        next_link = result(".nextpage")
        next_url = next_link.attr("href")
        # 下一页
        if next_url is not None:
            # 如果下一页不为空
            yield scrapy.Request(next_url, callback=self.list_page)

    def detail_page(self, response):
        detail = pq(response.text)
        question_frame = detail(".detailmain")
        # 问答框

        for i_item in question_frame.items():
            ask = QuestionandanswerItem()
            ask["question"] = i_item(".ask_title").text()
            ask["full_question"] = i_item("#host_asktext").text()
            ask["keyword"] = i_item(".asktag_oneline.cf").text()
            ask["ask_time"] = i_item(".ask_time").text().strip("发表于")
            ask["accept_answer"] = i_item(".bestanswer_con > div > p.answer_text").text()
            ask["recommend_answer"] = i_item(".youyouanswer_con > div > p.answer_text").text()
            ask["agree_answer"] = i_item("#replyboxid > ul > li:nth-child(1) > div > p.answer_text").text()
            yield ask
items.py:
# -*- coding: utf-8 -*-

# Define here the models for your scraped items
#
# See documentation in:
# https://doc.scrapy.org/en/latest/topics/items.html

import scrapy

class QuestionandanswerItem(scrapy.Item):
    # define the fields for your item here like:
    # name = scrapy.Field()

    question = scrapy.Field()
    # 问题的标题
    full_question = scrapy.Field()
    # 问题的详情
    keyword = scrapy.Field()
    # 关键字
    ask_time = scrapy.Field()
    # 提问时间
    accept_answer = scrapy.Field()
    # 提问者采纳的答案
    recommend_answer = scrapy.Field()
    # 旅游推荐的答案
    agree_answer = scrapy.Field()
    # 赞同数最高的答案
MySQLPipline.py:
from pymysql import connect

class MySQLPipeline(object):
    def __init__(self):
        self.connect = connect(
            host='192.168.1.108',
            port=3306,
            db='scrapy',
            user='root',
            passwd='Abcdef@123456',
            charset='utf8',
            use_unicode=True)
        # MySQL数据库
        self.cursor = self.connect.cursor()
        # 使用cursor()方法获取操作游标

    def process_item(self, item, spider):
        self.cursor.execute(
            """select * from guilin_ask WHERE question = %s""",
            item['question'])
        # 是否有重复问题
        repetition = self.cursor.fetchone()

        if repetition:
            pass
        # 丢弃

        else:
            self.cursor.execute(
                """insert into guilin_ask(
question, full_question, keyword, ask_time, accept_answer, recommend_answer, agree_answer)
VALUE (%s, %s, %s, %s, %s, %s, %s)""",
                (item['question'],
                 item['full_question'],
                 item['keyword'],
                 item['ask_time'],
                 item['accept_answer'],
                 item['recommend_answer'],
                 item['agree_answer']
                 ))
            # 执行sql语句,item里面定义的字段和表字段一一对应
            self.connect.commit()
            # 提交
            return item
            # 返回item

    def close_spider(self, spider):
        self.cursor.close()
        # 关闭游标
        self.connect.close()
        # 关闭数据库连接
Scrapy爬取携程桂林问答的更多相关文章
- 使用requests、re、BeautifulSoup、线程池爬取携程酒店信息并保存到Excel中
import requests import json import re import csv import threadpool import time, random from bs4 impo ...
- Scrapy爬取美女图片 (原创)
有半个月没有更新了,最近确实有点忙.先是华为的比赛,接着实验室又有项目,然后又学习了一些新的知识,所以没有更新文章.为了表达我的歉意,我给大家来一波福利... 今天咱们说的是爬虫框架.之前我使用pyt ...
- 【转载】教你分分钟学会用python爬虫框架Scrapy爬取心目中的女神
原文:教你分分钟学会用python爬虫框架Scrapy爬取心目中的女神 本博文将带领你从入门到精通爬虫框架Scrapy,最终具备爬取任何网页的数据的能力.本文以校花网为例进行爬取,校花网:http:/ ...
- scrapy爬取西刺网站ip
# scrapy爬取西刺网站ip # -*- coding: utf-8 -*- import scrapy from xici.items import XiciItem class Xicispi ...
- scrapy爬取豆瓣电影top250
# -*- coding: utf-8 -*- # scrapy爬取豆瓣电影top250 import scrapy from douban.items import DoubanItem class ...
- scrapy爬取极客学院全部课程
# -*- coding: utf-8 -*- # scrapy爬取极客学院全部课程 import scrapy from pyquery import PyQuery as pq from jike ...
- scrapy爬取全部知乎用户信息
# -*- coding: utf-8 -*- # scrapy爬取全部知乎用户信息 # 1:是否遵守robbots_txt协议改为False # 2: 加入爬取所需的headers: user-ag ...
- Scrapy爬取Ajax(异步加载)网页实例——简书付费连载
这两天学习了Scrapy爬虫框架的基本使用,练习的例子爬取的都是传统的直接加载完网页的内容,就想试试爬取用Ajax技术加载的网页. 这里以简书里的优选连载网页为例分享一下我的爬取过程. 网址为: ht ...
- Scrapy爬取静态页面
Scrapy爬取静态页面 安装Scrapy框架: Scrapy是python下一个非常有用的一个爬虫框架 Pycharm下: 搜索Scrapy库添加进项目即可 终端下: #python2 sudo p ...
随机推荐
- 个人技术博客(1/2)android布局技巧
(1)weight属性的合理应用 当使用match_parent(fill_parent)时,需要经过计算,否则会出现如下情况 代码: <LinearLayout xmlns:android=& ...
- python第十二课——for in循环
1.for...in循环: 有两个使用场景: 场景一:for in和range对象配合使用 range对象的引入讲解 格式:range([start,end,step]): 特点:索引满足含头不含尾的 ...
- redis-Sentinel配置
Sentinel介绍 Redis的主从模式下,主节点一旦发生故障不能提供服务,需要人 工干预,将从节点晋升为主节点,同时还需要修改客户端配置. 对于很多应用场景这种方式无法接受. Redis从 2.8 ...
- 20165318 2017-2018-2 《Java程序设计》第四周学习总结
20165318 2017-2018-2 <Java程序设计>第四周学习总结 IDEA安装 按照娄老师Intellj IDEA 简易教程,我下载了IDEA但是由于没有注册学校邮箱,我没办法 ...
- 线性dp
线性dp应该是dp中比较简单的一类,不过也有难的.(矩乘优化递推请出门右转) 线性dp一般是用前面的状态去推后面的,也有用后面往前面推的,这时候把循环顺序倒一倒就行了.如果有的题又要从前往后推又要从后 ...
- 【洛谷】【动态规划/二维背包】P1855 榨取kkksc03
[题目描述:] ... (宣传luogu2的内容被自动省略) 洛谷的运营组决定,如果...,那么他可以浪费掉kkksc03的一些时间的同时消耗掉kkksc03的一些金钱以满足自己的一个愿望. Kkks ...
- numpy的array数据类型(创建)
import numpy as np # 创建 # 创建一维数组 a = np.array([1, 2, 3]) print(a) ''' [1 2 3] ''' # 创建多维数组 b = np.ar ...
- centos下mysqlreport安装和使用
首先查看你的机器是否安装了perl: #perl -v 显示版本号即表示已安装 然后: #yum install perl-DBD-mysql perl-DBI #yum install mysqlr ...
- Linux禁用root账户ssh登录
前言 今天登录服务器的时候,控制台输出如下信息 There were 48990 failed login attempts since the last successful login. Last ...
- active developer path ("/Applications/Xcode.app/Contents/Developer")
-> git xcrun: error: active developer path ("/Applications/Xcode.app/Contents/Developer" ...