
Python爬虫之简单的爬取百度贴吧数据
首先要使用的第类库有 urllib下的request 以及urllib下的parse 以及 time包 random包
之后我们定义一个名叫BaiduSpider类用来爬取信息
属性有 url:用来爬取的网址 headers:请求头
class BaiduSpider(object):

    def __init__(self):

        self.url = 'http://tieba.baidu.com/f?kw={}&pn={}'

        self.headers = {'User-Agent':'Win7:Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/535.1 (KHTML, like Gecko) Chrome/14.0.835.163 Safari/535.1'}
之后我们定义三个方法 不涉及清洗数据
获取页面
 #获取页面

     def get_page(self,url):

         #定义请求对象

         req = request.Request(url=url,headers=self.headers)

         #发起请求

         res = request.urlopen(req)

         #获取相应对象

         html = res.read().decode('utf-8', 'ignore')

         return html
保存数据
#保存数据

    def write_page(self,filename,html):

        #将数据保存到本地

        with open(filename,'w',encoding='utf-8') as f:

            f.write(html)
主函数
#主函数

    def main(self):

        name = input('请输入贴吧名:>>>>')

        start = int(input('请输入起始页'))

        end = int(input('请输入终止页'))

        for page in range(start,end+1):

            #拼接URL地址 'http://tieba.baidu.com/f?kw{}&pn={}'

            #进行编码 将中文字符编码为url地址编码

            kw = parse.quote(name)

            #获取当前页数

            pn = (page-1)*50

            #进行url地址的拼接

            url = self.url.format(kw,pn)

            #获取相应

            html = self.get_page(url)

            filename = '{}-第{}页.html'.format(name,page)

            self.write_page(filename,html)

            #提示

            print('第{}页爬取成功'.format(page))

            #控制爬取速度

            time.sleep(random.randint(1,3))
最后 所有的代码展示如下
#导入模块

from urllib import request,parse

import time

import random

class BaiduSpider(object):

    def __init__(self):

        self.url = 'http://tieba.baidu.com/f?kw={}&pn={}'

        self.headers = {'User-Agent':'Win7:Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/535.1 (KHTML, like Gecko) Chrome/14.0.835.163 Safari/535.1'}

    #获取页面

    def get_page(self,url):

        #定义请求对象

        req = request.Request(url=url,headers=self.headers)

        #发起请求

        res = request.urlopen(req)

        #获取相应对象

        html = res.read().decode('utf-8', 'ignore')

        return html

    #解析数据

    def parse_page(self):

        pass

    #保存数据

    def write_page(self,filename,html):

        #将数据保存到本地

        with open(filename,'w',encoding='utf-8') as f:

            f.write(html)

    #主函数

    def main(self):

        name = input('请输入贴吧名:>>>>')

        start = int(input('请输入起始页'))

        end = int(input('请输入终止页'))

        for page in range(start,end+1):

            #拼接URL地址 'http://tieba.baidu.com/f?kw{}&pn={}'

            #进行编码 将中文字符编码为url地址编码

            kw = parse.quote(name)

            #获取当前页数

            pn = (page-1)*50

            #进行url地址的拼接

            url = self.url.format(kw,pn)

            #获取相应

            html = self.get_page(url)

            filename = '{}-第{}页.html'.format(name,page)

            self.write_page(filename,html)

            #提示

            print('第{}页爬取成功'.format(page))

            #控制爬取速度

            time.sleep(random.randint(1,3))

if __name__ == '__main__':

    spider = BaiduSpider()

    spider.main()
一个非常非常简单的爬虫就完成了 让我们看一下运行效果截图:
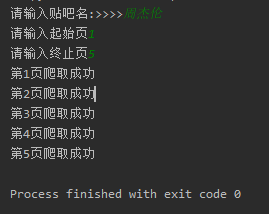
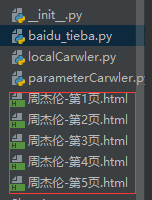
html文件打开后 与我们正常打开的网页并没有太大的差别
Python爬虫之简单的爬取百度贴吧数据的更多相关文章
- Python爬虫实战二之爬取百度贴吧帖子
大家好,上次我们实验了爬取了糗事百科的段子,那么这次我们来尝试一下爬取百度贴吧的帖子.与上一篇不同的是,这次我们需要用到文件的相关操作. 前言 亲爱的们,教程比较旧了,百度贴吧页面可能改版,可能代码不 ...
- 转 Python爬虫实战二之爬取百度贴吧帖子
静觅 » Python爬虫实战二之爬取百度贴吧帖子 大家好,上次我们实验了爬取了糗事百科的段子,那么这次我们来尝试一下爬取百度贴吧的帖子.与上一篇不同的是,这次我们需要用到文件的相关操作. 本篇目标 ...
- Python爬虫:为什么你爬取不到网页数据
前言: 之前小编写了一篇关于爬虫为什么爬取不到数据文章(文章链接为:Python爬虫经常爬不到数据,或许你可以看一下小编的这篇文章), 但是当时小编也是胡乱编写的,其实里面有很多问题的,现在小编重新发 ...
- Python开发简单爬虫(二)---爬取百度百科页面数据
一.开发爬虫的步骤 1.确定目标抓取策略: 打开目标页面,通过右键审查元素确定网页的url格式.数据格式.和网页编码形式. ①先看url的格式, F12观察一下链接的形式;② 再看目标文本信息的标签格 ...
- Python爬虫:通过关键字爬取百度图片
使用工具:Python2.7 点我下载 scrapy框架 sublime text3 一.搭建python(Windows版本) 1.安装python2.7 ---然后在cmd当中输入python,界 ...
- Python 基础语法+简单地爬取百度贴吧内容
Python笔记 1.Python3和Pycharm2018的安装 2.Python3基础语法 2.1.1.数据类型 2.1.1.1.数据类型:数字(整数和浮点数) 整数:int类型 浮点数:floa ...
- Python爬虫入门教程 42-100 爬取儿歌多多APP数据-手机APP爬虫部分
1. 儿歌多多APP简单分析 今天是手机APP数据爬取的第一篇案例博客,我找到了一个儿歌多多APP,没有加固,没有加壳,没有加密参数,对新手来说,比较友好,咱就拿它练练手,熟悉一下Fiddler和夜神 ...
- 【学习笔记】Python 3.6模拟输入并爬取百度前10页密切相关链接
[学习笔记]Python 3.6模拟输入并爬取百度前10页密切相关链接 问题描述 通过模拟网页,实现百度搜索关键词,然后获得网页中链接的文本,与准备的文本进行比较,如果有相似之处则代表相关链接. me ...
- python爬虫:了解JS加密爬取网易云音乐
python爬虫:了解JS加密爬取网易云音乐 前言 大家好,我是"持之以恒_liu",之所以起这个名字,就是希望我自己无论做什么事,只要一开始选择了,那么就要坚持到底,不管结果如何 ...
随机推荐
- TTTTTTTTTTTTTTTTTTTTT POJ 3690 0与* 二维哈希 模板 +multiset
Constellations Time Limit: 3000MS Memory Limit: 65536K Total Submissions: 5923 Accepted: 1164 De ...
- luogu P1362 兔子数 x
P1362 兔子数 题目描述 设 S(N ) 表示 N 的各位数字之和,如 S(484) = 4+8+4 = 16, S(22) = 2+2 = 4.如果一个正整数满足 S(x*x) = S(x) * ...
- 2-SAT (two-statisfiability) 算法 学习笔记
$2-SAT$问题指的是对于若干限制求出一组可行解的问题. 考虑对于$n$个值域为${0,1}$的变量$x_1 , x_2 ,...,x_n$ 满足若干限制: 若 $x_i = p$ 则 $x_j = ...
- Jmeter(四)Cookie管理器
上一节中我们用Jmeter通过接口上传了一张图片到人人网,其中请求头中的Cookie是写死的,这个Cookie其实是登录成功后服务器返回给客户端的,客户端接收到这个Cookie后保存下来,在后续向服务 ...
- JS框架_(Typed.js)彩色霓虹灯发光文字动画
百度云盘 传送门 密码:8oei 发光文字动画效果: <!doctype html> <html> <head> <meta charset="ut ...
- sonarqube修改自己的图像avatar
https://community.sonarsource.com/t/how-can-i-change-my-avatar/11457/2 Hi, User icons are provided b ...
- 利用docker启动 wordpress
网上有很多教程哈,我只是记录自己怎么玩的,没啥教学意义 查看镜像说明的mysql/data目录,方便挂载 [root@docker ~]# docker inspect -f {{.Config.Vo ...
- JAVA基础面试汇总
一.基础知识:1.JVM.JRE和JDK的区别: JVM(Java Virtual Machine):java虚拟机,用于保证java的跨平台的特性. java ...
- pandas中根据列的值选取多行数据
# 选取等于某些值的行记录 用 == df.loc[df['column_name'] == some_value] # 选取某列是否是某一类型的数值 用 isin df.loc[df['column ...
- 通过jenkins-Python在后台操作Jenkins构建job
最近要开发1个接口,接收到1个指令后自动触发自动化测试,虽然也可以通过shell命令做这一步,但因为目前所有构建自动化的的动作都通过jenkins完成,所以想要尝试能不能用python去控制jenki ...