
python 使用selenium模块爬取同一个url下不同页的内容(浏览器模拟人工翻页)
页面翻页,下一页可能是一个新的url
也有可能是用js进行页面跳转,url不变,解决方法是实现浏览器模拟人工翻页
目标:爬取同一个url下不同页的数据(上述第二种情况)
url:http://www.gx211.com/collegemanage/search.aspx?id=1&xxcity=1
中国高校之窗,我要爬取北京市所有的学校列表,共有四页数据,四页都是同一个url。
部分页面如图:
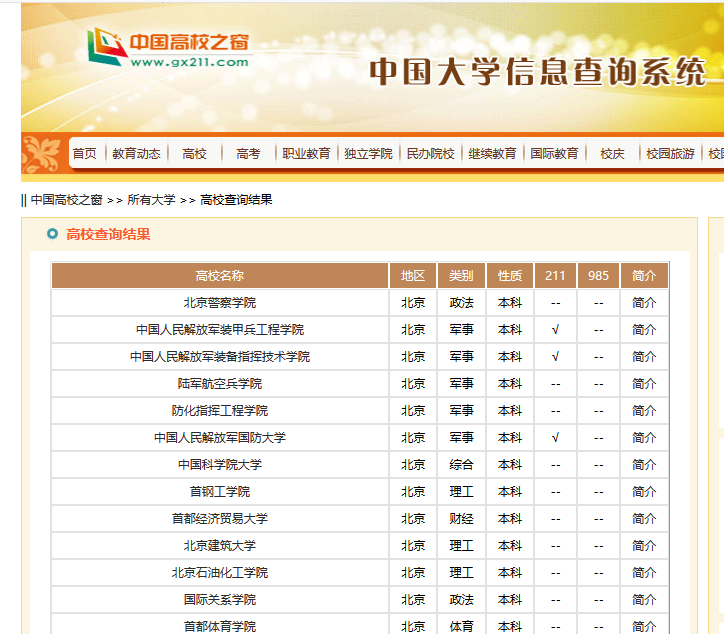
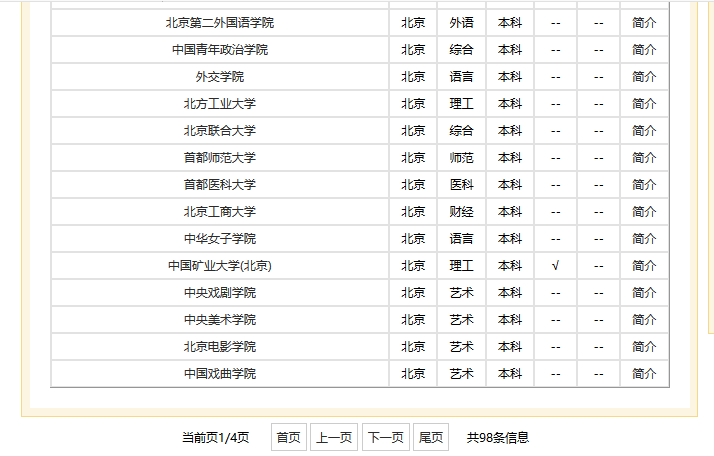
找到“下一页”按钮的源码,确认是用js进行的跳转。

工具:
- selenium
- pyquery
- 火狐浏览器
代码:
from selenium import webdriver

from selenium.webdriver.support.wait import WebDriverWait

from pyquery import PyQuery as pq

#

# 爬取北京市所有的学校

#

browser = webdriver.Firefox()  # 创建一个浏览器对象,这里还可以使用chrome等浏览器

try:

    BJuniv = []

    browser.get('http://www.gx211.com/collegemanage/search.aspx?id=1&xxcity=1') # 获取并打开url

    for r in range(4):

        html = browser.page_source  # 获取html页面

        doc = pq(html)              # 解析html

        table = doc('.content tbody')  # 定位到表格

        table.find('script').remove()  # 除去script标签

        list_cont = table('tr').items()  # 获取tr标签列表

        for i in list_cont:

            univ = (i.text()).split()  # 获取每个tr标签中的文本信息,返回一个列表

            print(univ)

            BJuniv.append(univ)

        nextpagebutton = browser.find_element_by_xpath('//*[@id="Lk_Down"]')  # 定位到“下一页”按钮

        nextpagebutton.click()  # 模拟点击下一页

        wait = WebDriverWait(browser, 10)  # 浏览器等待10s

finally:

    browser.close()  # 关闭浏览器

    with open("北京市所有大学.txt", "wt", encoding='utf8') as out_file:  # 存储为txt格式

        out_file.write('全国各省学校名单:\n\n')

        for u in BJuniv:

            out_file.write(str(u) + '\n')
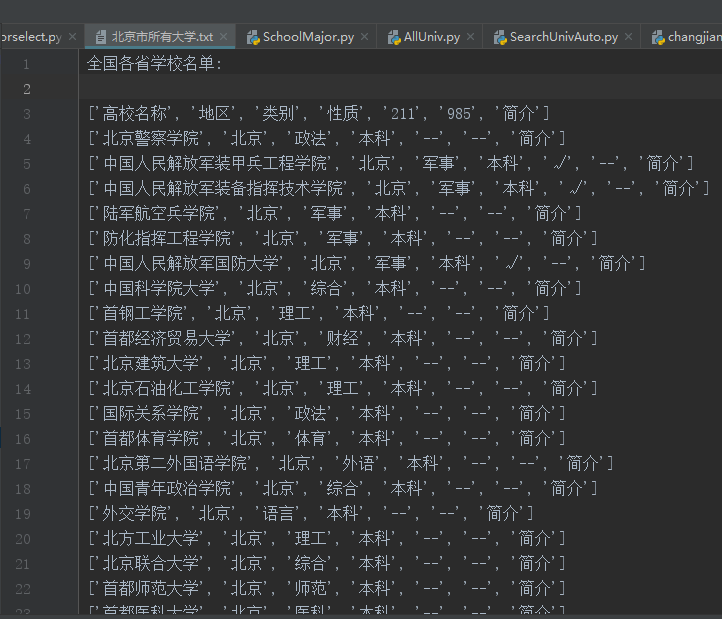
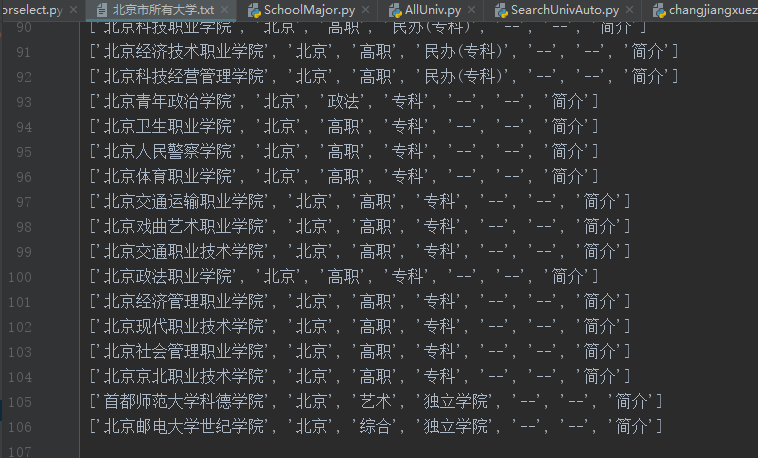
运行过程:自动打开浏览器,输入url,获取页面,点击下一页,重复直到循环结束。(过程看不到很细致的,跳转比较快)
运行结果(部分):
python 使用selenium模块爬取同一个url下不同页的内容(浏览器模拟人工翻页)的更多相关文章
- [python爬虫] Selenium定向爬取PubMed生物医学摘要信息
本文主要是自己的在线代码笔记.在生物医学本体Ontology构建过程中,我使用Selenium定向爬取生物医学PubMed数据库的内容. PubMed是一个免费的搜寻引擎,提供生物医学方 ...
- [python爬虫] Selenium定向爬取海量精美图片及搜索引擎杂谈
我自认为这是自己写过博客中一篇比较优秀的文章,同时也是在深夜凌晨2点满怀着激情和愉悦之心完成的.首先通过这篇文章,你能学到以下几点: 1.可以了解Python简单爬取图片的一些思路和方法 ...
- [python爬虫] Selenium定向爬取虎扑篮球海量精美图片
前言: 作为一名从小就看篮球的球迷,会经常逛虎扑篮球及湿乎乎等论坛,在论坛里面会存在很多精美图片,包括NBA球队.CBA明星.花边新闻.球鞋美女等等,如果一张张右键另存为的话真是手都点疼了.作为程序员 ...
- Python爬虫之使用Fiddler+Postman+Python的requests模块爬取各国国旗
介绍 本篇博客将会介绍一个Python爬虫,用来爬取各个国家的国旗,主要的目标是为了展示如何在Python的requests模块中使用POST方法来爬取网页内容. 为了知道POST方法所需要传 ...
- [爬虫]用python的requests模块爬取糗事百科段子
虽然Python的标准库中 urllib2 模块已经包含了平常我们使用的大多数功能,但是它的 API 使用起来让人感觉不太好,而 Requests 自称 “HTTP for Humans”,说明使用更 ...
- python的requests模块爬取网页内容
注意:处理需要用户名密码认证的网站,需要auth字段. # -*- coding:utf-8 -*- import requests headers = { "User-Agent" ...
- python实例:自动爬取豆瓣读书短评,分析短评内容
思路: 1.打开书本“更多”短评,复制链接 2.脚本分析链接,通过获取短评数,计算出页码数 3.通过页码数,循环爬取当页短评 4.短评写入到txt文本 5.读取txt文本,处理文本,输出出现频率最高的 ...
- [实战演练]python3使用requests模块爬取页面内容
本文摘要: 1.安装pip 2.安装requests模块 3.安装beautifulsoup4 4.requests模块浅析 + 发送请求 + 传递URL参数 + 响应内容 + 获取网页编码 + 获取 ...
- python+selenium+xpath 爬取天眼查工商基本信息
# -*- coding:utf-8 -*-# author: kevin# CreateTime: 2018/8/16# software-version: python 3.7 import ti ...
随机推荐
- linux服务基础(二)之httpd2.2基础配置
一.安装httpd服务 CentOS6 默认安装httpd2.2版本 CentOS7 默认安装httpd2.4版本 # yum install httpd 二.安装后相关文件说明 配置文件: /etc ...
- thinkphp3.2升级至thinkphp5.0.24
view文件 修改文件名 把tp3.2.3\app\module\view文件夹下所有文件夹拷贝至tp5\app\module\view 打开cmd命令窗口,cd至view文件夹下,执行dir /b ...
- /etc/security/limits.conf不生效
总结下来发现要使limits.conf生效,需要在 /etc/ssh/sshd_config 配置中 设置 UsePAM yes UseLogin yes #这个保证其他的用户也能修改设置 ...
- python yaml用法详解
YAML是一种直观的能够被电脑识别的的数据序列化格式,容易被人类阅读,并且容易和脚本语言交互.YAML类似于XML,但是语法比XML简单得多,对于转化成数组或可以hash的数据时是很简单有效的. Py ...
- git\CentOS6.5中gitlab安装教程
一.Git 起源: Git是一个开源的分布式版本控制系统,用于敏捷高效地处理任何或小或大的项目. Git 是 Linus Torvalds 为了帮助管理 Linux 内核开发而开发的一个开放源码的版本 ...
- CopyOnWriteArrayList与Collections.synchronizedList的性能对比(转)
列表实现有ArrayList.Vector.CopyOnWriteArrayList.Collections.synchronizedList(list)四种方式. 1 ArrayList Array ...
- vlog.hpp
//vov #ifndef VLOG_HPP #define VLOG_HPP #include <sys/time.h> #include <unistd.h> #ifnde ...
- [Linux]防火墙关闭与开启
防火墙关闭与开启 系统环境:ubuntu16.04 工具:xshell 测试远程主机的端口是否开启 telnet 192.168.xx.xx 80 防火墙关闭/开启/重启 # 防火墙关闭 sudo u ...
- [English] Time complexity wise this solution is the best among all
Time complexity wise this solution is the best among all, we can do all operations in O(1) time. 时间复 ...
- 【转】TCP、UDP、RTP(RTCP)区别
转自:https://www.cnblogs.com/imystr/p/4026639.html OSI七层模型OSI 中的层 功能 ...