
Cloudera Certified Associate Administrator案例之Configure篇
Cloudera Certified Associate Administrator案例之Configure篇
作者:尹正杰
版权声明:原创作品,谢绝转载!否则将追究法律责任。
一.下载CDH集群中最新的配置文件
问题描述:
  某个集群的使用者需要通过客户端登陆集群,请使用CM下载HDFS和YARN的配置文件,保存到客户端机器的"/home/yinzhengjie/hadoop/etc/hadoop"目录下,并保持文件名不变。

解决方案:
  可以通过登陆CM WebUI界面下载,也可以直接登陆服务器进行下载。
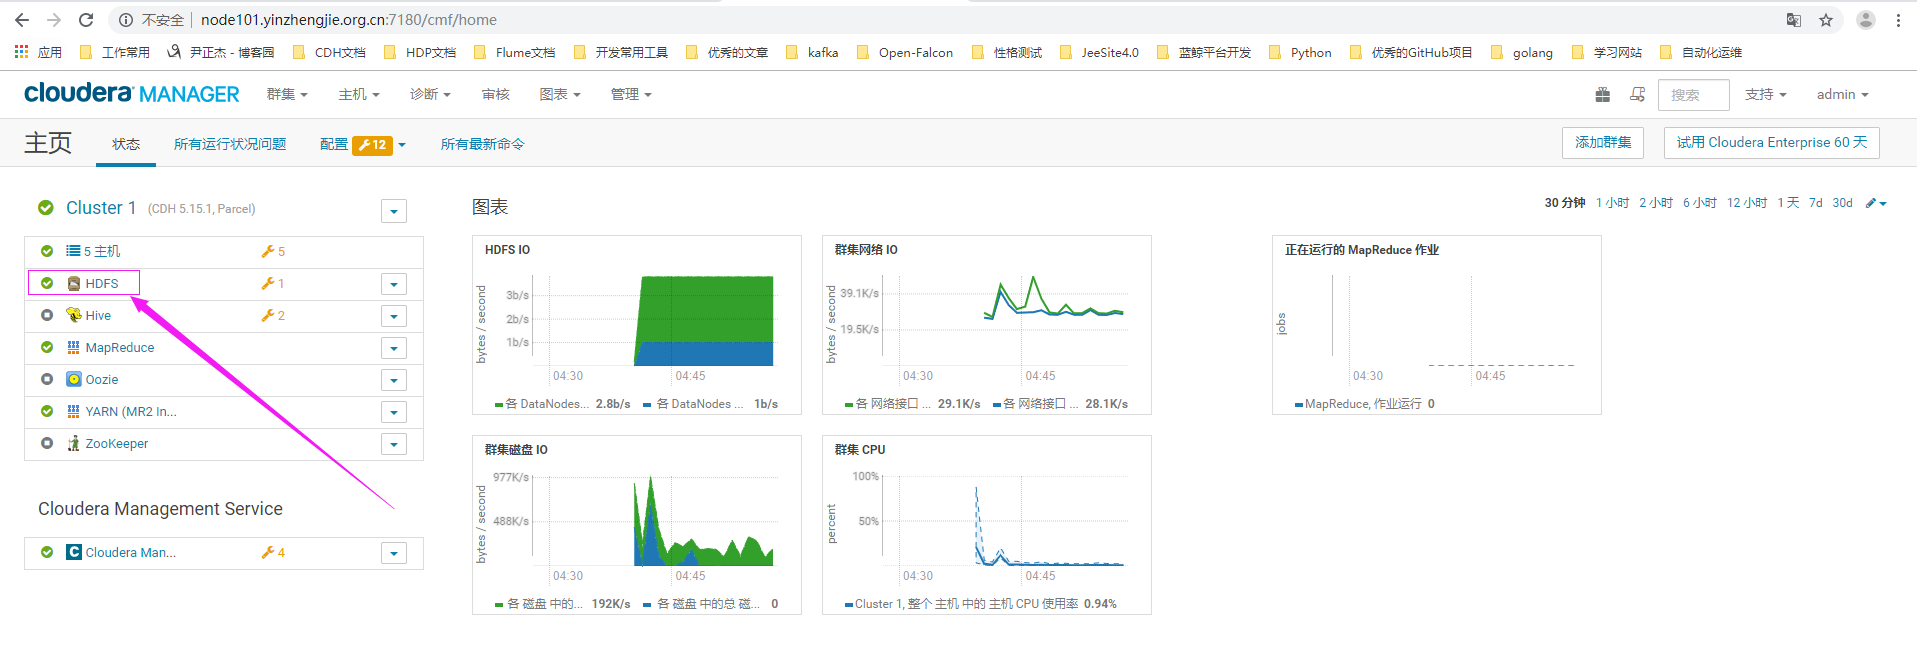
1>.使用正确的用户名密码登录CM界面,点击hdfs服务

2>. 下载HDFS的配置文件

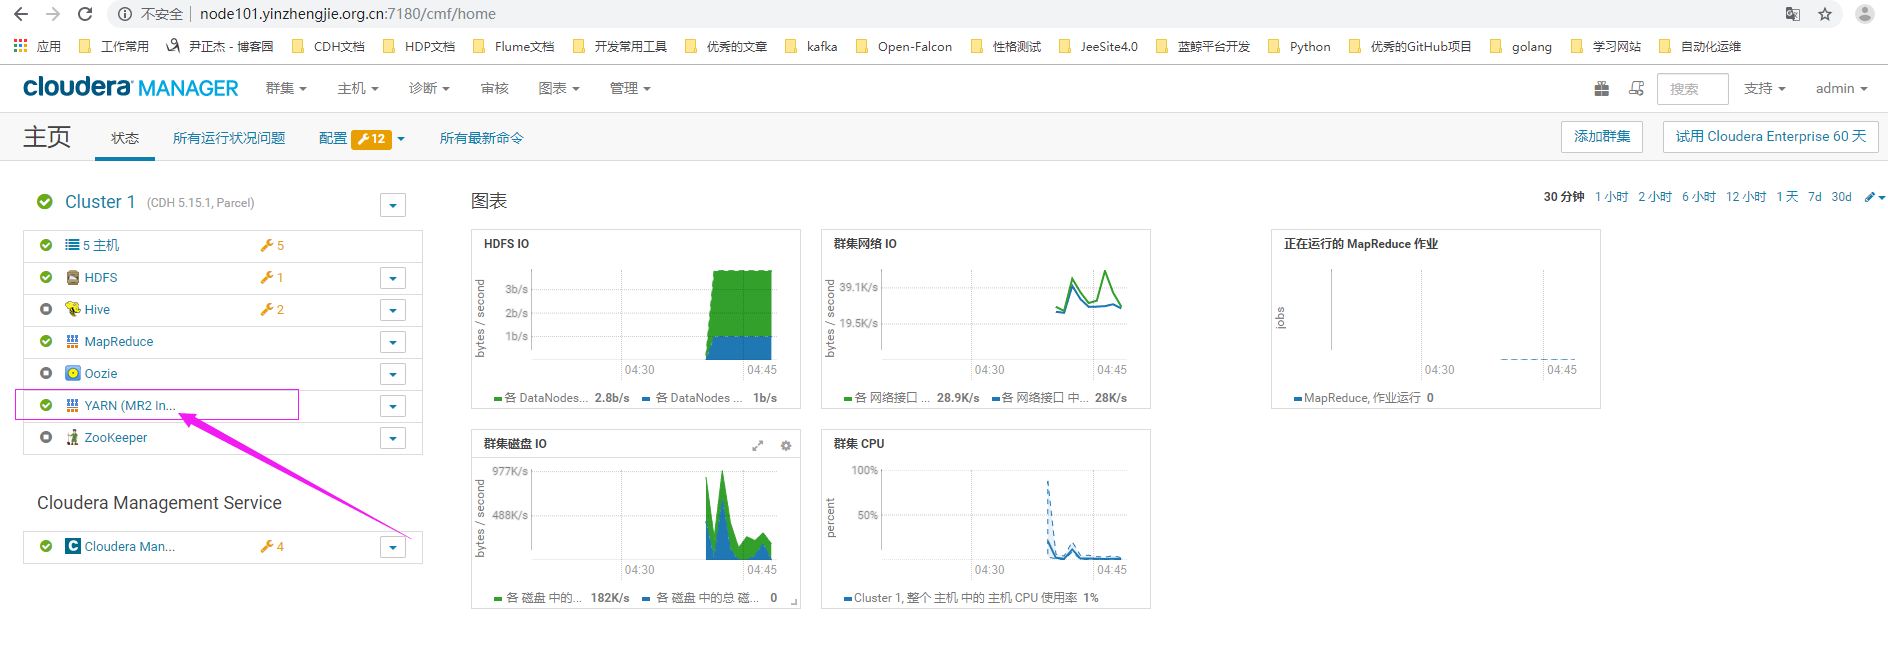
3>.使用正确的用户名密码登录CM界面,点击yarn服务
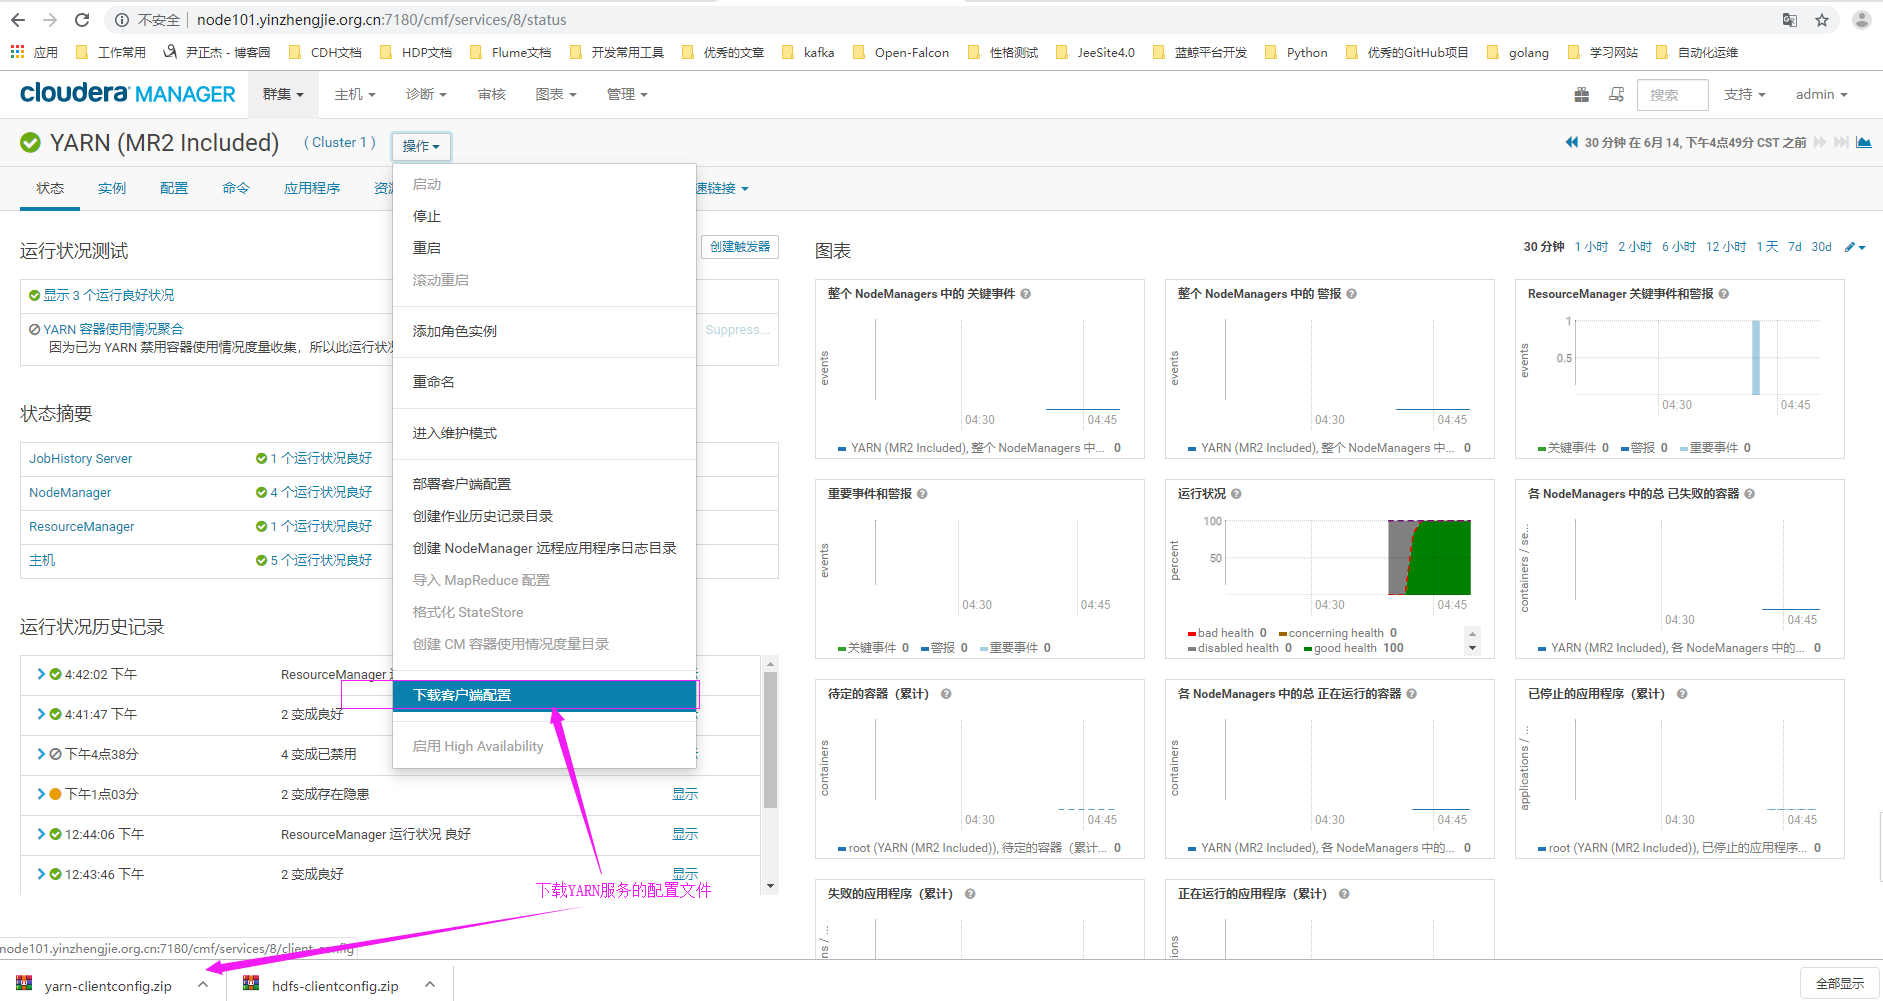
4>.下载YARN服务的配置文件
5>.查看集群后端存储配置文件的路径
[root@node101.yinzhengjie.org.cn ~]# ll /etc/hadoop/conf.cloudera.hdfs/        #HDFS集群存储路径

total

-rw-r--r--  root root    Jun  : __cloudera_generation__

-rw-r--r--  root root    Jun  : __cloudera_metadata__

-rw-r--r--  root root  Jun  : core-site.xml

-rw-r--r--  root root  Jun  : hadoop-env.sh

-rw-r--r--  root root  Jun  : hdfs-site.xml

-rw-r--r--  root root   Jun  : log4j.properties

-rw-r--r--  root root   Jun  : ssl-client.xml

-rw-r--r--  root root   Jun  : topology.map

-rwxr-xr-x  root root  Jun  : topology.py

[root@node101.yinzhengjie.org.cn ~]#

[root@node101.yinzhengjie.org.cn ~]#

[root@node101.yinzhengjie.org.cn ~]#

[root@node101.yinzhengjie.org.cn ~]# ll /etc/hadoop/conf.cloudera.yarn/      #YARN集群存储路径

total

-rw-r--r--  root root      Jun  : __cloudera_generation__

-rw-r--r--  root root      Jun  : __cloudera_metadata__

-rw-r--r--  root root    Jun  : core-site.xml

-rw-r--r--  root root     Jun  : hadoop-env.sh

-rw-r--r--  root root    Jun  : hdfs-site.xml

-rw-r--r--  root root     Jun  : log4j.properties

-rw-r--r--  root root    Jun  : mapred-site.xml

-rw-r--r--  root root     Jun  : ssl-client.xml

-rw-r--r--  root hadoop   Jun  : topology.map

-rwxr-xr-x  root hadoop  Jun  : topology.py

-rw-r--r--  root root    Jun  : yarn-site.xml

[root@node101.yinzhengjie.org.cn ~]#

[root@node101.yinzhengjie.org.cn ~]#
二.限制HDFS服务的日志大小
问题描述:
  根据管理要求,需要限制HDFS服务的日志大小。其限制为:NameNode服务保留4个日志文件,总量不超过8GB;Secondary NameNode 服务也保留4个日志文件,总量不超过8GB;两个服务总占用的磁盘空间 量不超过16GB。

解决方案:
  单个服务的单个日志只要不超 过2GB,并将日志数设为4个,即可以满足要求。
1>.使用正确的用户名密码登录CM界面,点击hdfs服务
2>.搜索关键字“NameNode Max Log Size”
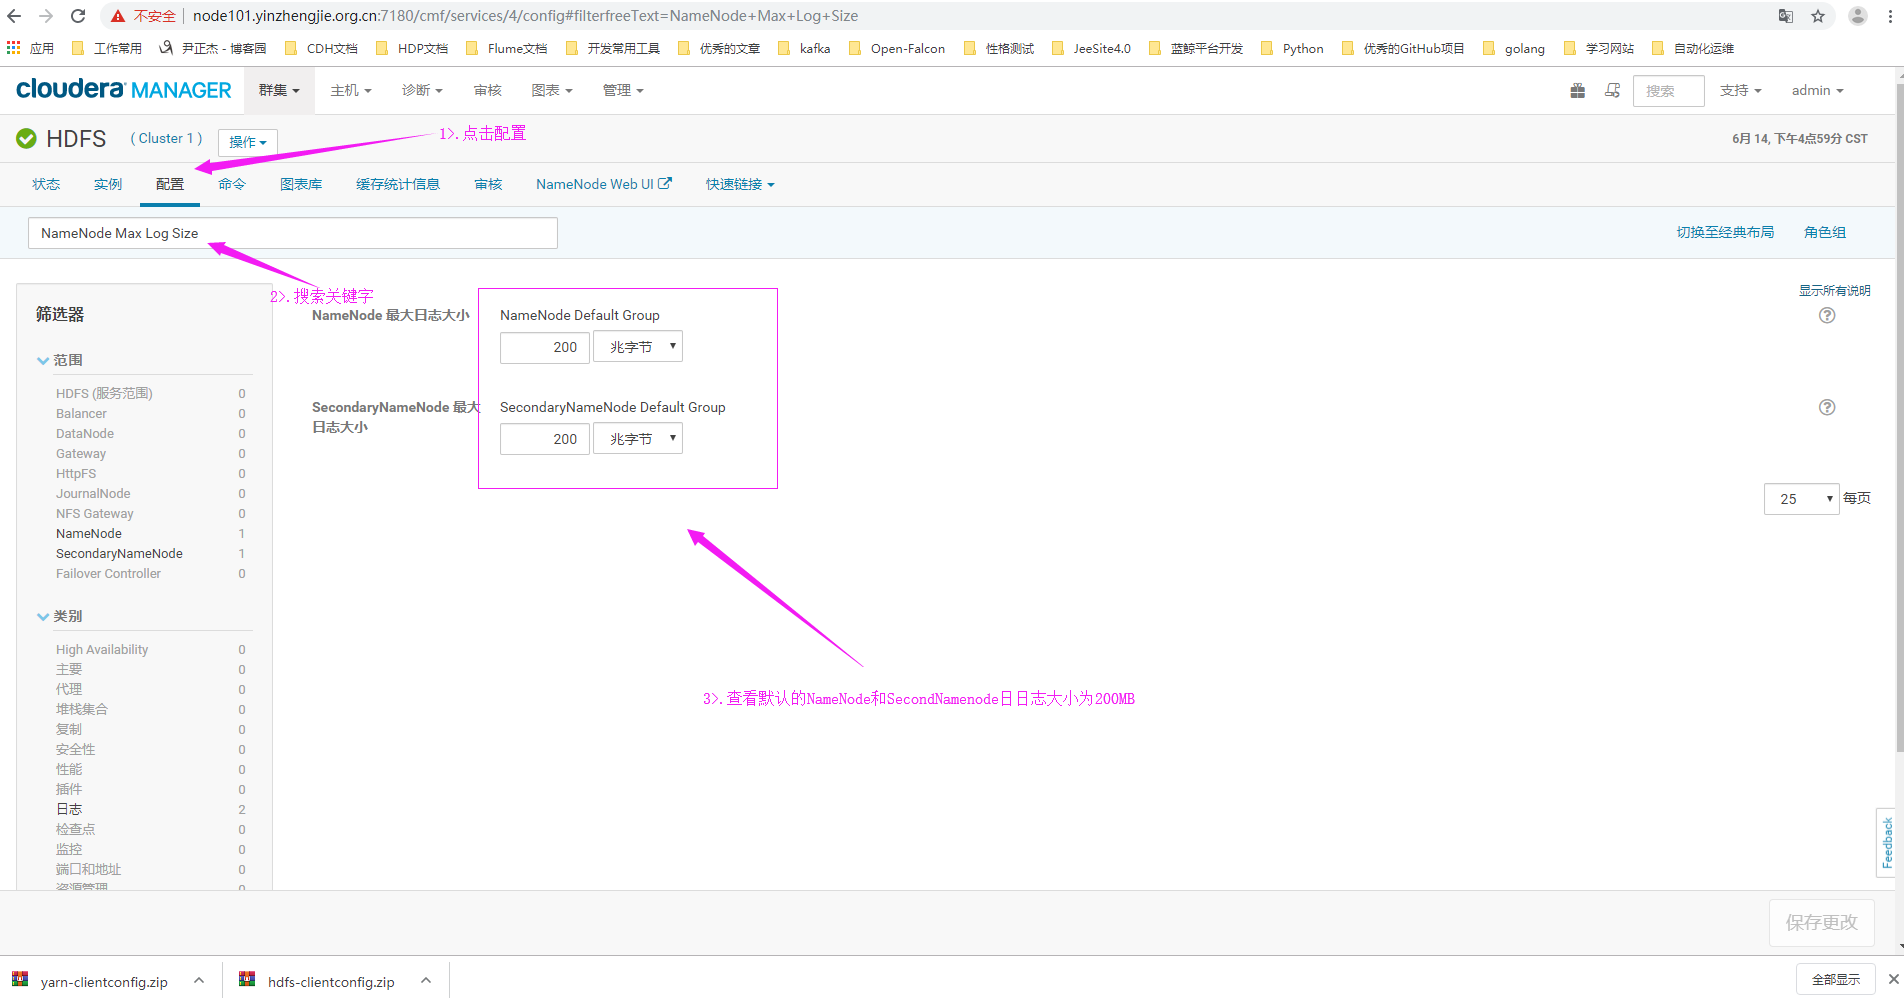
3>.修改默认值200MB为2GB并点击保存按钮

4>.搜索关键字“SecondaryNameNode Max Log Size”(中文对应:"SecondaryNameNode 最大日志文件备份")
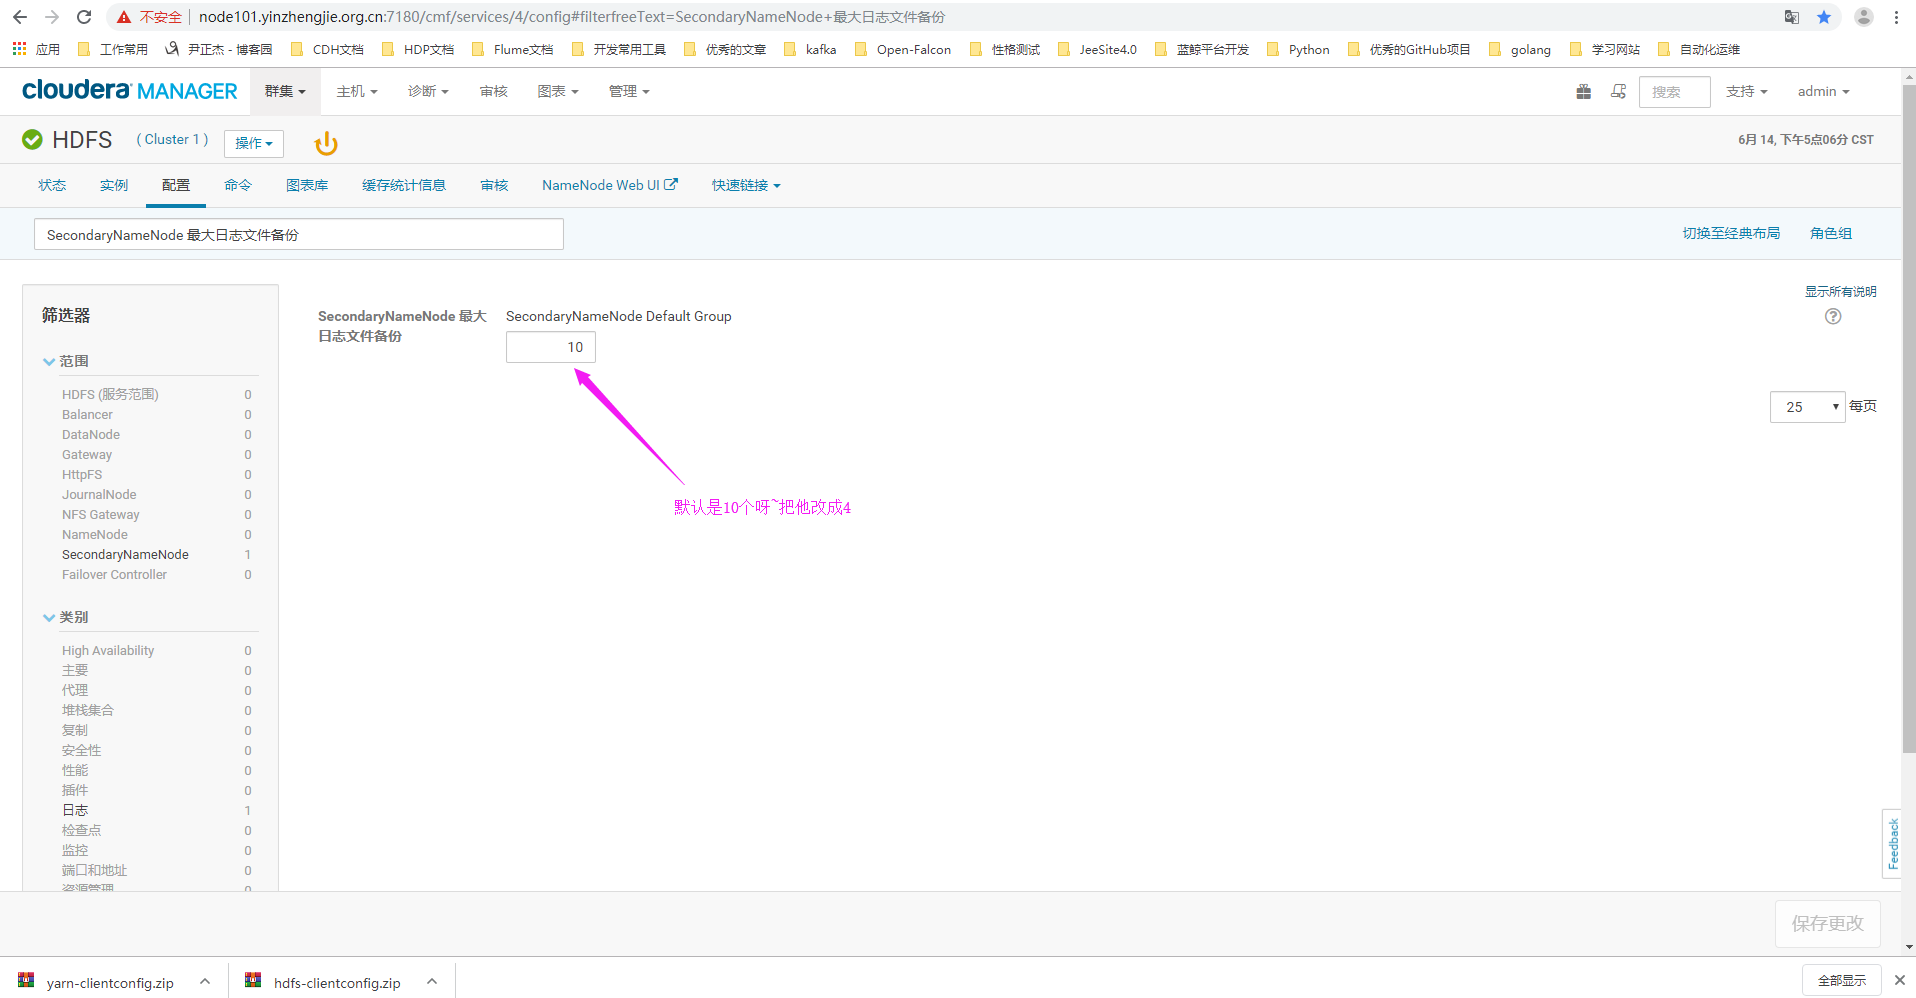
5>.修改日志文件的备份数为4
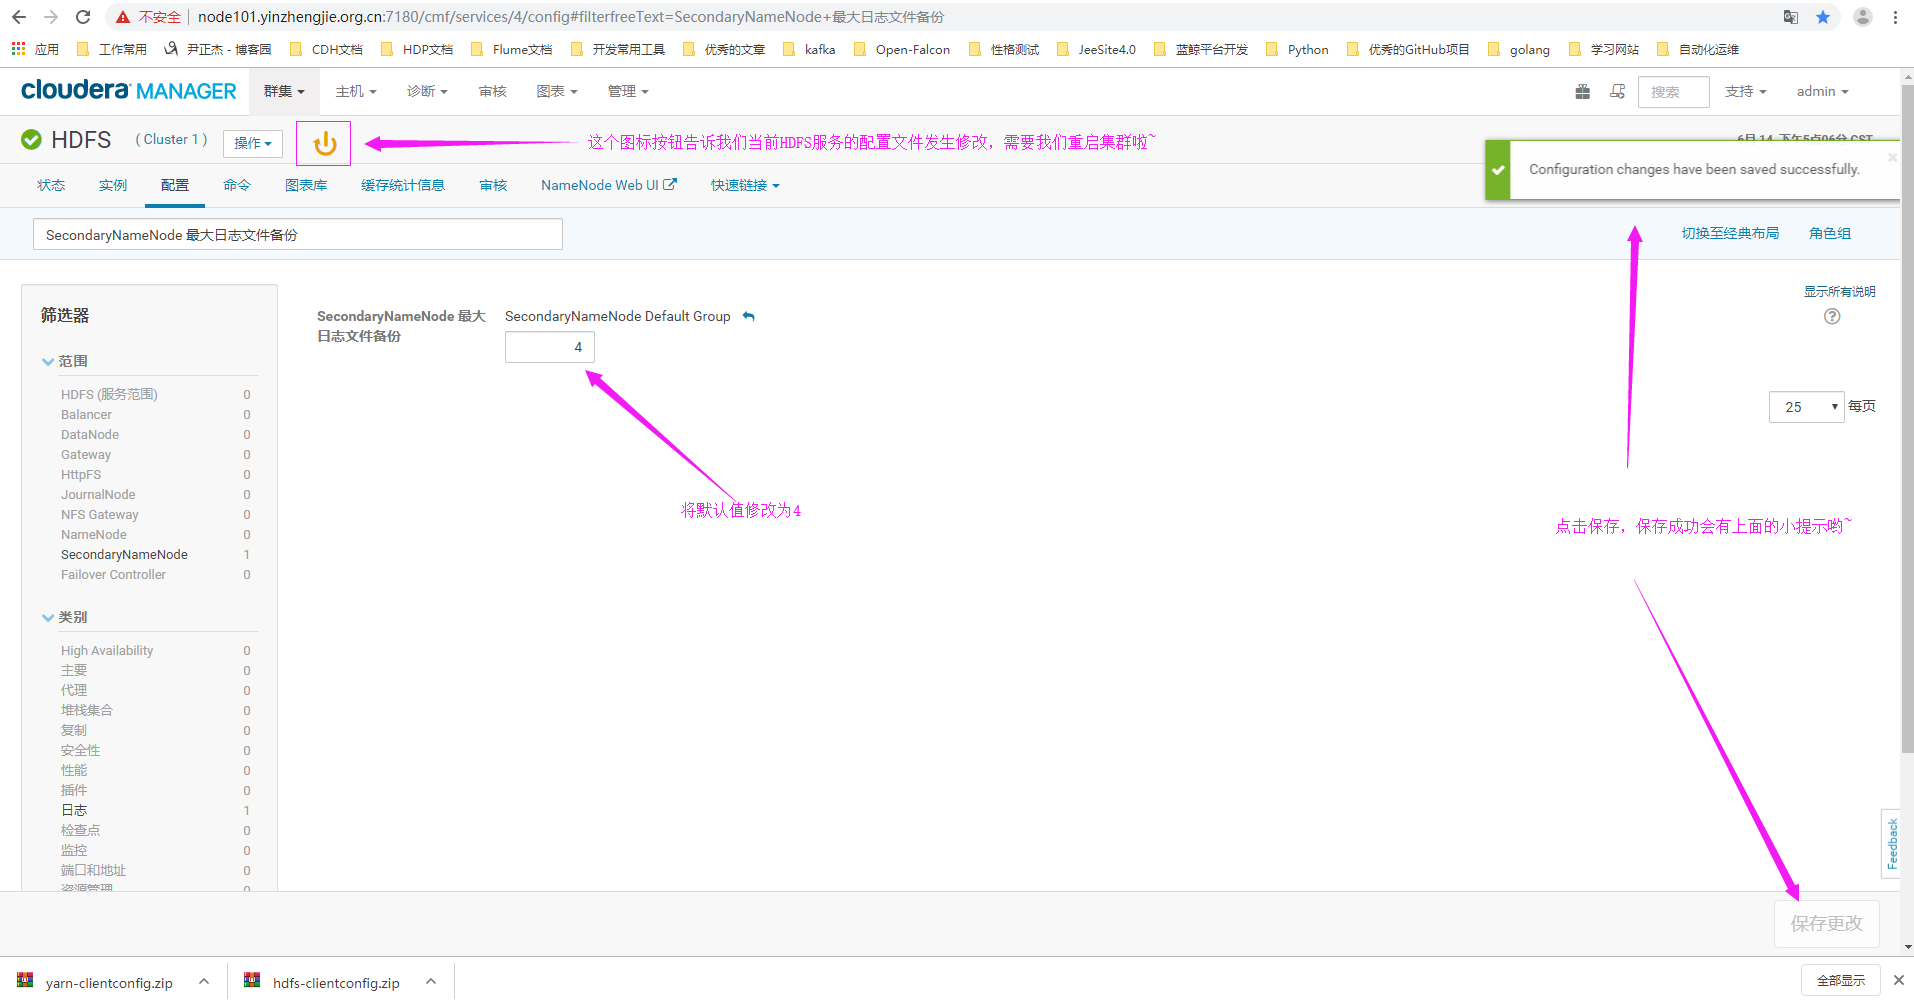
6>.重启HDFS服务

三.修改Namenode的堆内存
问题描述:

    集群承接了日志分析需求,将保存百万、千万数量级的文件,因 此需要扩大NameNode使用的堆内存,使其可以管理尽可能多的文件。物理内存的分配要求为:节点总物理内存为31GB,为系统服务保留的内存为6.2GB;NameNode和Secondary NameNode需设置相等大小的堆内存; 所有服务的堆内存均需要乘以1.3后计入总使用量中。需要为NameNode和相关服务配置尽可能大且满足要求的内存量,且不能触发任何警告。

解决方案:
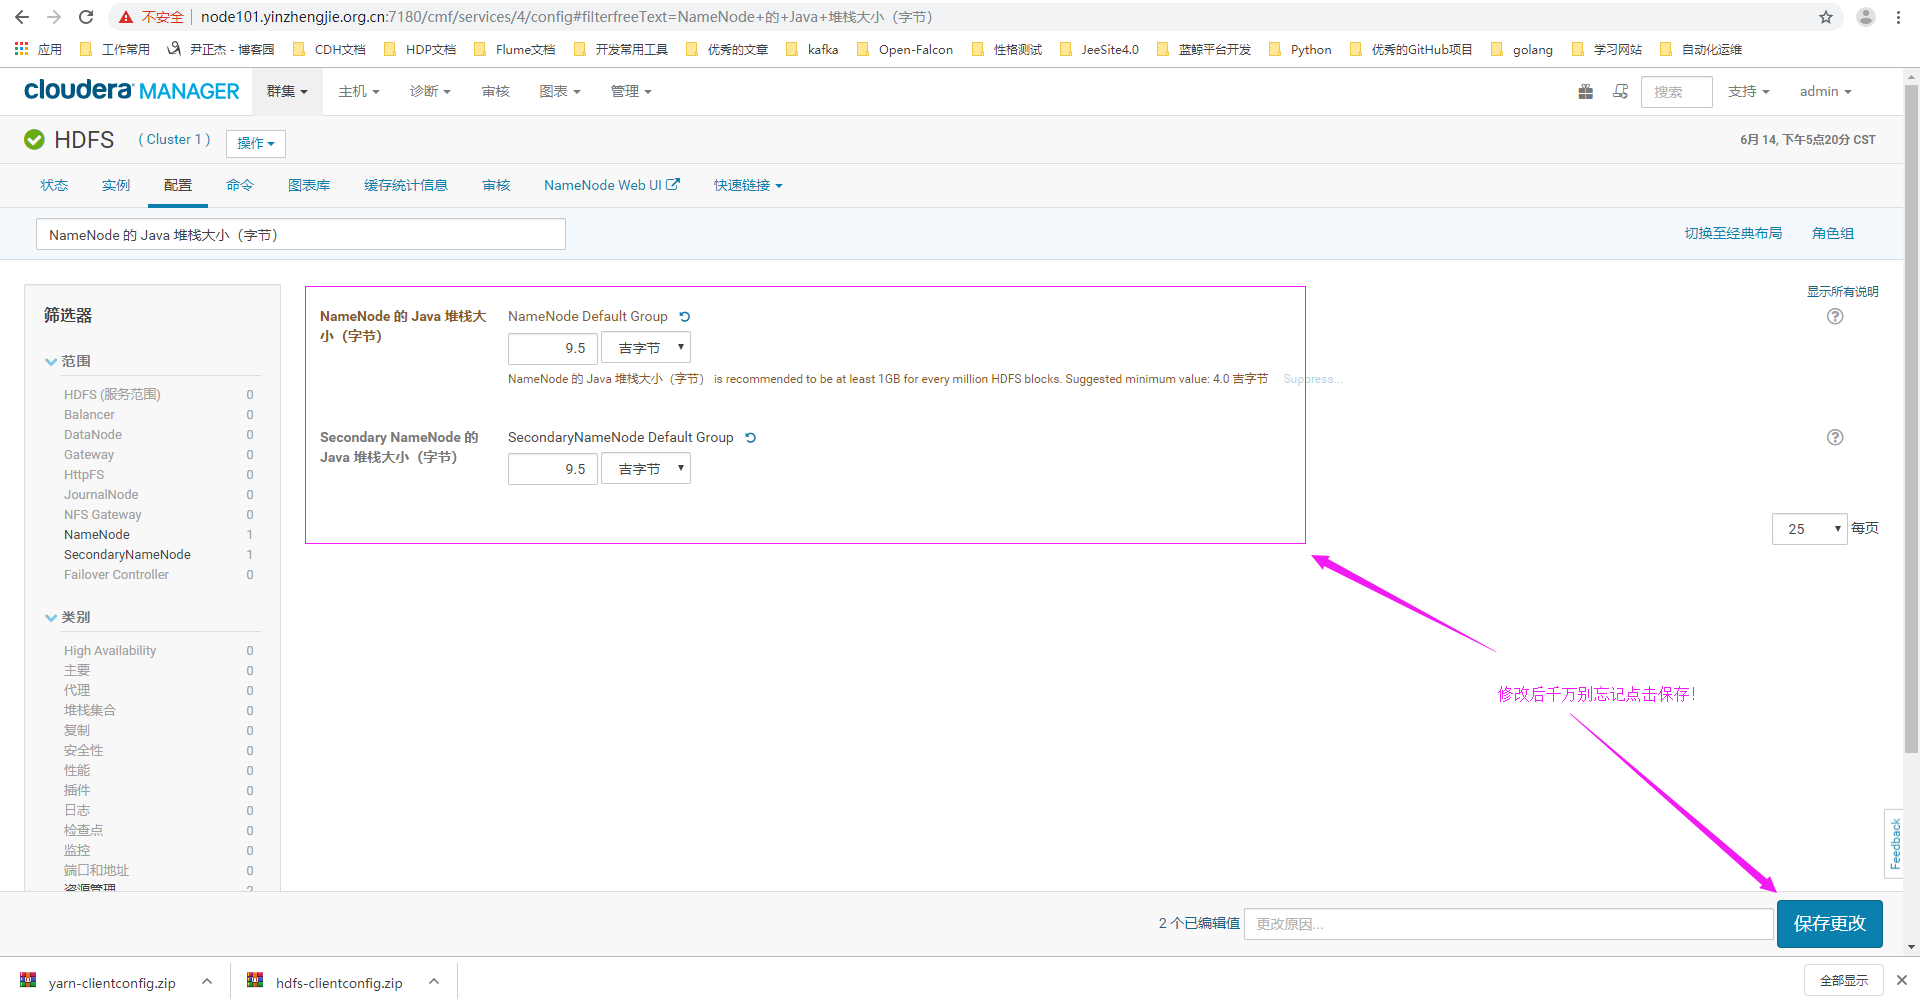
  根据计算(31 - 6.2) / 1.3 = 19,因此 NameNode和Secondary NameNode各可设置9.5GB的堆内存。
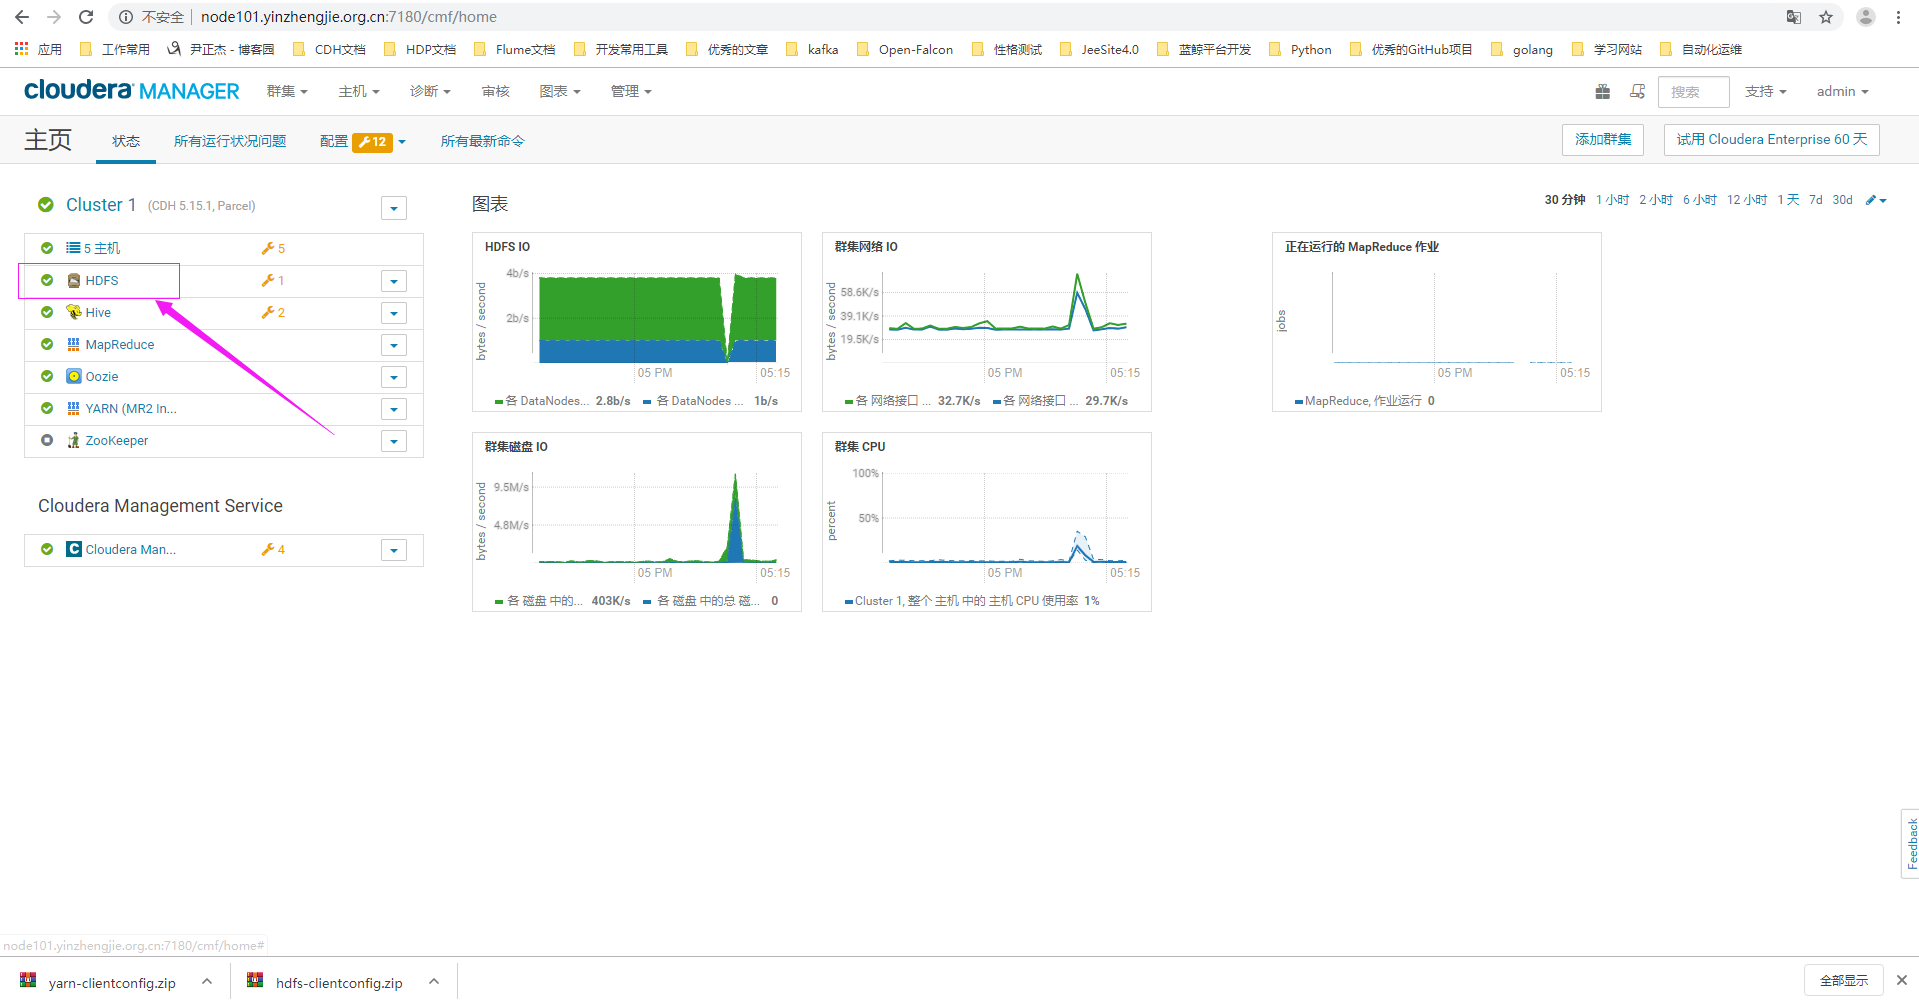
1>.使用正确的用户名密码登录CM界面,点击hdfs服务
2>.点击配置,搜索关键字“Java Heap Size of NameNode in Bytes”(对应中文为:"NameNode 的 Java 堆栈大小(字节)")
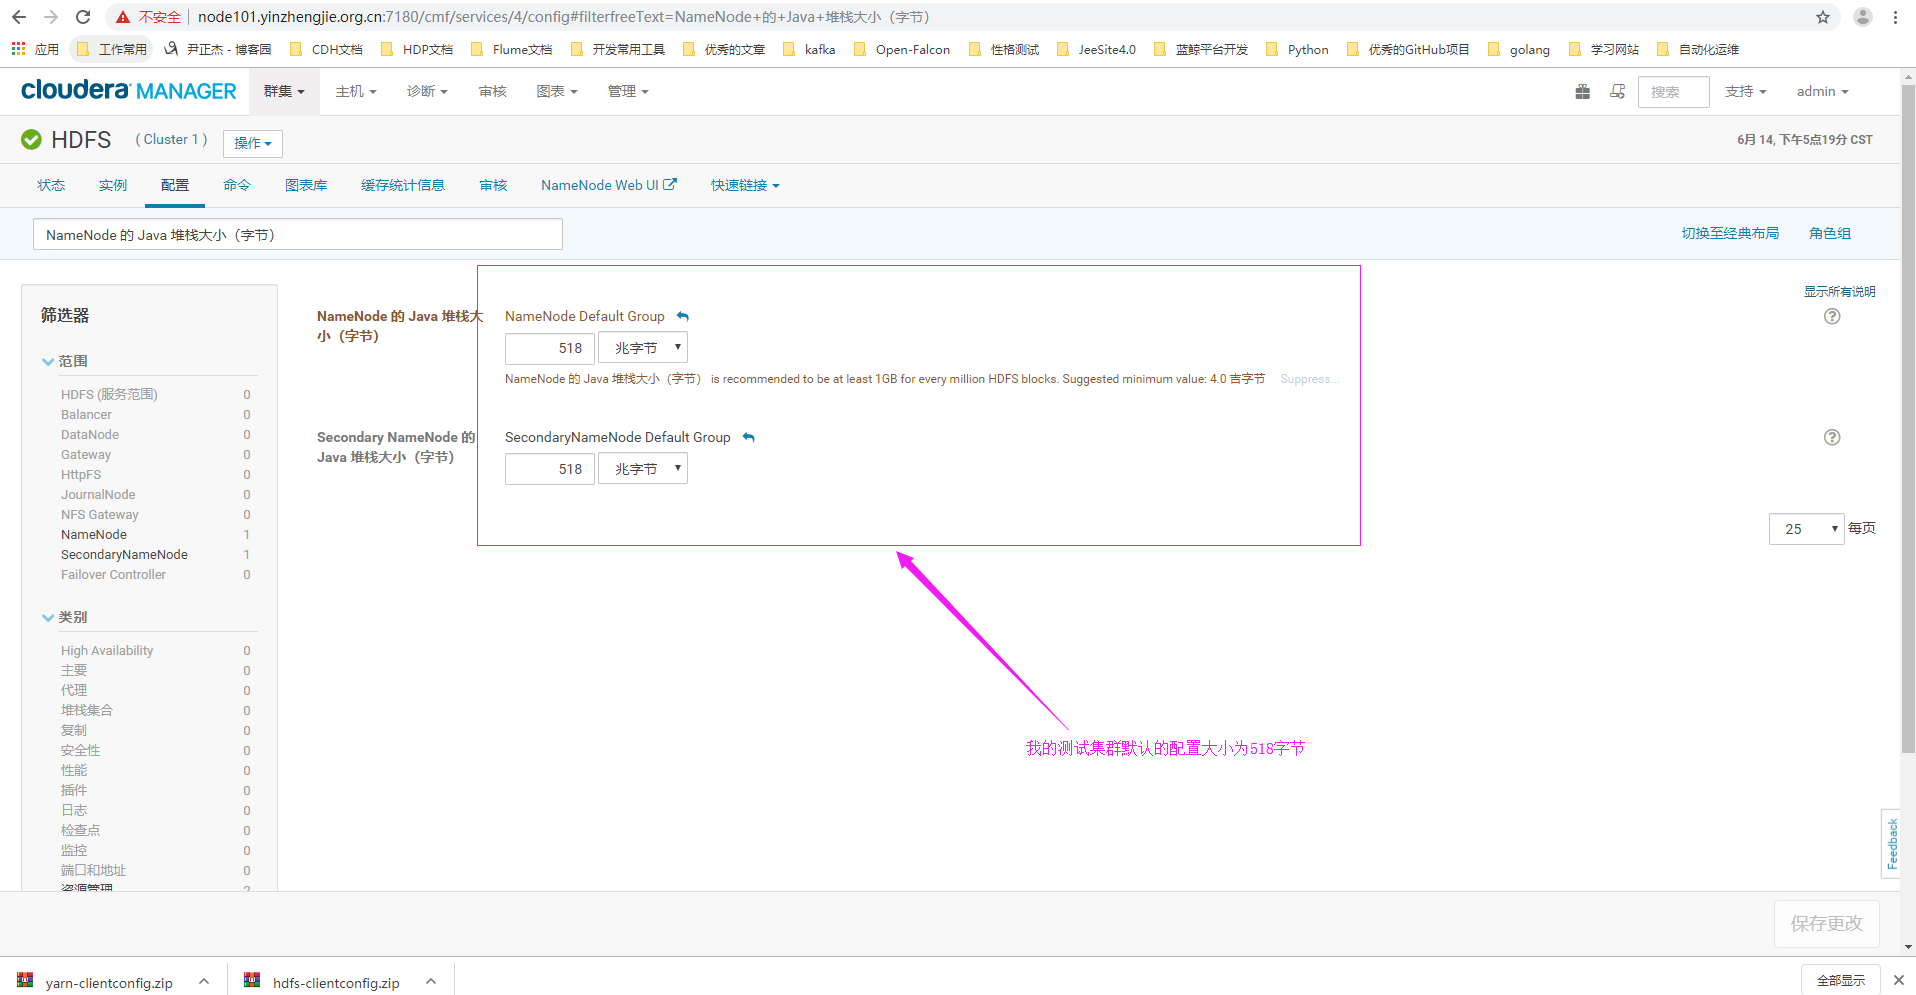
3>.设置NameNode和SencondName的堆内存为9.5GB
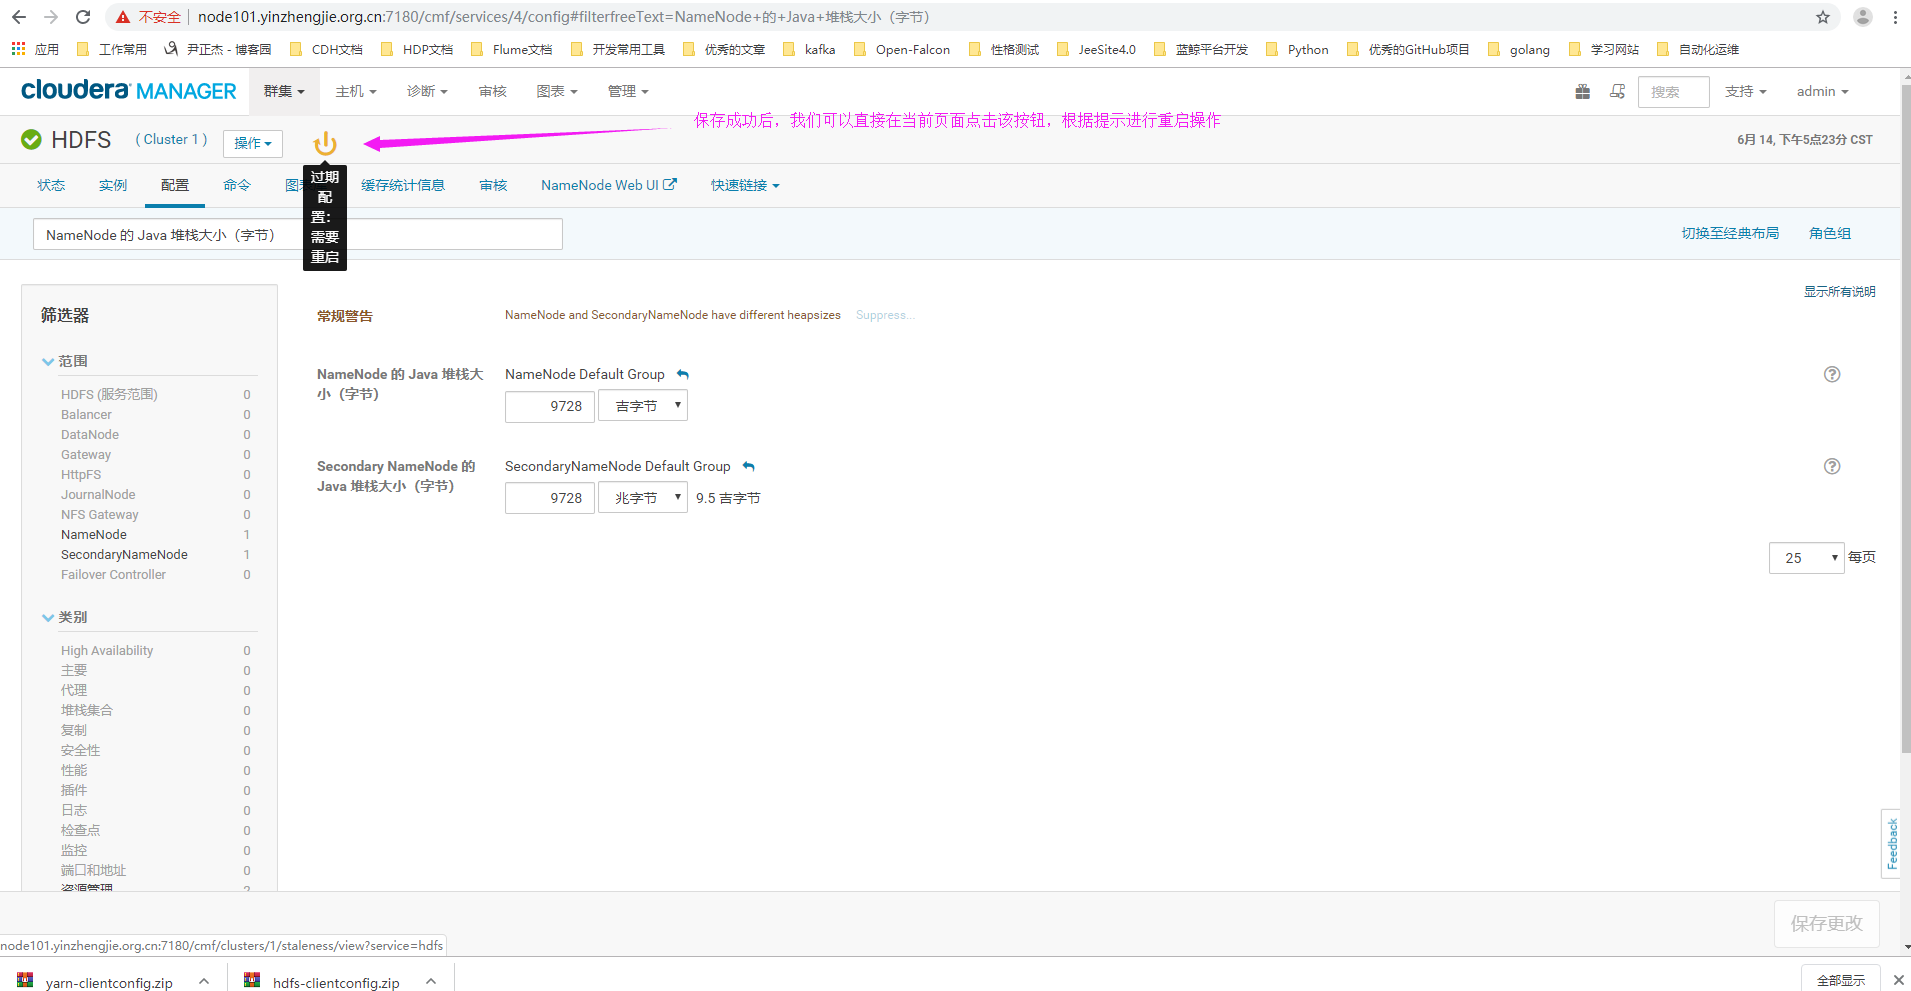
4>.重启HDFS集群(需要注意的是,如果我们设置的NameNode或者SecondNamenode的堆内存大小总和大于当前服务器内存时,我们在重启集群时会启动失败!)
四.开启回收站功能
问题描述:

  在描述公司的运维策略时,有人提出如果误删了HDFS的文件系统,可能几天都不会出现,尤其时当周末前发生这样的情况时。为了提供足够的保护级别,你决定将HDFS数据删除后永久清除的时间改为7天。

解决方案:
  我们直接在Cloudera Manager WebUI界面进行配置即可。除了配置回收站,还可以配置权限,副本书,块大小,balancer等。
1>.点击HDFS服务

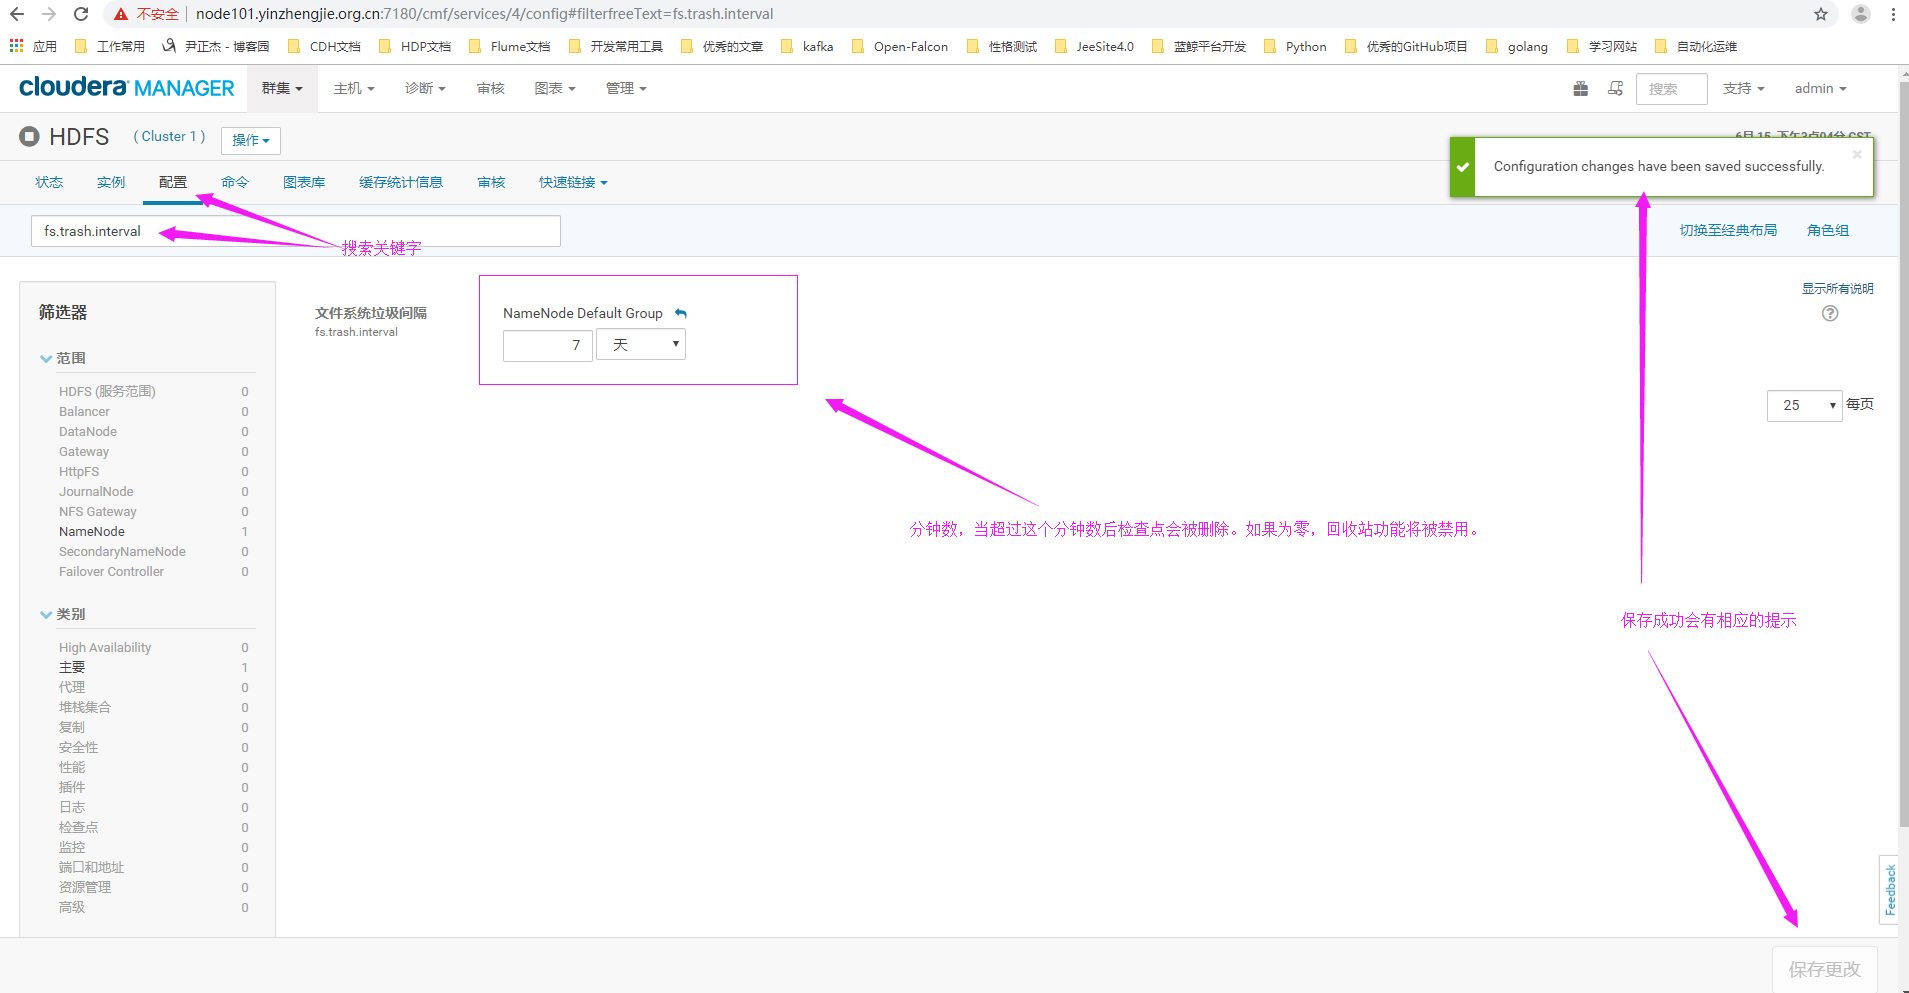
2>.点击配置,并搜索关键字"fs.trash.interval",修改其只为7天,即删除的文件在回收站中被保留的时间周期
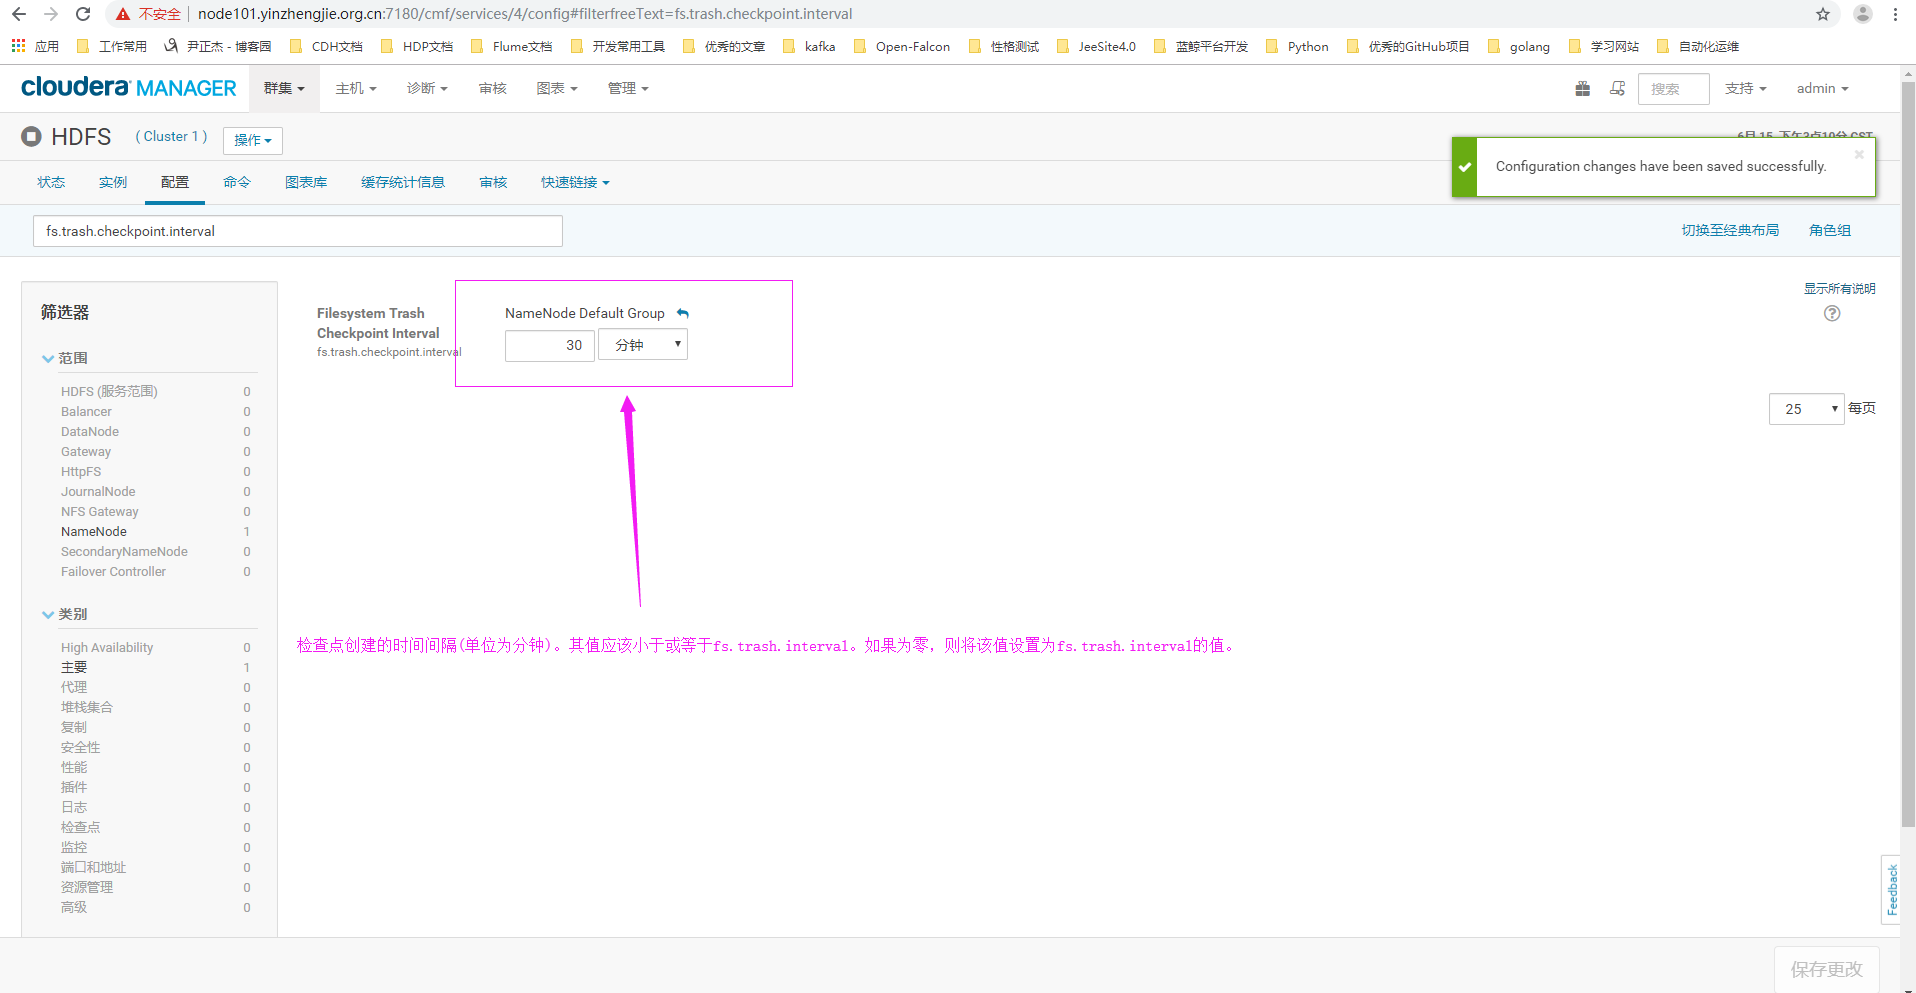
3>.搜索关键词"fs.trash.checkpoint.interval",即定义周期性检查回收站的文件是否过期的时间间隔,改值应该小于上面我们定义"fs.trash.interval"的值
五.
Cloudera Certified Associate Administrator案例之Configure篇的更多相关文章
- Cloudera Certified Associate Administrator案例之Troubleshoot篇
Cloudera Certified Associate Administrator案例之Troubleshoot篇 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.调整日志的进 ...
- Cloudera Certified Associate Administrator案例之Test篇
Cloudera Certified Associate Administrator案例之Test篇 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.准备工作(将CM升级到&qu ...
- Cloudera Certified Associate Administrator案例之Manage篇
Cloudera Certified Associate Administrator案例之Manage篇 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.下载Namenode镜像 ...
- Cloudera Certified Associate Administrator案例之Install篇
Cloudera Certified Associate Administrator案例之Install篇 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.创建主机模板(为了给主 ...
- Flume实战案例运维篇
Flume实战案例运维篇 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.Flume概述 1>.什么是Flume Flume是一个分布式.可靠.高可用的海量日志聚合系统,支 ...
- CNCF基金会的Certified Kubernetes Administrator认证考试计划
关于CKA考试 CKA(Certified Kubernetes Administrator)是CNCF基金会(Cloud Native Computing Foundation)官方推出的Kuber ...
- 分享数百个 HT 工业互联网 2D 3D 可视化应用案例之 2019 篇
继<分享数百个 HT 工业互联网 2D 3D 可视化应用案例>2018 篇,图扑软件定义 2018 为国内工业互联网可视化的元年后,2019 年里我们与各行业客户进行了更深度合作,拓展了H ...
- 数百个 HT 工业互联网 2D 3D 可视化应用案例分享 - 2019 篇
继<分享数百个 HT 工业互联网 2D 3D 可视化应用案例>2018 篇,图扑软件定义 2018 为国内工业互联网可视化的元年后,2019 年里我们与各行业客户进行了更深度合作,拓展了H ...
- robotframework+selenium搭配chrome浏览器,web测试案例(搭建篇)
这两天发布版本 做的事情有点多,都没有时间努力学习了,先给自己个差评,今天折腾了一天, 把robotframework 和 selenium 还有appnium 都研究了一下 ,大概有个谱,先说说we ...
随机推荐
- sqlserver2012 用户指定数据库访问权限
这样 用户进入的时候 就只能访问指定数据库 点击其他 显示
- EasyDSS高性能RTMP、HLS(m3u8)、HTTP-FLV、RTSP流媒体服务器软件实现的多码率视频点播功能说明
关于EasyDSS EasyDSS(http://www.easydss.com)流媒体解决方案采用业界优秀的流媒体框架模式设计,服务运行轻量.高效.稳定.可靠.易维护,支持RTMP直播.RTMP推送 ...
- DCEP:中国自己的数字货币
DCEP:中国自己的数字货币 https://cloud.tencent.com/developer/news/435883 文章来源:企鹅号 - 星星观察 广告关闭 11.11 智慧上云 云服务器企 ...
- mysql字段值如何区分大小写
今天做sql查询,发现字段值没区分大小写 mysql> select guid,type,parent_guid from api_assets where guid='3rfI2PsSrCz9 ...
- Kafka Connect简介
Kafka Connect简介 http://colobu.com/2016/02/24/kafka-connect/#more Kafka 0.9+增加了一个新的特性Kafka Connect,可以 ...
- Linux字符设备驱动实例—globalmem驱动
1.globalmem虚拟设备实例 globalmem为“全局内存”的意思,在globalmem字符设备中会分配一片大小为GLOBALMEM_SIZE(4KB)的内存空间,并在驱动中提供对这片内存的读 ...
- Spring Initializr生成的demo测试404错误
体验Spring Initializr生成的spring boot工程,启动成功, 目录结构如下: 添加了一个简单的controller后,启动成功但访问报404错误: 原因: springboot默 ...
- SQL IN 子查询返回多对值
我们常用的IN 操作是这样的: select * from tab twhere t.col1 in ('value1''value2');12但是如果是多个列的取值来自同一个子查询呢? 我们是不是要 ...
- STL源码剖析——序列式容器#4 Stack & Queue
Stack stack是一种先进后出(First In Last Out,FILO)的数据结构,它只有一个出口,元素的新增.删除.最顶端访问都在该出口进行,没有其他位置和方法可以存取stack的元素. ...
- Tkint中Label&Button&Scale的使用
top.geometry()设定窗口的初始大小 scale.set()设定滑块的初始值 scale.get()获取滑块变化的值 控件通过回调函数与其他控件进行通信(Label控件中的文本会受到Scal ...