
k 分算法是 k 越大越好吗?
引入
我们有二分算法,就是:
定义
二分查找(英语:binary search),也称折半搜索(英语:half-interval search)、对数搜索(英语:logarithmic search),是用来在一个有序数组中查找某一元素的算法。
过程
以在一个升序数组中查找一个数为例。
它每次考察数组当前部分的中间元素,如果中间元素刚好是要找的,就结束搜索过程;如果中间元素小于所查找的值,那么左侧的只会更小,不会有所查找的元素,只需到右侧查找;如果中间元素大于所查找的值同理,只需到左侧查找。
能不能有三分算法呢?正当我以为这是一个天才的想法时,我发现:
如果需要求出单峰函数的极值点,通常使用二分法衍生出的三分法求单峰函数的极值点。
三分法与二分法的基本思想类似,但每次操作需在当前区间 \([l,r]\)内任取两点 \(lmid,rmid(lmid < rmid)\)。如果 \(f(lmid)<f(rmid)\),则在 \([rmid,r]\)中函数必然单调递增,最小值所在点(下图中的绿点)必然不在这一区间内,可舍去这一区间。反之亦然。
以上皆来自OI-WIKI
注意,这里我指的三分并不是求单峰函数中的三分,它只能求单调函数,每次去掉三分之二的部分。
那么,既然有三分了,有没有四分、五分、六分甚至 \(k\) 分呢?\(k\) 分算法存在有意义吗(\(k>3\))?\(k\) 分算法是 \(k\) 越大越好吗?
于是,我的思索开始了。
本文仅代表个人观点,计算过程如有不严谨,希望您原谅并指出,时间复杂度忽略了部分时间,不代表最终结果。
最后 sto各位大佬
思索
\(k\) 分算法的复杂度为 \(k\log_kN\),那么我们就需要知道 \(k\) 取什么才能让它最小。
证明
下面我们证明
\]
在 \(k>1,N>1\) 情况下的极小值时 \(k\) 的取值。
当我们要证明一个函数的极小值时的取值时,我们可以通过求导的方式。那么我们不得不引出导数这个概念。
我懒得写,大家请看:这里
那么一句话总结,导数就是函数在某点的切线的斜率,例如下面这张图:
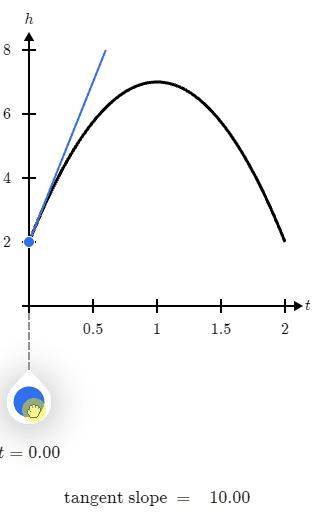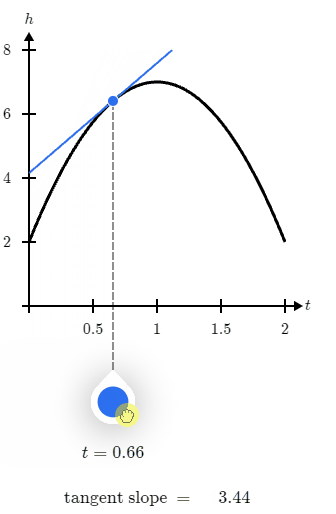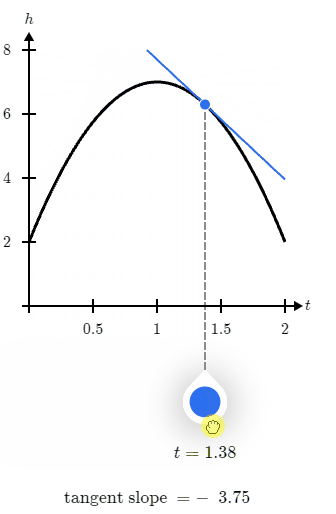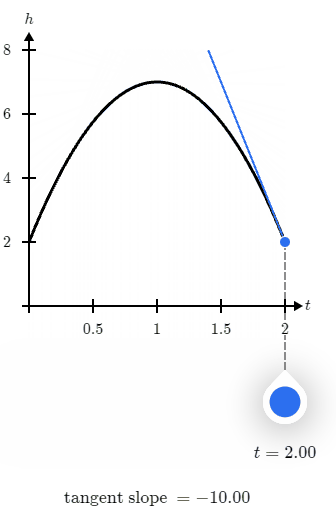
那么在导数函数结果等于0时,当前结果是极大值还是极小值呢?
极大值
噢,错啦
极小值
噢,错啦
其他(干脆你说你想看答案)
答对啦,正确答案是有可能是极大值也有可能是极小值(没想到吧)
往下翻
当导数函数结果等于0时,当前有可能是最大值也有可能是极小值,我们称这个点为临界点。我们可以检查临界点的邻域,即临界点的左右两侧。如果在临界点的左侧函数值递增,右侧函数值递减,则该点为最大值。如果在临界点的左侧函数值递减,右侧函数值递增,则该点为极小值。
接下来,我们的问题就变成了求:
\]
时 \(k\) 的取值。
$f'$ 是什么
就是 $f$ 函数的导数
根据换底公式, \(\log_kN = \frac{\ln N}{\ln k}\),我们可以将 \(f(k)\) 重写为 \(f(k) = \frac{k}{\ln k} \ln N\)。
换底公式证明
要证明 $\log_kN=\frac{\log_bN}{\log_bk}$ (换底公式)
$$
\text{设} y=\log_kN
$$
\]
\]
\]
\]
首先,可以使用乘法法则对函数 \(f(k)\) 进行求导。
根据乘法法则,若有两个函数 \(u(k)\) 和 \(v(k)\),那么:
\]
代入它,得到:
\]
其中,我们知道, \(N\) 是一个常数,那么 \(\ln N\) 也是一个常数。根据导数的定义,常数的导数为0。
你要我证明?
你看,常数的斜率不就是0吗
我们现在化简后知道:
\]
那么,\((\frac{k}{\ln k})'\) 又是多少呢?
这时,我们的任务变成了求 \((\frac{k}{\ln k})'\),可以使用除法法则进行求导。
根据除法法则,若有两个函数 \(u(k)\) 和 \(v(k)\),那么:
\]
代入它,得到:
\]
因为 \(k\) 是一个自变量,所以它的导数为1(可以画图看,它的斜率是不是1),同时根据导数表,我们知道 \(\ln(k)'=\frac{1}{k}\),代入得:
\]
再代回上面那个:
\]
求导完成,撒花!!!\(@0@)/
然后就简单了,因为
\]
所以:
\]
所以:
\]
因为 \(N > 1\),所以 \(\ln (k)-1=0\),\(\ln k=1\)
那么 \(k\) 是几?当然是 \(k=e\) 啦!!!
大家感兴趣的还可以尝试二阶导数,然后判断二阶导数是否大于0,当二阶导数大于零时,该点为极小值点;当该点的二阶导数小于零时,该点为极大值点。(费马引理)
下面补上二阶导数的计算过程:
因为 \((c\cdot u(k))'=c\cdot u'(k)\) (大家可以用乘法法则自己证一下,这里 \(c\) 为常数)
\]
\]
\]
根据除法法则:
\]
根据加减法则(\((u(k)-v(k))'=u'(k)-v'(k)\)):
\]
\]
\]
根据链式法则(设 \(y=f(u),u=g(k)\),则 \(y'(k)=f'(u)\cdot g'(k)\)),且因为 \((x^\alpha)'=\alpha x^{\alpha-1}\)
\]
\]
\]
\]
\]
我们发现,当 \(k=e\) 该二阶导数大于0,故该点为极小值点。
那么好了,当我们进行 \(e\) 分时时间复杂度最少,但是我们总不能进行 2.718 分吧?所以我们取一个整数值,2或者3。
代入后可以得到,3的斜率更小,故选择3。
upd:假的,二分更优,因为三分查询数组次数过多当数据大(10000组10000000的数据)时会慢几毫秒
k 分算法是 k 越大越好吗?的更多相关文章
- 从K近邻算法谈到KD树、SIFT+BBF算法
转自 http://blog.csdn.net/v_july_v/article/details/8203674 ,感谢july的辛勤劳动 前言 前两日,在微博上说:“到今天为止,我至少亏欠了3篇文章 ...
- k近邻算法
k 近邻算法是一种基本分类与回归方法.我现在只是想讨论分类问题中的k近邻法.k近邻算法的输入为实例的特征向量,对应于特征空间的点,输出的为实例的类别.k邻近法假设给定一个训练数据集,其中实例类别已定. ...
- [机器学习系列] k-近邻算法(K–nearest neighbors)
C++ with Machine Learning -K–nearest neighbors 我本想写C++与人工智能,但是转念一想,人工智能范围太大了,我根本介绍不完也没能力介绍完,所以还是取了他的 ...
- <转>从K近邻算法、距离度量谈到KD树、SIFT+BBF算法
转自 http://blog.csdn.net/likika2012/article/details/39619687 前两日,在微博上说:“到今天为止,我至少亏欠了3篇文章待写:1.KD树:2.神经 ...
- 从K近邻算法、距离度量谈到KD树、SIFT+BBF算法
转载自:http://blog.csdn.net/v_july_v/article/details/8203674/ 从K近邻算法.距离度量谈到KD树.SIFT+BBF算法 前言 前两日,在微博上说: ...
- 02-16 k近邻算法
目录 k近邻算法 一.k近邻算法学习目标 二.k近邻算法引入 三.k近邻算法详解 3.1 k近邻算法三要素 3.1.1 k值的选择 3.1.2 最近邻算法 3.1.3 距离度量的方式 3.1.4 分类 ...
- 1.K近邻算法
(一)K近邻算法基础 K近邻(KNN)算法优点 思想极度简单 应用数学知识少(近乎为0) 效果好 可以解释机器学习算法使用过程中的很多细节问题 更完整的刻画机器学习应用的流程 图解K近邻算法 上图是以 ...
- k邻近算法(KNN)实例
一 k近邻算法原理 k近邻算法是一种基本分类和回归方法. 原理:K近邻算法,即是给定一个训练数据集,对新的输入实例,在训练数据集中找到与该实例最邻近的K个实例,这K个实例的多数属于某个类,就把该输入实 ...
- 机器学习——KNN算法(k近邻算法)
一 KNN算法 1. KNN算法简介 KNN(K-Nearest Neighbor)工作原理:存在一个样本数据集合,也称为训练样本集,并且样本集中每个数据都存在标签,即我们知道样本集中每一数据与所属分 ...
- K临近算法
K临近算法原理 K临近算法(K-Nearest Neighbor, KNN)是最简单的监督学习分类算法之一.(有之一吗?) 对于一个应用样本点,K临近算法寻找距它最近的k个训练样本点即K个Neares ...
随机推荐
- Centos 7安装Docker镜像仓库-Harbor
下载安装包并导入镜像 # 进入文件下载目录 cd /root/software/ # 下载安装文件 # 如果下载失败可以本地下载,下载后上传至服务器,https://github.com/goharb ...
- 使用Stable Diffusion制作AI数字人视频的简明教程
基本方法 搞一张照片,搞一段语音,合成照片和语音,同时让照片中的人物动起来,特别是头.眼睛和嘴. 语音合成 语音合成的方法很多,也比较成熟了,大家可以选择自己方便的,直接录音也可以,只要能生成一个语音 ...
- OlllyDbg调试器和IDA调试器
OllyDbg调试器 OllyDbg称为Ring3级的首选工具.可以识别数千个被和Windows频繁使用的函数,并能将其注释出来.它会自动分析函数过程.循环语句等 OllyDbg主界面 快捷键 Add ...
- MySQL——GROUP BY详解与优化
在 MySQL 中,GROUP BY用于将具有指定列中相同值的行分组在一起.这是在处理大量数据时非常有用的功能,允许对数据进行分类和聚合. 基本使用 语法 以下是GROUP BY子句的基本语法: &q ...
- 关于开设go语言专题的说明
这个博客账号已经停更了约5年,期间我经历了比较多的事情,开始几个github开源项目,例如go-etl已经有两年.现在已经我在这方面有了许多积累,足够开设相关的专题.不用担心博主会断更,因为相关的内容 ...
- KVM 硬盘分区扩容(GPT与MBR两种分区、fdisk 与 growpart两种方法)
因为认知顺序的原因,之前我都是用fdisk命令手工删除分区表后重建进行扩容,后面才发现可以用growpart命令. 实战建议直接点 AWS EC2 存储空间扩容 跳转过去参考,学习操作可以继续往下看. ...
- git:gitignore常用配置
配置 在项目文件中添加.gitignore文件 .DS_Store node_modules /dist
- 用 Tensorflow.js 做了一个动漫分类的功能(二)
前言: 前面已经通过采集拿到了图片,并且也手动对图片做了标注.接下来就要通过 Tensorflow.js 基于 mobileNet 训练模型,最后就可以实现在采集中对图片进行自动分类了. 这种功能在应 ...
- Unity的IFilterBuildAssemblies:深入解析与实用案例
Unity IFilterBuildAssemblies Unity IFilterBuildAssemblies是Unity引擎中的一个非常有用的功能,它可以让开发者在构建项目时自定义哪些程序集需要 ...
- 《高级程序员 面试攻略 》RocketMQ 如何保证顺序性
RocketMQ 提供了一种称为顺序消息的机制来确保消息的顺序性.下面是一些关键的方法和概念: 1. 顺序消息:顺序消息是指在发送和消费过程中,消息按照特定的顺序进行处理.RocketMQ 通过将消息 ...