
scrapy 项目通过scrapyd部署
年前的时候采用scrapy 爬取了某网站的数据,当时只是通过crawl 来运行了爬虫,现在还想通过持续的爬取数据所以需要把爬虫部署起来,查了下文档可以采用scrapyd来部署scrapy项目,scrapyd主要分两部分,一部分是服务器端(scrapyd),一个是客户端(scrapyd-client),服务器端主要聊调度和运行scrapy,客服端主要用于发布scrapy项目。
一.scrapyd 环境搭建
1.安装scrapyd可以采用pip和源码的两种方式安装
i.安装scrapyd
pip install scrapyd
ii.安装scrapyd-client
pip install scrapyd-client
2.运行scrapyd;
i.首先我们需要创建一个目录,用于存储发布我们部署的项目;
ii.执行scrapyd,运行启动,启动成功访问http://127.0.0.1:6800/,显示scrapyd界面,这样scrapyd安装成功;
iii.此时scrapyd只能在本机访问,我们需要去修改配置文件,运行所有的ip都可以访问。配置文件的路径在site-packages\scrapyd目录下,windows配置文件名字是default_scrapyd.conf,把bind_address改成0.0.0.0 这样就可以所有的地址都可以访问。
3.配置scrapyd-client。
i.安装完成scrapyd-client,我们要使用scrapyd-deploy来发布我们项目,但是在window运行scrapyd-deploy会出问题,这时候我们需要在python安装目录Scripts新建一个bat脚本
@echo off

"D:\Program Files\Python\Python35\python.exe" "D:\Program Files\Python\Python35\Scripts\scrapyd-deploy" %*
说明:前面是python.exe 目录,中间是 scrapyd-deploy 目录,%*代表输入的参数。
以上我们就把scrapyd的服务器端和客户端配置完成了,我们来发布下自己的项目。
二.scrapy 项目发布
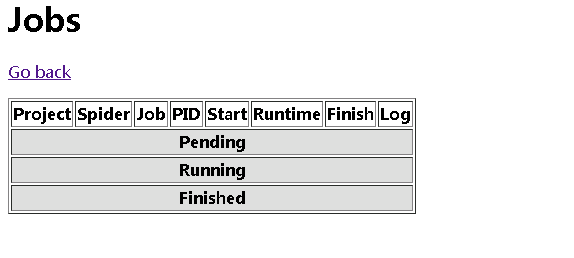
1.scrapyd安装成功,打开http://localhost:6800/ 可以看到scrapyd的一个页面,包括三个选项,jobs(任务),logs(日志),Documentation;

2.点击job可以看到目前运行的任务。
3.发布项目到scrapyd
i.配置scrapy工程scrapy.cfg文件
[settings]

default = boss.settings

[deploy:boss]  #如果多个项目,这里可以添加一个别名

url = http://localhost:6800/   #这里设置scrapyd的服务器地址;

project = boss
ii.通过scrapyd-deploy发布项目,需要进入scrapy的工程目录进行发布
scrapyd-deploy boss -p boss
语法:scrapyd-deploy <部署别名> -p 项目名称
发布成功以后,会返回以下结果。

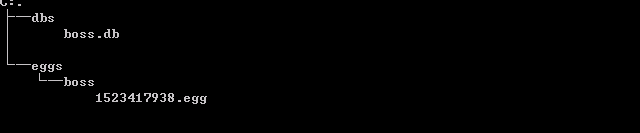
此时会在scrapyd目录下创建一个boss目录,把我们的scrapy项目打成一个egg的压缩文件。
三.启动、停止爬虫
这个时候我们需要调用scrapyd API来运行我们的爬虫。
1.启动爬虫
curl http://localhost:6800/schedule.json -d project=boss -d spider=zhaopin
语法:
curl http://<ip>:6800/schedule.json -d project=<项目名称> -d spider=<spider名称>
以下就是项目发布成功。

也可以在scrapyd管理界面看到项目的运行情况

2.停止爬虫
curl http://localhost:6800/cancel.json -d project=boss -d job=6700d2d43d3c11e8b1eaf8db8a950d02
语法:
curl http://<ip>:6800/cancel.json -d project=<项目名称> -d job=job_id(项目运行成功会返回ID)
3.常用的scrapyd API
.获取状态

    http://127.0.0.1:6800/daemonstatus.json

.获取项目列表

  http://127.0.0.1:6800/listprojects.json

.获取项目下已发布的爬虫列表

  http://127.0.0.1:6800/listspiders.json?project=<项目名称>

.获取项目下已发布的爬虫版本列表

  http://127.0.0.1:6800/listversions.json?project=<项目名称>

.获取爬虫运行状态

  http://127.0.0.1:6800/listjobs.json?project=<项目名称>

.启动服务器爬虫

  http://localhost:6800/schedule.json (post方式,data={"project":<项目名称>,"spider":<spider名称>})

.删除某一版本爬虫

  http://127.0.0.1:6800/delversion.json (post方式,data={"project":<项目名称>,"version":<版本号>})

.删除某一工程,包括该工程下的各版本爬虫

  http://127.0.0.1:6800/delproject.json(post方式,data={"project":<项目名称>})
注意:
  删除之前需要停止爬虫,才可以再次删除
scrapy 项目通过scrapyd部署的更多相关文章
- 第三百七十二节,Python分布式爬虫打造搜索引擎Scrapy精讲—scrapyd部署scrapy项目
第三百七十二节,Python分布式爬虫打造搜索引擎Scrapy精讲—scrapyd部署scrapy项目 scrapyd模块是专门用于部署scrapy项目的,可以部署和管理scrapy项目 下载地址:h ...
- 五十一 Python分布式爬虫打造搜索引擎Scrapy精讲—scrapyd部署scrapy项目
scrapyd模块是专门用于部署scrapy项目的,可以部署和管理scrapy项目 下载地址:https://github.com/scrapy/scrapyd 建议安装 pip3 install s ...
- scrapy项目部署
什么是scrapyd Scrapyd是部署和运行Scrapy.spider的应用程序.它使您能够使用JSON API部署(上传)您的项目并控制其spider. 特点: 可以避免爬虫源码被看到. 有版本 ...
- Scrapyd部署爬虫
Scrapyd部署爬虫 准备工作 安装scrapyd: pip install scrapyd 安装scrapyd-client : pip install scrapyd-client 安装curl ...
- Python 爬虫之 Scrapy 分布式原理以及部署
Scrapy分布式原理 关于Scrapy工作流程 Scrapy单机架构 上图的架构其实就是一种单机架构,只在本机维护一个爬取队列,Scheduler进行调度,而要实现多态服务器共同爬取数据关键就是共享 ...
- 爬虫部署 --- scrapyd部署爬虫 + Gerapy 管理界面 scrapyd+gerapy部署流程
---------scrapyd部署爬虫---------------1.编写爬虫2.部署环境pip install scrapyd pip install scrapyd-client 启动scra ...
- scrapyd部署、使用Gerapy 分布式爬虫管理框架
Scrapyd部署爬虫项目 GitHub:https://github.com/scrapy/scrapyd API 文档:http://scrapyd.readthedocs.io/en/stabl ...
- 创建第一个Scrapy项目
d:进入D盘 scrapy startproject tutorial建立一个新的Scrapy项目 工程的目录结构: tutorial/ scrapy.cfg # 部署配置文件 tutorial/ # ...
- Tomcat 利用server.xml进行其他盘符的其他项目映射的部署以及JSP引用其他盘符的图片(虚拟目录及虚拟路径)
Tomcat 利用server.xml进行项目映射的部署 2013-07-17 15:14 12843人阅读 评论(4) 收藏 举报 分类: web 开发(5) 版权声明:本文为博主原创文章,欢迎 ...
随机推荐
- day12作业
- python day03作业
- 对于java自定义的工具类的提炼 注意事项
1.工具类的方法都用static修饰. 因为工具类一般不创建对象,直接类名.方法()使用 2.一些 定义的常亮需要 public static final 修饰. 3.一些与数据库的连接之类的设定 , ...
- Spring NoSQL
把数据收集到一个非规范化的结构中,按照这种方式优化处理文档的数据库称之为文档数据库.文档数据库不适用于数据具有明显关联关系,因为文档数据库并没有针对存储这样的数据进行优化. Spring Data M ...
- 5个适用于初学者的有用数据分析表达式(DAX)函数
数据分析表达式(DAX)入门可能令人生畏,但是,当你了解一些基本功能后,你就可以帮助你解答许多有关数据的新见解.虽然在Power BI或Pivot Charts中创建视觉效果很容易,但我们经常希望查看 ...
- 使用matlab和ISE 创建并仿真ROM IP核
前言 本人想使用简单的中值滤波进行verilog相关算法的硬件实现,由于HDL设计软件不能直接处理图像,大部分过程都是可以将图像按照一定的顺序保存到TXT文档中,经过Modelsim仿真后,处理的数据 ...
- 双向重定向tee命令详解
vim一般在训练网络的时候需要保存log文件,同时需要在屏幕上网络的输出信息,在shell文件中常常会看到如下代码 执行的命令 2>&1 | tee log.txt tee是linux中 ...
- doc转html
Doc2Html li标签没闭合 在线Word转HTML style样式
- ortp 发送RTP实例
参考源代码目录src/tests/rtpsend.c ortp_init(); ortp_scheduler_init(); ortp_set_log_level_mask(O ...
- react写单选按钮或table标签
首先,原理是一样的: class Loca_choose_wrap extends Component{ constructor(){ super(); this.state={ port_name: ...