
吴裕雄--天生自然python学习笔记:网页解析
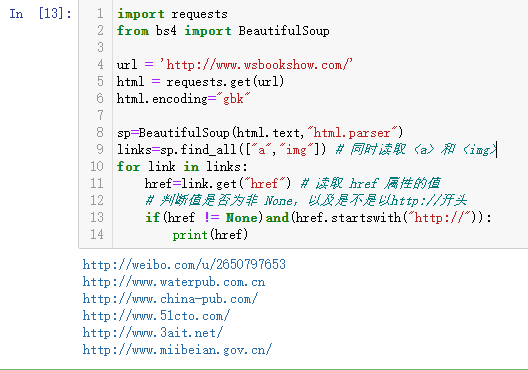
抓取万水书苑网页中所有<a>标签中的超链接井显示。
import requests

from bs4 import BeautifulSoup

url = 'http://www.wsbookshow.com/'

html = requests.get(url)

html.encoding="gbk"

sp=BeautifulSoup(html.text,"html.parser")

links=sp.find_all(["a","img"]) # 同时读取 <a> 和 <img>

for link in links:

    href=link.get("href") # 读取 href 属性的值

    # 判断值是否为非 None,以及是不是以http://开头

    if(href != None)and(href.startswith("http://")):

        print(href)
吴裕雄--天生自然python学习笔记:网页解析的更多相关文章
- 吴裕雄--天生自然python学习笔记:python爬虫与网页分析
我们所抓取的网页源代码一般都是 HTML 格式的文件,只要研究明白 HTML 中 的标签( Tag )结构,就很容易进行解析并取得所需数据 . HTML 网页结构 HTML 网 页是由许多标签( Ta ...
- 吴裕雄--天生自然python学习笔记:WEB数据抓取与分析
Web 数据抓取技术具有非常巨大的应用需求及价值, 用 Python 在网页上收集数据,不仅抓取数据的操作简单, 而且其数据分析功能也十分强大. 通过 Python 的时lib 组件中的 urlpar ...
- 吴裕雄--天生自然python学习笔记:Python3 网络编程
Python 提供了两个级别访问的网络服务.: 低级别的网络服务支持基本的 Socket,它提供了标准的 BSD Sockets API,可以访问底层操作系统Socket接口的全部方法. 高级别的网络 ...
- 吴裕雄--天生自然python学习笔记:python用 Bokeh 模块绘制我国 GDP 数据统计图
现在我们把我国 1990 年到 2017 年的 GDP 数据抓取出 来,井用 Bokeh 绘 出散点统计图 . 由网页爬取所需数据,并用 Bokeh 绘制散点图 . import requests # ...
- 吴裕雄--天生自然python学习笔记:爬取我国 1990 年到 2017年 GDP 数据并绘图显示
绘制图形所需的数据源通常是不固定的,比如,有时我们会需要从网页抓取, 也可能需从文件或数据库中获取. 利用抓取网页数据技术,把我国 1990 年到 2016 年的 GDP 数据抓取出来 ,再利用 Ma ...
- 吴裕雄--天生自然python学习笔记:Python3 XML 解析
什么是 XML? XML 指可扩展标记语言(eXtensible Markup Language),标准通用标记语言的子集,是一种用于标记电子文件使其具有结构性的标记语言. XML 被设计用来传输和存 ...
- 吴裕雄--天生自然python学习笔记:Beautiful Soup 4.2.0模块
Beautiful Soup 是一个可以从HTML或XML文件中提取数据的Python库.它能够通过你喜欢的转换器实现惯用的文档导航,查找,修改文档的方式.Beautiful Soup会帮你节省数小时 ...
- 吴裕雄--天生自然python学习笔记:python实现自动网页测试
Python 可实现的网页测试的功能十分强大,甚至能通 过编程来实现让绝大多数的测试过程自动化. 这对很多开 发者来说,绝对是不可多得的神器. hash lib 纽件可以判别文件是否有过更改,只需要用 ...
- 吴裕雄--天生自然python学习笔记:pandas模块强大的数据处理套件
用 Python 进行数据分析处理,其中最炫酷的就属 Pa ndas 套件了 . 比如,如果我 们通过 Requests 及 Beautifulsoup 来抓取网页中的表格数据 , 需要进行较复 杂的 ...
随机推荐
- Maven - No plugin found for prefix 'tomcat7' in the current project
问题发现: 在构建Maven项目的时候,出现了No plugin found for prefix 'tomcat7' in the current project的错误. 是需要在Maven的Pom ...
- 腾讯一shell试题.
腾讯一shell试题. 假设qq.tel文件内容: 12334:13510014336 12345:12334555666 12334:12343453453 12099:13598989899 12 ...
- idtcp实现文件下载和上传
unit Unit1; interface uses Windows, Messages, SysUtils, Variants, Classes, Graphics, Controls, Forms ...
- 编程作业3.1:Multi-class classification(One-vs-all)
题目: 在本次练习中,你将使用逻辑回归和神经网络来识别手写数字(从0到9). 今天,自动手写数字识别被广泛使用,从识别信封上的邮政编码到识别银行支票上的金额.这个练习将向你展示如何将你所学的方法用于此 ...
- JavaScript mixins
mixin 是一个类,该类的方法被添加,混合进另外一个类.一个基础类会包含mixin类的方法而不是继承它.这样你就可以使用不同的mixin类来增加或者增强基础类的功能. 这编内容包含怎么样使用java ...
- centos 7.2 php7+ 安装elasticsearch
安装 Elasticsearch-php 的安装需要满足以下 4 个需求: PHP 7.0.0 或更高版本 Composer ext-curl:PHP 的 Libcurl 扩展(详情查看下方注意事项) ...
- 基于Flask框架搭建视频网站的学习日志(六)之数据库
使用Flask-SQLSlchemy管理数据库(1)--初步安装调试 一.介绍: Flask-SQLSlchemy是一个Flask扩展,简化了Flask中对sql的操作,是一个高层的框架,可以避免直接 ...
- httpsqs 源码修改(内部自动复制多队列)
/* HTTP Simple Queue Service - httpsqs v1.7 Author: Zhang Yan (http://blog.s135.com), E-mail: net@s1 ...
- 脚本kafka-configs.sh用法解析
引用博客来自李志涛:https://www.cnblogs.com/lizherui/p/12275193.html 前言介绍 网络上针对脚本kafka-configs.sh用法,也有一些各种文章,但 ...
- 放贷额度相关的ROI计算
违约模型得到概率估计, 将概率值划分5档, 每一档确定一个授信系数 新的授信 = 每月收入* 授信系数 - 老的授信 计算新增授信额度 计算余额损失