
机器学习之寻找KMeans的最优K
K-Means聚类算法是最为经典的,同时也是使用最为广泛的一种基于划分的聚类算法,它属于基于距离的无监督聚类算法。KMeans算法简单实用,在机器学习算法中占有重要的地位。对于KMeans算法而言,如何确定K值,确实让人头疼的事情。
最近这几天一直忙于构建公司的推荐引擎。对用户群体的分类,要使用KMeans聚类算法,就研究了一下。
探索K的选择
对数据进行分析之前,采用一些探索性分析手段还是很有必要的。
对于高维空间,我们可以采用降维的方式,把多维向量转化为二维向量。好在,R语言包里提供了具体的实现,MDS是个比较好的方式。
多维标度分析(MDS)是一种将多维空间的研究对象简化到低维空间进行定位、分析和归类,同时又保留对象间原始关系的数据分析方法。R语言包提供了经典MDS和非度量MDS。
通过MDS对数据进行处理后,采用ggplot绘出点图,看看数据分布的情况,使得我们对要聚类的数据有个直观的认识。
SSE和Silhouette Coefficient系数
我们还可以通过SSE和Silhouette Coefficient系数的方法评估最优K。譬如对K从1到15计算不同的聚类的SSE,由于kmeans算法中的随机因数,每次结果都不一样,为了减少时间结果的偶然性,对于每个k值,都重复运行50次,求出平均的SSE,最后绘制出SSE曲线。Silhouette Coefficient也采用同样做法。
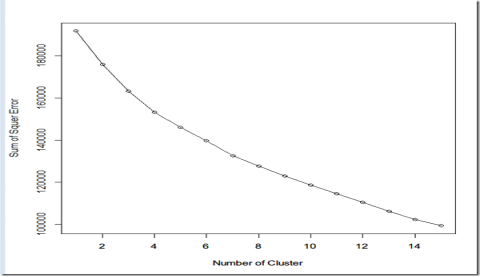
SSE结果
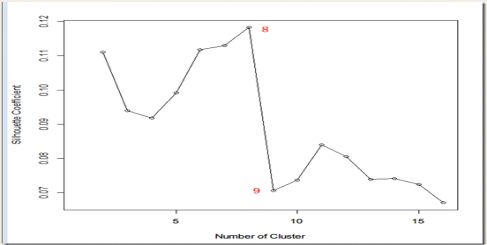
Silhouette Coefficient结果
从上图来看,8和9明显有一个尖峰。我们大体可以确定K的数目是8。值得注意在有些时候,这种方法有可能无效,但仍然不失为一个很好的方法。
DB INDEX准则
DB INdex准则全称Davies Bouldin index 。类内离散度和类间聚类常被用来判断聚类的有效性,DB INdex准则同时使用了类间聚类和类内离散度。通过计算这个指数,来确定到底哪个Cluster最合理

R语言代码如下:
 data <- read.csv("a.csv", header = T,

     stringsAsFactors = F)

 DB_index <- function(x, cl, k) {

     data <- split.data.frame(x, cl$cluster)

     # 计算类内离散度

     S <- NULL

     for (i in 1:k) {

         S[i] <- sum(rowSums((data[[i]] - cl$centers[i])^2))/nrow(data[[i]])

     }

     # 计算类间聚类

     D <- as.matrix(dist(cl$centers))

     # 计算DB index

     R <- NULL

     for (i in 1:k) {

         R <- c(max((S[i] + S[-i])/D[-i, i]), R)

     }

     DB <- sum(R)/k

     return(DB)

 }

 # 循环计算不同聚类数的DB_Index指数

 DB <- NULL

 for (i in 2:15) {

     cl <- kmeans(data, i)

     DB <- c(DB_index(data, cl, i), DB)

 }

 plot(2:15, DB)

 lines(2:15, DB)
CANOPY算法
Canopy聚类最大的特点是不需要事先指定k值(即clustering的个数),与其他聚类算法相比,Canopy聚类虽然精度较低,但其在速度上有很大优势。
因此可以使用Canopy聚类先对数据进行“粗”聚类,得到k值后再使用K-means进行进一步“细”聚类。这个算法不多说了,mahout聚类里有具体实现。
参阅:https://en.wikipedia.org/wiki/Davies-Bouldin_index
机器学习之寻找KMeans的最优K的更多相关文章
- 机器学习中的K-means算法的python实现
<机器学习实战>kMeans算法(K均值聚类算法) 机器学习中有两类的大问题,一个是分类,一个是聚类.分类是根据一些给定的已知类别标号的样本,训练某种学习机器,使它能够对未知类别的样本进行 ...
- 机器学习实战之K-Means算法
一,引言 先说个K-means算法很高大上的用处,来开始新的算法学习.我们都知道每一届的美国总统大选,那叫一个竞争激烈.可以说,谁拿到了各个州尽可能多的选票,谁选举获胜的几率就会非常大.有人会说,这跟 ...
- 【转】机器学习实战之K-Means算法
一,引言 先说个K-means算法很高大上的用处,来开始新的算法学习.我们都知道每一届的美国总统大选,那叫一个竞争激烈.可以说,谁拿到了各个州尽可能多的选票,谁选举获胜的几率就会非常大.有人会说,这跟 ...
- 寻找数组中的第K大的元素,多种解法以及分析
遇到了一个很简单而有意思的问题,可以看出不同的算法策略对这个问题求解的优化过程.问题:寻找数组中的第K大的元素. 最简单的想法是直接进行排序,算法复杂度是O(N*logN).这么做很明显比较低效率,因 ...
- kNN处理iris数据集-使用交叉验证方法确定最优 k 值
基本流程: 1.计算测试实例到所有训练集实例的距离: 2.对所有的距离进行排序,找到k个最近的邻居: 3.对k个近邻对应的结果进行合并,再排序,返回出现次数最多的那个结果. 交叉验证: 对每一个k,使 ...
- poj2114 寻找树上存在长度为k点对,树上的分治
寻找树上存在长度为k点对,树上的分治 代码和 这个 差不多 ,改一下判断的就好 #include <iostream> #include <algorithm> #inc ...
- 【最优K叉树】hdu 5884 Sort
http://acm.hdu.edu.cn/showproblem.php?pid=5884 参考:https://www.cnblogs.com/jhz033/p/5879452.html [题意] ...
- 寻找链表的倒数第k个节点
寻找链表的倒数第k个节点 题目:已知一个带有表头结点的单链表,节点结构为(data,next),假设该链表只给出了头指针list.在不改变链表的前提下,请设计一个尽可能高效的算法,查找链表中倒数第k个 ...
- 机器学习实战5:k-means聚类:二分k均值聚类+地理位置聚簇实例
k-均值聚类是非监督学习的一种,输入必须指定聚簇中心个数k.k均值是基于相似度的聚类,为没有标签的一簇实例分为一类. 一 经典的k-均值聚类 思路: 1 随机创建k个质心(k必须指定,二维的很容易确定 ...
随机推荐
- Java类初始化
Java类初始化 成员变量的初始化和构造器 如果类的成员变量在定义时没有进行显示的初始化赋值,Java会给每个成员变量一个默认值 对于 char.short.byte.int.long.float. ...
- SQL Server中smalldatetime的日期范围为何是[1900-01-01,2079-06-06]
本文目录列表: 1.SQL Server中的基准日期 2.smalldatetime的日期范围 3.smalldatetime的日期范围和无符号2字节整数的关系 4.总结语 5.参考清单列表 SQ ...
- 使用DapperExtensions实现简单仓储
Dapper是一个轻量级的ORM框架,它只是一个IDbConnection的扩展文件.所以我们需要手写很多SQL,但是写CRUD的代码总是很无趣的.所有就有了DapperExtensions.Dapp ...
- ActiveX(一)第一个简单的Demo
说道ActiveX,我的第一直觉就是Flash,利用ActiveX.我们可以创建丰富的可交互式应用程序.同时.利用ActiveX特性.我们可以实现Js 与 ActiveX 的无缝连接(包括数据共享.和 ...
- httpCookie与Cookie安全
Web 应用程序使用的 Cookie 个人认为这里设置的cookie与访问cookie的安全性关联大一点,配置节如下 <httpCookies domain="String" ...
- MVC5中后台提供Json,前台处理Json,绑定给Dropdownlist的例子
MVC5中后台提供Json,前台处理Json,绑定给Dropdownlist的例子: 前端: 我们以前在前端定义了两个控件: <div class="row"> < ...
- 最好的Angular2表格控件
现在市面上有大量的JavaScript数据表格控件,包括开源的第三方的和自产自销的.可以说Wijmo的Flexgrid是目前适应Angular 2的最好的表格控件. Angular 2数据表格基本要求 ...
- js设置、获取单值cookie和多值cookie
js设置.获取单值cookie和多值cookie,代码如下: var CookieUtil = (function () { var Cookie = function () { // 获取单值coo ...
- java protected 的细节
1. java的权限控制--大部分人都被错误洗脑了. 一个重大的坑,或者一个重大的误区,或者说一个洗脑了成千上万java编程者的错误概念就是: public private protected 是基于 ...
- 从零开始学 Java - CentOS 下安装 Nginx
早上下起了暴雨 闹钟还未响起就听到雨滴哗啦啦击打窗户的声音,被吵醒了.起床上班,在楼下的十字路口,暴雨大到完全看不清对面,两个穿着雨衣的交警站在路口中间指挥着过往的车辆,大家都慌慌张张.急急忙忙的打着 ...