
入门大数据---Spark_Streaming整合Flume
一、简介
Apache Flume 是一个分布式,高可用的数据收集系统,可以从不同的数据源收集数据,经过聚合后发送到分布式计算框架或者存储系统中。Spark Straming 提供了以下两种方式用于 Flume 的整合。
二、推送式方法
在推送式方法 (Flume-style Push-based Approach) 中,Spark Streaming 程序需要对某台服务器的某个端口进行监听,Flume 通过 avro Sink 将数据源源不断推送到该端口。这里以监听日志文件为例,具体整合方式如下:
2.1 配置日志收集Flume
新建配置 netcat-memory-avro.properties,使用 tail 命令监听文件内容变化,然后将新的文件内容通过 avro sink 发送到 hadoop001 这台服务器的 8888 端口:
#指定agent的sources,sinks,channels

a1.sources = s1

a1.sinks = k1

a1.channels = c1

#配置sources属性

a1.sources.s1.type = exec

a1.sources.s1.command = tail -F /tmp/log.txt

a1.sources.s1.shell = /bin/bash -c

a1.sources.s1.channels = c1

#配置sink

a1.sinks.k1.type = avro

a1.sinks.k1.hostname = hadoop001

a1.sinks.k1.port = 8888

a1.sinks.k1.batch-size = 1

a1.sinks.k1.channel = c1

#配置channel类型

a1.channels.c1.type = memory

a1.channels.c1.capacity = 1000

a1.channels.c1.transactionCapacity = 100
2.2 项目依赖
项目采用 Maven 工程进行构建,主要依赖为 spark-streaming 和 spark-streaming-flume。
<properties>

    <scala.version>2.11</scala.version>

    <spark.version>2.4.0</spark.version>

</properties>

<dependencies>

    <!-- Spark Streaming-->

    <dependency>

        <groupId>org.apache.spark</groupId>

        <artifactId>spark-streaming_${scala.version}</artifactId>

        <version>${spark.version}</version>

    </dependency>

    <!-- Spark Streaming 整合 Flume 依赖-->

    <dependency>

        <groupId>org.apache.spark</groupId>

        <artifactId>spark-streaming-flume_${scala.version}</artifactId>

        <version>2.4.3</version>

    </dependency>

</dependencies>
2.3 Spark Streaming接收日志数据
调用 FlumeUtils 工具类的 createStream 方法,对 hadoop001 的 8888 端口进行监听,获取到流数据并进行打印:
import org.apache.spark.SparkConf

import org.apache.spark.streaming.{Seconds, StreamingContext}

import org.apache.spark.streaming.flume.FlumeUtils

object PushBasedWordCount {

  def main(args: Array[String]): Unit = {

    val sparkConf = new SparkConf()

    val ssc = new StreamingContext(sparkConf, Seconds(5))

    // 1.获取输入流

    val flumeStream = FlumeUtils.createStream(ssc, "hadoop001", 8888)

    // 2.打印输入流的数据

    flumeStream.map(line => new String(line.event.getBody.array()).trim).print()

    ssc.start()

    ssc.awaitTermination()

  }

}
2.4 项目打包
因为 Spark 安装目录下是不含有 spark-streaming-flume 依赖包的,所以在提交到集群运行时候必须提供该依赖包,你可以在提交命令中使用 --jar 指定上传到服务器的该依赖包,或者使用 --packages org.apache.spark:spark-streaming-flume_2.12:2.4.3 指定依赖包的完整名称,这样程序在启动时会先去中央仓库进行下载。
这里我采用的是第三种方式:使用 maven-shade-plugin 插件进行 ALL IN ONE 打包,把所有依赖的 Jar 一并打入最终包中。需要注意的是 spark-streaming 包在 Spark 安装目录的 jars 目录中已经提供,所以不需要打入。插件配置如下:
<build>

    <plugins>

        <plugin>

            <groupId>org.apache.maven.plugins</groupId>

            <artifactId>maven-compiler-plugin</artifactId>

            <configuration>

                <source>8</source>

                <target>8</target>

            </configuration>

        </plugin>

        <!--使用 shade 进行打包-->

        <plugin>

            <groupId>org.apache.maven.plugins</groupId>

            <artifactId>maven-shade-plugin</artifactId>

            <configuration>

                <createDependencyReducedPom>true</createDependencyReducedPom>

                <filters>

                    <filter>

                        <artifact>*:*</artifact>

                        <excludes>

                            <exclude>META-INF/*.SF</exclude>

                            <exclude>META-INF/*.sf</exclude>

                            <exclude>META-INF/*.DSA</exclude>

                            <exclude>META-INF/*.dsa</exclude>

                            <exclude>META-INF/*.RSA</exclude>

                            <exclude>META-INF/*.rsa</exclude>

                            <exclude>META-INF/*.EC</exclude>

                            <exclude>META-INF/*.ec</exclude>

                            <exclude>META-INF/MSFTSIG.SF</exclude>

                            <exclude>META-INF/MSFTSIG.RSA</exclude>

                        </excludes>

                    </filter>

                </filters>

                <artifactSet>

                    <excludes>

                        <exclude>org.apache.spark:spark-streaming_${scala.version}</exclude>

                        <exclude>org.scala-lang:scala-library</exclude>

                        <exclude>org.apache.commons:commons-lang3</exclude>

                    </excludes>

                </artifactSet>

            </configuration>

            <executions>

                <execution>

                    <phase>package</phase>

                    <goals>

                        <goal>shade</goal>

                    </goals>

                    <configuration>

                        <transformers>

                            <transformer

                              implementation="org.apache.maven.plugins.shade.resource.ServicesResourceTransformer"/>

                            <transformer

                              implementation="org.apache.maven.plugins.shade.resource.ManifestResourceTransformer">

                            </transformer>

                        </transformers>

                    </configuration>

                </execution>

            </executions>

        </plugin>

        <!--打包.scala 文件需要配置此插件-->

        <plugin>

            <groupId>org.scala-tools</groupId>

            <artifactId>maven-scala-plugin</artifactId>

            <version>2.15.1</version>

            <executions>

                <execution>

                    <id>scala-compile</id>

                    <goals>

                        <goal>compile</goal>

                    </goals>

                    <configuration>

                        <includes>

                            <include>**/*.scala</include>

                        </includes>

                    </configuration>

                </execution>

                <execution>

                    <id>scala-test-compile</id>

                    <goals>

                        <goal>testCompile</goal>

                    </goals>

                </execution>

            </executions>

        </plugin>

    </plugins>

</build>
本项目完整源码见:spark-streaming-flume
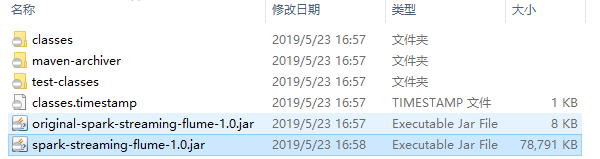
使用 mvn clean package 命令打包后会生产以下两个 Jar 包,提交 非 original 开头的 Jar 即可。
2.5 启动服务和提交作业
启动 Flume 服务:
flume-ng agent \

--conf conf \

--conf-file /usr/app/apache-flume-1.6.0-cdh5.15.2-bin/examples/netcat-memory-avro.properties \

--name a1 -Dflume.root.logger=INFO,console
提交 Spark Streaming 作业:
spark-submit \

--class com.heibaiying.flume.PushBasedWordCount \

--master local[4] \

/usr/appjar/spark-streaming-flume-1.0.jar
2.6 测试
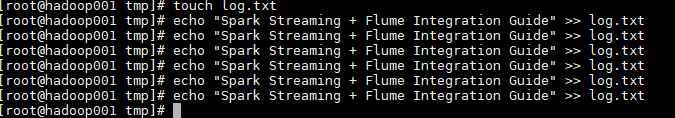
这里使用 echo 命令模拟日志产生的场景,往日志文件中追加数据,然后查看程序的输出:
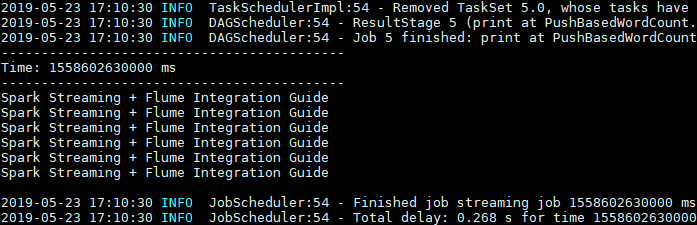
Spark Streaming 程序成功接收到数据并打印输出:
2.7 注意事项
1. 启动顺序
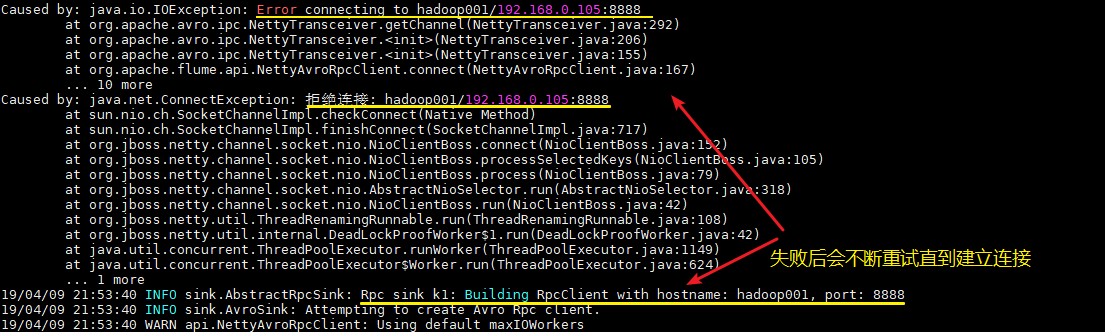
这里需要注意的,不论你先启动 Spark 程序还是 Flume 程序,由于两者的启动都需要一定的时间,此时先启动的程序会短暂地抛出端口拒绝连接的异常,此时不需要进行任何操作,等待两个程序都启动完成即可。
2. 版本一致
最好保证用于本地开发和编译的 Scala 版本和 Spark 的 Scala 版本一致,至少保证大版本一致,如都是 2.11。
三、拉取式方法
拉取式方法 (Pull-based Approach using a Custom Sink) 是将数据推送到 SparkSink 接收器中,此时数据会保持缓冲状态,Spark Streaming 定时从接收器中拉取数据。这种方式是基于事务的,即只有在 Spark Streaming 接收和复制数据完成后,才会删除缓存的数据。与第一种方式相比,具有更强的可靠性和容错保证。整合步骤如下:
3.1 配置日志收集Flume
新建 Flume 配置文件 netcat-memory-sparkSink.properties,配置和上面基本一致,只是把 a1.sinks.k1.type 的属性修改为 org.apache.spark.streaming.flume.sink.SparkSink,即采用 Spark 接收器。
#指定agent的sources,sinks,channels

a1.sources = s1

a1.sinks = k1

a1.channels = c1

#配置sources属性

a1.sources.s1.type = exec

a1.sources.s1.command = tail -F /tmp/log.txt

a1.sources.s1.shell = /bin/bash -c

a1.sources.s1.channels = c1

#配置sink

a1.sinks.k1.type = org.apache.spark.streaming.flume.sink.SparkSink

a1.sinks.k1.hostname = hadoop001

a1.sinks.k1.port = 8888

a1.sinks.k1.batch-size = 1

a1.sinks.k1.channel = c1

#配置channel类型

a1.channels.c1.type = memory

a1.channels.c1.capacity = 1000

a1.channels.c1.transactionCapacity = 100
2.2 新增依赖
使用拉取式方法需要额外添加以下两个依赖:
<dependency>

    <groupId>org.scala-lang</groupId>

    <artifactId>scala-library</artifactId>

    <version>2.12.8</version>

</dependency>

<dependency>

    <groupId>org.apache.commons</groupId>

    <artifactId>commons-lang3</artifactId>

    <version>3.5</version>

</dependency>
注意:添加这两个依赖只是为了本地测试,Spark 的安装目录下已经提供了这两个依赖,所以在最终打包时需要进行排除。
2.3 Spark Streaming接收日志数据
这里和上面推送式方法的代码基本相同,只是将调用方法改为 createPollingStream。
import org.apache.spark.SparkConf

import org.apache.spark.streaming.{Seconds, StreamingContext}

import org.apache.spark.streaming.flume.FlumeUtils

object PullBasedWordCount {

  def main(args: Array[String]): Unit = {

    val sparkConf = new SparkConf()

    val ssc = new StreamingContext(sparkConf, Seconds(5))

    // 1.获取输入流

    val flumeStream = FlumeUtils.createPollingStream(ssc, "hadoop001", 8888)

    // 2.打印输入流中的数据

    flumeStream.map(line => new String(line.event.getBody.array()).trim).print()

    ssc.start()

    ssc.awaitTermination()

  }

}
2.4 启动测试
启动和提交作业流程与上面相同,这里给出执行脚本,过程不再赘述。
启动 Flume 进行日志收集:
flume-ng agent \

--conf conf \

--conf-file /usr/app/apache-flume-1.6.0-cdh5.15.2-bin/examples/netcat-memory-sparkSink.properties \

--name a1 -Dflume.root.logger=INFO,console
提交 Spark Streaming 作业:
spark-submit \

--class com.heibaiying.flume.PullBasedWordCount \

--master local[4] \

/usr/appjar/spark-streaming-flume-1.0.jar
参考资料
- streaming-flume-integration
- 关于大数据应用常用的打包方式可以参见:大数据应用常用打包方式
入门大数据---Spark_Streaming整合Flume的更多相关文章
- 入门大数据---Spark_Streaming整合Kafka
一.版本说明 Spark 针对 Kafka 的不同版本,提供了两套整合方案:spark-streaming-kafka-0-8 和 spark-streaming-kafka-0-10,其主要区别如下 ...
- 入门大数据---Spark_Streaming基本操作
一.案例引入 这里先引入一个基本的案例来演示流的创建:获取指定端口上的数据并进行词频统计.项目依赖和代码实现如下: <dependency> <groupId>org.apac ...
- 入门大数据---Spark_Streaming与流处理
一.流处理 1.1 静态数据处理 在流处理之前,数据通常存储在数据库,文件系统或其他形式的存储系统中.应用程序根据需要查询数据或计算数据.这就是传统的静态数据处理架构.Hadoop 采用 HDFS 进 ...
- 大数据系列之Flume+kafka 整合
相关文章: 大数据系列之Kafka安装 大数据系列之Flume--几种不同的Sources 大数据系列之Flume+HDFS 关于Flume 的 一些核心概念: 组件名称 功能介绍 Agent ...
- 入门大数据---Flume整合Kafka
一.背景 先说一下,为什么要使用 Flume + Kafka? 以实时流处理项目为例,由于采集的数据量可能存在峰值和峰谷,假设是一个电商项目,那么峰值通常出现在秒杀时,这时如果直接将 Flume 聚合 ...
- 大数据技术之Flume
第1章 概述 1.1 Flume定义 Flume是Cloudera提供的一个高可用的,高可靠的,分布式的海量日志采集.聚合和传输的系统.Flume基于流式架构,灵活简单. 1.2 Flume组成架构 ...
- 入门大数据---Flink学习总括
第一节 初识 Flink 在数据激增的时代,催生出了一批计算框架.最早期比较流行的有MapReduce,然后有Spark,直到现在越来越多的公司采用Flink处理.Flink相对前两个框架真正做到了高 ...
- 低调、奢华、有内涵的敏捷式大数据方案:Flume+Cassandra+Presto+SpagoBI
基于FacebookPresto+Cassandra的敏捷式大数据 文件夹 1 1.1 1.1.1 1.1.2 1.2 1.2.1 1.2.2 2 2.1 2.2 2.3 2.4 2.5 2.6 3 ...
- 入门大数据---SparkSQL外部数据源
一.简介 1.1 多数据源支持 Spark 支持以下六个核心数据源,同时 Spark 社区还提供了多达上百种数据源的读取方式,能够满足绝大部分使用场景. CSV JSON Parquet ORC JD ...
随机推荐
- Rocket - debug - TLDebugModuleOuter
https://mp.weixin.qq.com/s/9nMo6IYmDCz7S-ALFx824g 简单介绍TLDebugModuleOuter的实现. 1. DebugModuleAccessTyp ...
- 判断IP地址的合法性
每台计算机都有独一无二的编号,称为ip地址,每个合法的ip地址由‘.’分隔开的4个数字组成,每个数字的取值范围为0--255 输入一个字符串,判断其是否为合法的IP地址,若是输出‘YES’,否则输出‘ ...
- LeetCode 74,直击BAT经典面试题
本文始发于个人公众号:TechFlow,原创不易,求个关注 今天是LeetCode专题43篇文章,我们今天来看一下LeetCode当中的74题,搜索二维矩阵,search 2D Matrix. 这题的 ...
- Java实现 LeetCode 824 山羊拉丁文(暴力)
824. 山羊拉丁文 给定一个由空格分割单词的句子 S.每个单词只包含大写或小写字母. 我们要将句子转换为 "Goat Latin"(一种类似于 猪拉丁文 - Pig Latin ...
- Java实现 LeetCode 652 寻找重复的子树(两个map的DFS)
652. 寻找重复的子树 给定一棵二叉树,返回所有重复的子树.对于同一类的重复子树,你只需要返回其中任意一棵的根结点即可. 两棵树重复是指它们具有相同的结构以及相同的结点值. 示例 1: 1 / \ ...
- Java实现 LeetCode 433 最小基因变化
433. 一条基因序列由一个带有8个字符的字符串表示,其中每个字符都属于 "A", "C", "G", "T"中的任意一 ...
- Java实现 蓝桥杯VIP 算法训练 排列问题
算法训练 排列问题 时间限制:1.0s 内存限制:512.0MB 问题描述 求一个0-N-1的排列(即每个数只能出现一次),给出限制条件(一张N*N的表,第i行第j列的1或0,表示为j-1这个数不能出 ...
- Java实现 LeetCode 200 岛屿数量
200. 岛屿数量 给定一个由 '1'(陆地)和 '0'(水)组成的的二维网格,计算岛屿的数量.一个岛被水包围,并且它是通过水平方向或垂直方向上相邻的陆地连接而成的.你可以假设网格的四个边均被水包围. ...
- Java实现第十届蓝桥杯最大降雨量
试题 E: 最大降雨量 本题总分:15 分 [问题描述] 由于沙之国长年干旱,法师小明准备施展自己的一个神秘法术来求雨. 这个法术需要用到他手中的 49 张法术符,上面分别写着 1 至 49 这 49 ...
- java实现第四届蓝桥杯猜灯谜
猜灯谜 题目描述 A 村的元宵节灯会上有一迷题: 请猜谜 * 请猜谜 = 请边赏灯边猜 小明想,一定是每个汉字代表一个数字,不同的汉字代表不同的数字. 请你用计算机按小明的思路算一下,然后提交&quo ...