
python爬虫-使用cookie登录
前言:
什么是cookie?
Cookie,指某些网站为了辨别用户身份、进行session跟踪而储存在用户本地终端上的数据(通常经过加密)。
比如说有些网站需要登录后才能访问某个页面,在登录之前,你想抓取某个页面内容是不允许的。那么我们可以利用Urllib库保存我们登录的Cookie,然后再抓取其他页面,这样就达到了我们的目的。
一、Urllib库简介
Urllib是python内置的HTTP请求库,官方地址:https://docs.python.org/3/library/urllib.html
包括以下模块:
>>>urllib.request 请求模块

>>>urllib.error 异常处理模块

>>>urllib.parse url解析模块

>>>urllib.robotparser robots.txt解析模块
二、urllib.request.urlopen介绍
uurlopen一般常用的有三个参数,它的参数如下:
urllib.requeset.urlopen(url,data,timeout)
简单的例子:
1、url参数的使用(请求的URL)
response = urllib.request.urlopen('http://www.baidu.com')
2、data参数的使用(以post请求方式请求)
data= bytes(urllib.parse.urlencode({'word':'hello'}), encoding='utf8')

response= urllib.request.urlopen('http://www.baidu.com/post', data=data)
3、timeout参数的使用(请求设置一个超时时间,而不是让程序一直在等待结果)
response= urllib.request.urlopen('http://www.baidu.com/get', timeout=)
三、构造Requset
1、数据传送POST和GET(举例说明:此处列举登录的请求,定义一个字典为values,参数为:email和password,然后利用urllib.parse.urlencode方法将字典编码,命名为data,构建request时传入两个参数:url、data。运行程序,即可实现登陆。)
GET方式:直接以链接形式访问,链接中包含了所有的参数。
LOGIN_URL= "http://*******/postLogin/" values={'email':'*******@***com','password':'****'} data=urllib.parse.urlencode(values).encode() geturl = LOGIN_URL+ "?"+data request = urllib.request.Request(geturl)
POST方式:上面说的data参数就是用在这里的,我们传送的数据就是这个参数data。
LOGIN_URL='http://******/postLogin/'

values={'email':'*******@***.com','password':'*****'}

data=urllib.parse.urlencode(values).encode()

request=urllib.request.Request(URL,data)
2、设置Headers(有些网站不会同意程序直接用上面的方式进行访问,如果识别有问题,那么站点根本不会响应,所以为了完全模拟浏览器的工作,我们需要设置一些Headers 的属性)

举例:(这个例子只是说明了怎样设置headers)
user_agent = r'Mozilla/5.0 (Windows NT 6.1; Win64; x64; rv:55.0) Gecko/20100101 Firefox/55.0'

headers={'User-Agent':user_agent,'Connection':'keep-alive'}

request=urllib.request.Request(URL,data,headers)
四、使用cookie登录
1、获取登录网址
浏览器输入需要登录的网址:'http://*****/login'(注意:这个并非其真实站点登录网址),使用抓包工具fiddler抓包(其他工具也可)找到登录后看到的request。
此处确定需要登录的网址为:'http://*****/postLogin/'

2、查看要传送的post数据
找到登录后的request中有webforms的信息,会列出登录要用的post数据,包括Email,password,auth。
找到登录后看到的request的headers信息,找出User-Agent设置、connection设置等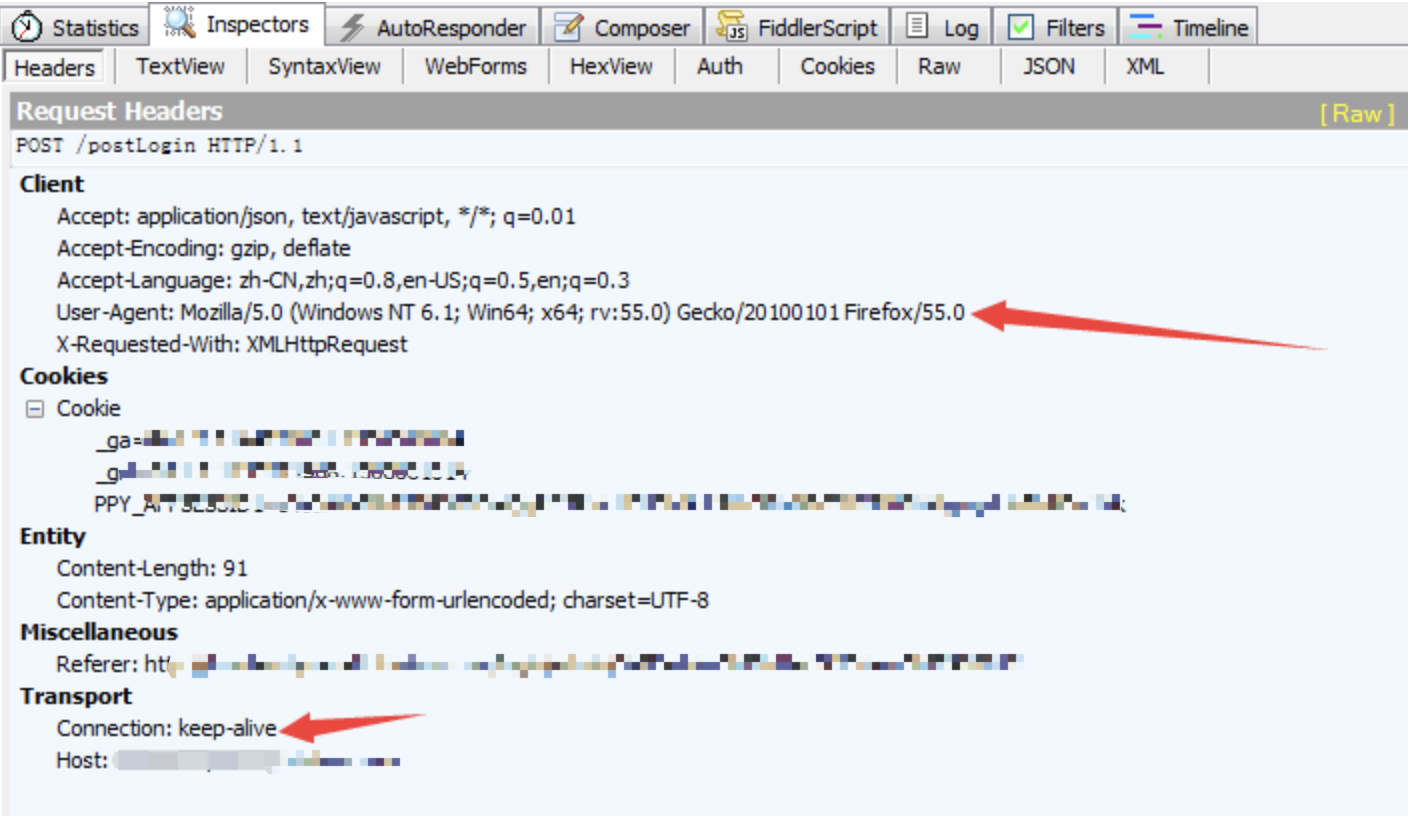
4、开始编码,使用cookie登录该网站
import urllib.error, urllib.request, urllib.parse

import http.cookiejar

LOGIN_URL = 'http://******/postLogin'

#get_url为使用cookie所登陆的网址,该网址必须先登录才可

get_url = 'https://*****/pending'

values = {'email':'*****','password':'******','auth':'admin'}

postdata = urllib.parse.urlencode(values).encode()

user_agent = r'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_13_3) AppleWebKit/537.36' \

             r' (KHTML, like Gecko) Chrome/61.0.3163.79 Safari/537.36'

headers = {'User-Agent':user_agent, 'Connection':'keep-alive'}

#将cookie保存在本地,并命名为cookie.txt

cookie_filename = 'cookie.txt'

cookie_aff = http.cookiejar.MozillaCookieJar(cookie_filename)

handler = urllib.request.HTTPCookieProcessor(cookie_aff)

opener = urllib.request.build_opener(handler)

request = urllib.request.Request(LOGIN_URL, postdata, headers)

try:

    response = opener.open(request)

except urllib.error.URLError as e:

    print(e.reason)

cookie_aff.save(ignore_discard=True, ignore_expires=True)

for item in cookie_aff:

    print('Name ='+ item.name)

    print('Value ='+ item.value)

#使用cookie登陆get_url

get_request = urllib.request.Request(get_url,headers=headers)

get_response = opener.open(get_request)

print(get_response.read().decode())
5、反复使用cookie登录
(上面代码中我们保存cookie到本地了,以下代码我们能够直接从文件导入cookie进行登录,不用再构建request了)
import urllib.request, urllib.parse

import http.cookiejar

get_url = 'https://******/pending'

cookie_filename = 'cookie.txt'

cookie_aff = http.cookiejar.MozillaCookieJar(cookie_filename)

cookie_aff.load(cookie_filename,ignore_discard=True,ignore_expires=True)

handler = urllib.request.HTTPCookieProcessor(cookie_aff)

opener = urllib.request.build_opener(handler)

#使用cookie登陆get_url

get_request = urllib.request.Request(get_url)

get_response = opener.open(get_request)

print(get_response.read().decode())
以上
python爬虫-使用cookie登录的更多相关文章
- python爬虫+使用cookie登录豆瓣
2017-10-09 19:06:22 版权声明:本文为博主原创文章,未经博主允许不得转载. 前言: 先获得cookie,然后自动登录豆瓣和新浪微博 系统环境: 64位win10系统,同时装pytho ...
- Python爬虫-百度模拟登录(二)
上一篇-Python爬虫-百度模拟登录(一) 接上一篇的继续 参数 codestring codestring jxG9506c1811b44e2fd0220153643013f7e6b1898075 ...
- Python爬虫之模拟登录微信wechat
不知何时,微信已经成为我们不可缺少的一部分了,我们的社交圈.关注的新闻或是公众号.还有个人信息或是隐私都被绑定在了一起.既然它这么重要,如果我们可以利用爬虫模拟登录,是不是就意味着我们可以获取这些信息 ...
- Python爬虫-百度模拟登录(一)
千呼万唤屎出来呀,百度模拟登录终于要呈现在大家眼前了,最近比较忙,晚上又得早点休息,这篇文章写了好几天才完成.这个成功以后,我打算试试百度网盘的其他接口实现.看看能不能把服务器文件上传到网盘,好歹也有 ...
- python爬虫-知乎登录
#!/usr/bin/env python3 # -*- coding: utf-8 -*- ''' Required - requests (必须) - pillow (可选) ''' import ...
- python爬虫之Cookie
由于http协议是无状态协议(假如登录成功,当访问该网站的其他网页时,登录状态消失),此时,需要将会话信息保存起来,通过cookie或者session的方式 cookie 将所有的回话信息保存在客户端 ...
- Python爬虫之Cookie和Session
关于cookie和session估计很多程序员面试的时候都会被问到,这两个概念在写web以及爬虫中都会涉及,并且两者可能很多人直接回答也不好说的特别清楚,所以整理这样一篇文章,也帮助自己加深理解 什么 ...
- Python爬虫之关于登录那些事
常见的登录方式有以下两种: 查看登录页面,csrf,cookie;授权:cookie 直接发送post请求,获取cookie 上面只是简单的描述,下面是详细的针对两种登录方式的时候爬虫的处理方法 第一 ...
- Python 爬虫之模拟登录
最近应朋友要求,帮忙爬取了小红书创作平台的数据,感觉整个过程很有意思,因此记录一下.在这之前自己没怎么爬过需要账户登录的网站数据,所以刚开始去看小红书的登录认证时一头雾水,等到一步步走下来,最终成功, ...
随机推荐
- Linux系统优化之设置swappiness值提高MySQL查询性能
对MySQL来说,操作系统层面的优化也可以值得考虑一下:就是swappiness. swappiness的大小主要对如何使用swap分区有着密切的联系. 来看一下: [root@chaofeng ~] ...
- arm 开发板更新 gcc/gcc++ | Debain 更新 gcc,无需编译直接更新 gcc
4我的板子是 Orange pi 3,只能以 卧槽来形容... 我是搞.net core的,这板子死活搞不了. 刷的是Debain系统. 说实话,这个板子不错,可就是官方的系统实在不敢恭维,内核旧,软 ...
- Hadoop HBase概念学习系列之HBase里的Zookeeper(二十一)
这个,很简单,但凡是略懂大数据的,就很清楚,不多说,直接上图.
- 4、url控制系统
第1节:简单配置 参考代码: from django.conf.urls import url from . import views urlpatterns = [ url(r'^articles/ ...
- 13.1SolrCloud集群使用手册之Collections API
转载请出自出处:http://www.cnblogs.com/hd3013779515/ 1.创建collection name:指明collection名字 router.name:指定路由策略,默 ...
- Vue入门1
欢迎转载,转载请注明出处. 前言 学习本系列Vue知识,需要结合本系列的一些demo.你可以查看我的 Github 或者直接下载 ZIP包 . 建议学习本系列之前已经会一个其他的前端框架,了解计算属性 ...
- CentOS中配置Kafka集群
环境:三台虚拟机Host0,Host1,Host2 Host0:192.168.10.2 Host1: 192.168.10.3 Host2: 192.168.10.4 在三台虚拟机上配置zook ...
- Android GridView使用View.GONE只隐藏内容而不隐藏空间的解决方案
最近在处理GridView的时候遇到这样一个问题:Android手机客户端接收服务端返回的一串数据(数据条数不固定),这串数据不一定都要显示到GridView上,也就是说有一部分内容需要隐藏掉,即有一 ...
- qmlscene: could not find a Qt installation of ''
qt └── helloqt.qml 在qt目录下运行helloqt.qml文件时出现这个提示: $ qmlscene helloqt.qml qmlscene: could not find a Q ...
- 启动hbase shell报错:org.apache.hadoop.hbase.ipc.ServerNotRunningYetException: Server is not running yet
查看日志发现:Waiting for dfs to exit safe mode 这说明HDFS目前处于安全模式,需要退出才行,于是进入Namdenode节点,执行命令: hdfs dfsadmin ...