
如何重构"箭头型"代码
本文主要起因是,一次在微博上和朋友关于嵌套好几层的if-else语句的代码重构的讨论(微博原文),在微博上大家有各式各样的问题和想法。按道理来说这些都是编程的基本功,似乎不太值得写一篇文章,不过我觉得很多东西可以从一个简单的东西出发,到达本质,所以,我觉得有必要在这里写一篇的文章。不一定全对,只希望得到更多的讨论,因为有了更深入的讨论才能进步。
文章有点长,我在文章最后会给出相关的思考和总结陈词,你可以跳到结尾。
所谓箭头型代码,基本上来说就是下面这个图片所示的情况。
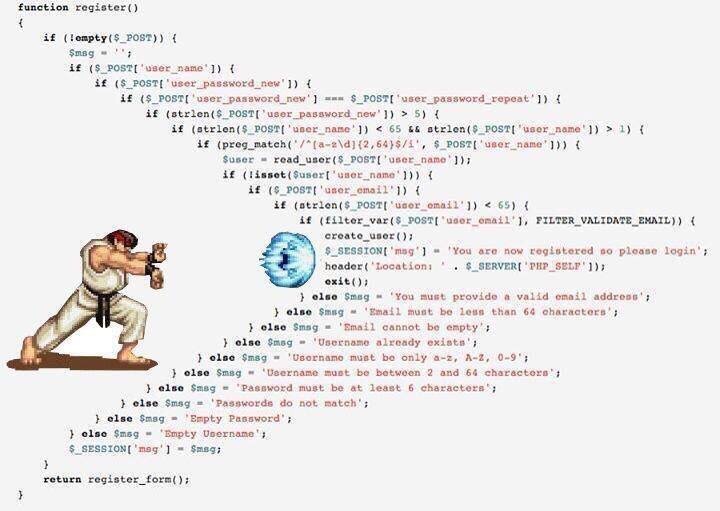
那么,这样“箭头型”的代码有什么问题呢?看上去也挺好看的,有对称美。但是……
关于箭头型代码的问题有如下几个:
1)我的显示器不够宽,箭头型代码缩进太狠了,需要我来回拉水平滚动条,这让我在读代码的时候,相当的不舒服。
2)除了宽度外还有长度,有的代码的if-else里的if-else里的if-else的代码太多,读到中间你都不知道中间的代码是经过了什么样的层层检查才来到这里的。
总而言之,“箭头型代码”如果嵌套太多,代码太长的话,会相当容易让维护代码的人(包括自己)迷失在代码中,因为看到最内层的代码时,你已经不知道前面的那一层一层的条件判断是什么样的,代码是怎么运行到这里的,所以,箭头型代码是非常难以维护和Debug的。
微博上的案例 与 Guard Clauses
OK,我们先来看一下微博上的那个示例,代码量如果再大一点,嵌套再多一点,你很容易会在条件中迷失掉(下面这个示例只是那个“大箭头”下的一个小箭头)
FOREACH(Ptr<WfExpression>, argument, node->arguments) {

    int index = manager->expressionResolvings.Keys().IndexOf(argument.Obj());

    if (index != -) {

        auto type = manager->expressionResolvings.Values()[index].type;

        if (! types.Contains(type.Obj())) {

            types.Add(type.Obj());

            if (auto group = type->GetTypeDescriptor()->GetMethodGroupByName(L"CastResult", true)) {

                int count = group->GetMethodCount();

                for (int i = ; i < count; i++) { auto method = group->GetMethod(i);

                    if (method->IsStatic()) {

                        if (method->GetParameterCount() ==  &&

                            method->GetParameter()->GetType()->GetTypeDescriptor() == description::GetTypeDescriptor<DescriptableObject>() &&

                            method->GetReturn()->GetTypeDescriptor() != description::GetTypeDescriptor<void>() ) {

                            symbol->typeInfo = CopyTypeInfo(method->GetReturn());

                            break;

                        }

                    }

                }

            }

        }

    }

}
上面这段代码,可以把条件反过来写,然后就可以把箭头型的代码解掉了,重构的代码如下所示:
FOREACH(Ptr<WfExpression>, argument, node->arguments) {

    int index = manager->expressionResolvings.Keys().IndexOf(argument.Obj());

    if (index == -)  continue;

    auto type = manager->expressionResolvings.Values()[index].type;

    if ( types.Contains(type.Obj()))  continue;

    types.Add(type.Obj());

    auto group = type->GetTypeDescriptor()->GetMethodGroupByName(L"CastResult", true);

    if  ( ! group ) continue;

    int count = group->GetMethodCount();

    for (int i = ; i < count; i++) { auto method = group->GetMethod(i);

        if (! method->IsStatic()) continue;

        if ( method->GetParameterCount() ==  &&

               method->GetParameter()->GetType()->GetTypeDescriptor() == description::GetTypeDescriptor<DescriptableObject>() &&

               method->GetReturn()->GetTypeDescriptor() != description::GetTypeDescriptor<void>() ) {

            symbol->typeInfo = CopyTypeInfo(method->GetReturn());

            break;

        }

    }

}
这种代码的重构方式叫 Guard Clauses
- Martin Fowler 的 Refactoring 的网站上有相应的说明《Replace Nested Conditional with Guard Clauses》。
- Coding Horror 上也有一篇文章讲了这种重构的方式 —— 《Flattening Arrow Code》
- StackOverflow 上也有相关的问题说了这种方式 —— 《Refactor nested IF statement for clarity》
这里的思路其实就是,让出错的代码先返回,前面把所有的错误判断全判断掉,然后就剩下的就是正常的代码了。
抽取成函数
微博上有些人说,continue 语句破坏了阅读代码的通畅,我觉得他们一定没有好好读这里面的代码,其实,我们可以看到,所有的 if 语句都是在判断是否出错的情况,所以,在维护代码的时候,你可以完全不理会这些 if 语句,因为都是出错处理的,而剩下的代码都是正常的功能代码,反而更容易阅读了。当然,一定有不是上面代码里的这种情况,那么,不用continue ,我们还能不能重构呢?
当然可以,抽成函数:
bool CopyMethodTypeInfo(auto &method, auto &group, auto &symbol)

{

    if (! method->IsStatic()) {

        return true;

    }

    if ( method->GetParameterCount() ==  &&

           method->GetParameter()->GetType()->GetTypeDescriptor() == description::GetTypeDescriptor<DescriptableObject>() &&

           method->GetReturn()->GetTypeDescriptor() != description::GetTypeDescriptor<void>() ) {

        symbol->typeInfo = CopyTypeInfo(method->GetReturn());

        return false;

    }

    return true;

}

void ExpressionResolvings(auto &manager, auto &argument, auto &symbol)

{

    int index = manager->expressionResolvings.Keys().IndexOf(argument.Obj());

    if (index == -) return;

    auto type = manager->expressionResolvings.Values()[index].type;

    if ( types.Contains(type.Obj())) return;

    types.Add(type.Obj());

    auto group = type->GetTypeDescriptor()->GetMethodGroupByName(L"CastResult", true);

    if  ( ! group ) return;

    int count = group->GetMethodCount();

    for (int i = ; i < count; i++) { auto method = group->GetMethod(i);

        if ( ! CopyMethodTypeInfo(method, group, symbol) ) break;

    }

}

...

...

FOREACH(Ptr<WfExpression>, argument, node->arguments) {

    ExpressionResolvings(manager, arguments, symbol)

}
你发出现,抽成函数后,代码比之前变得更容易读和更容易维护了。不是吗?
有人说:“如果代码不共享,就不要抽取成函数!”,持有这个观点的人太死读书了。函数是代码的封装或是抽象,并不一定用来作代码共享使用,函数用于 屏蔽细节,让其它代码耦合于接口而不是细节实现,这会让我们的代码更为简单,简单的东西都能让人易读也易维护。这才是函数的作用。
嵌套的 if 外的代码
微博上还有人问,原来的代码如果在各个 if 语句后还有要执行的代码,那么应该如何重构。比如下面这样的代码。
原版
for(....) {

    do_before_cond1()

    if (cond1) {

        do_before_cond2();

        if (cond2) {

            do_before_cond3();

            if (cond3) {

                do_something();

            }

            do_after_cond3();

        }

        do_after_cond2();

    }

    do_after_cond1();

}
上面这段代码中的那些 do_after_condX() 是无论条件成功与否都要执行的。所以,我们拉平后的代码如下所示:
重构第一版
for(....) {

    do_before_cond1();

    if ( !cond1 ) {

        do_after_cond1();

        continue

    }

    do_after_cond1();

    do_before_cond2();

    if ( !cond2 ) {

        do_after_cond2();

        continue;

    }

    do_after_cond2();

    do_before_cond3();

    if ( !cond3 ) {

        do_after_cond3();

        continue;

    }

    do_after_cond3();

    do_something();

}
你会发现,上面的 do_after_condX 出现了两份。如果 if 语句块中的代码改变了某些do_after_condX依赖的状态,那么这是最终版本。
但是,如果它们之前没有依赖关系的话,根据 DRY 原则,我们就可以只保留一份,那么直接掉到 if 条件前就好了,如下所示:
重构第二版
for(....) {

    do_before_cond1();

    do_after_cond1();

    if ( !cond1 ) continue;

    do_before_cond2();

    do_after_cond2();

    if ( !cond2 ) continue;

    do_before_cond3();

    do_after_cond3();

    if ( !cond3 ) continue;

    do_something();

}
此时,你会说,我靠,居然,改变了执行的顺序,把条件放到 do_after_condX() 后面去了。这会不会有问题啊?
其实,你再分析一下之前的代码,你会发现,本来,cond1 是判断 do_before_cond1() 是否出错的,如果有成功了,才会往下执行。而 do_after_cond1() 是无论如何都要执行的。从逻辑上来说,do_after_cond1()其实和do_before_cond1()的执行结果无关,而 cond1 却和是否去执行 do_before_cond2() 相关了。如果我把断行变成下面这样,反而代码逻辑更清楚了。
重构第三版
for(....) {

    do_before_cond1();

    do_after_cond1();

    if ( !cond1 ) continue;  // <-- cond1 成了是否做第二个语句块的条件

    do_before_cond2();

    do_after_cond2();

    if ( !cond2 ) continue; // <-- cond2 成了是否做第三个语句块的条件

    do_before_cond3();

    do_after_cond3();

    if ( !cond3 ) continue; //<-- cond3 成了是否做第四个语句块的条件

    do_something();

}
于是乎,在未来维护代码的时候,维护人一眼看上去就明白,代码在什么时候会执行到哪里。 这个时候,你会发现,把这些语句块抽成函数,代码会干净的更多,再重构一版:
重构第四版
bool do_func3() {

   do_before_cond2();

   do_after_cond2();

   return cond3;

}

bool do_func2() {

   do_before_cond2();

   do_after_cond2();

   return cond2;

}

bool do_func1() {

   do_before_cond1();

   do_after_cond1();

   return cond1;

}

// for-loop 你可以重构成这样

for (...) {

    bool cond = do_func1();

    if (cond) cond = do_func2();

    if (cond) cond = do_func3();

    if (cond) do_something();

}

// for-loop 也可以重构成这样

for (...) {

    if ( ! do_func1() ) continue;

    if ( ! do_func2() ) continue;

    if ( ! do_func3() ) continue;

    do_something();

}
上面,我给出了两个版本的for-loop,你喜欢哪个?我喜欢第二个。这个时候,因为for-loop里的代码非常简单,就算你不喜欢 continue ,这样的代码阅读成本已经很低了。
状态检查嵌套
接下来,我们再来看另一个示例。下面的代码的伪造了一个场景——把两个人拉到一个一对一的聊天室中,因为要检查双方的状态,所以,代码可能会写成了“箭头型”。
int ConnectPeer2Peer(Conn *pA, Conn* pB, Manager *manager)

{

    if ( pA->isConnected() ) {

        manager->Prepare(pA);

        if ( pB->isConnected() ) {

            manager->Prepare(pB);

            if ( manager->ConnectTogther(pA, pB) ) {

                pA->Write("connected");

                pB->Write("connected");

                return S_OK;

            }else{

                return S_ERROR;

            }

        }else {

            pA->Write("Peer is not Ready, waiting...");

            return S_RETRY;

        }

    }else{

        if ( pB->isConnected() ) {

            manager->Prepare();

            pB->Write("Peer is not Ready, waiting...");

            return S_RETRY;

        }else{

            pA->Close();

            pB->Close();

            return S_ERROR;

        }

    }

    //Shouldn't be here!

    return S_ERROR;

}
重构上面的代码,我们可以先分析一下上面的代码,说明了,上面的代码就是对 PeerA 和 PeerB 的两个状态 “连上”, “未连上” 做组合 “状态” (注:实际中的状态应该比这个还要复杂,可能还会有“断开”、“错误”……等等状态), 于是,我们可以把代码写成下面这样,合并上面的嵌套条件,对于每一种组合都做出判断。这样一来,逻辑就会非常的干净和清楚。
int ConnectPeer2Peer(Conn *pA, Conn* pB, Manager *manager)

{

    if ( pA->isConnected() ) {

        manager->Prepare(pA);

    }

    if ( pB->isConnected() ) {

        manager->Prepare(pB);

    }

    // pA = YES && pB = NO

    if (pA->isConnected() && ! pB->isConnected()  ) {

        pA->Write("Peer is not Ready, waiting");

        return S_RETRY;

    // pA = NO && pB = YES

    }else if ( !pA->isConnected() && pB->isConnected() ) {

        pB->Write("Peer is not Ready, waiting");

        return S_RETRY;

    // pA = YES && pB = YES

    }else if (pA->isConnected() && pB->isConnected()  ) {

        if ( ! manager->ConnectTogther(pA, pB) ) {

            return S_ERROR;

        }

        pA->Write("connected");

        pB->Write("connected");

        return S_OK;

    }

    // pA = NO, pB = NO

    pA->Close();

    pB->Close();

    return S_ERROR;

}
延伸思考
对于 if-else 语句来说,一般来说,就是检查两件事:错误 和 状态。
检查错误
对于检查错误来说,使用 Guard Clauses 会是一种标准解,但我们还需要注意下面几件事:
1)当然,出现错误的时候,还会出现需要释放资源的情况。你可以使用 goto fail; 这样的方式,但是最优雅的方式应该是C++面向对象式的 RAII 方式。
2)以错误码返回是一种比较简单的方式,这种方式有很一些问题,比如,如果错误码太多,判断出错的代码会非常复杂,另外,正常的代码和错误的代码会混在一起,影响可读性。所以,在更为高组的语言中,使用 try-catch 异常捕捉的方式,会让代码更为易读一些。
检查状态
对于检查状态来说,实际中一定有更为复杂的情况,比如下面几种情况:
1)像TCP协议中的两端的状态变化。
2)像shell各个命令的命令选项的各种组合。
3)像游戏中的状态变化(一棵非常复杂的状态树)。
4)像语法分析那样的状态变化。
对于这些复杂的状态变化,其本上来说,你需要先定义一个状态机,或是一个子状态的组合状态的查询表,或是一个状态查询分析树。
写代码时,代码的运行中的控制状态或业务状态是会让你的代码流程变得混乱的一个重要原因,重构“箭头型”代码的一个很重要的工作就是重新梳理和描述这些状态的变迁关系。
总结
好了,下面总结一下,把“箭头型”代码重构掉的几个手段如下:
1)使用 Guard Clauses 。 尽可能的让出错的先返回, 这样后面就会得到干净的代码。
2)把条件中的语句块抽取成函数。 有人说:“如果代码不共享,就不要抽取成函数!”,持有这个观点的人太死读书了。函数是代码的封装或是抽象,并不一定用来作代码共享使用,函数用于屏蔽细节,让其它代码耦合于接口而不是细节实现,这会让我们的代码更为简单,简单的东西都能让人易读也易维护,写出让人易读易维护的代码才是重构代码的初衷!
3)对于出错处理,使用try-catch异常处理和RAII机制。返回码的出错处理有很多问题,比如:A) 返回码可以被忽略,B) 出错处理的代码和正常处理的代码混在一起,C) 造成函数接口污染,比如像atoi()这种错误码和返回值共用的糟糕的函数。
4)对于多个状态的判断和组合,如果复杂了,可以使用“组合状态表”,或是状态机加Observer的状态订阅的设计模式。这样的代码即解了耦,也干净简单,同样有很强的扩展性。
5) 重构“箭头型”代码其实是在帮你重新梳理所有的代码和逻辑,这个过程非常值得为之付出。重新整思路去想尽一切办法简化代码的过程本身就可以让人成长。
如何重构"箭头型"代码的更多相关文章
- 敏捷开发松结对编程系列:L型代码结构案例StatusFiltersDropdownList(中)
这是松结对编程的第22篇(专栏目录). 接前文 业务代码 比较长,基本上就是看被注释隔开的三大段,先显示状态群筛选链接,然后是单个状态筛选,然后是显示下拉框的当前选中项,最后显示下拉框. public ...
- L型代码结构案例:Link访问权限(上)
这是松结对编程的第20篇(专栏目录). 本文探讨Link访问权限的最佳实现方法,力求外观干净且封装良好. 这些代码将位于L型代码结构(参见松结对编程系列中的定义)的下层,调用者无需理解其原理. 顺便说 ...
- 使用策略模式重构switch case 代码
目录 1.背景 2.案例 3.switch…case…方式实现 4.switch…case…带来的问题 5.使用策略模式重构switch…case…代码 6.总结 1.背景 之前在看<重构 ...
- 业务型代码常用的SQL汇总(随时更新)
做了一年的业务代码开发,记录并分享一下自己平时在项目中遇到的比较好用的sql 1.查询表中是否某一字段下的数据有重复数据(以ID为例) SELECT id FROM 表名GROUP BY ID HAV ...
- js基石之---易读、易复用、易重构的 JavaScript 代码规范
易读.易复用.易重构的 JavaScript 代码规范 1.变量命名规范有意义 Bad: const yyyymmdstr = moment().format("YYYY/MM/DD&quo ...
- .NET重构—单元测试的代码重构
阅读目录: 1.开篇介绍 2.单元测试.测试用例代码重复问题(大量使用重复的Mock对象及测试数据) 2.1.单元测试的继承体系(利用超类来减少Mock对象的使用) 2.1.1.公用的MOCK对象: ...
- 重构 MVC; 代码分享工具(重构,改进,打分)
include 模块和 extend 模块的不同: Class Extension: 通过向singleton class中加入Module来定义class method,是对象扩展的一个特例. ...
- 重构 之 总结代码的坏味道 Bad Smell (一) 重复代码 过长函数 过大的类 过长参数列 发散式变化 霰弹式修改
膜拜下 Martin Fowler 大神 , 开始学习 圣经 重构-改善既有代码设计 . 代码的坏味道就意味着需要重构, 对代码的坏味道了然于心是重构的比要前提; . 作者 : 万境绝尘 转载请注明出 ...
- 重构get请求代码---PartyLocation
将原理在PersonDto中定义的partyLocations,剪切到PartyDto中去. @JsonApiToMany private List<PartyLocationDto> p ...
随机推荐
- Kibana部署及配置(四)
一.Kibana安装 Kibana 是为 Elasticsearch 设计的开源分析和可视化平台.你可以使用 Kibana 来搜索,查看存储在 Elasticsearch 索引中的数据并与之交互.你可 ...
- 使用chrales抓包IOS的https(pc+手机)
1.安装SSL证书到手机 点击 Help -> SSL Proxying -> Install Charles Root Certificate on a Mobile Device 2. ...
- 人生第一个快速幂的题(HDU - 1097--A hard puzzle )
题意: 最简单的快速幂.给你两个数n和m,求n^m的最后一位: 解题思路: 额,快速幂就很简单了,这里只要最后一位可以一对每次运算都%10: 代码: #include<cstdio> #i ...
- 虚拟机spark集群搭建
RDD弹性分布式数据集 (Resilient Distributed Dataset) RDD只读可分区,数据集可以缓存在内存中,在多次计算间重复利用. 弹性是指内存不够时可以与磁盘进行交互 join ...
- 洛谷P1154 奶牛分厩
P1154 奶牛分厩 173通过 481提交 题目提供者该用户不存在 标签高性能 难度普及- 时空限制1s / 128MB 提交 讨论 题解 最新讨论更多讨论 测试点3??? 求助!超时了 我抗议 ...
- get与post区别大揭秘
以往的标准答案: GET在浏览器回退时是无害的,而POST会再次提交请求. GET请求会被浏览器主动cache,而POST不会,除非手动设置. GET请求只能进行url编码,而POST支持多种编码方式 ...
- PHP 笔记——文件引用
1. 文件路径 "文件路径"指的是被包含文件所在的绝对路径或相对路径. 在相对路径中,"./"表示当前目录,"../"表示当前目录的上级目录 ...
- MyTalkStuffHomeIcon-2
圆形.高清头像素材专用-2
- ISO 7816-4: Interindustry Commands for Interchange
5. Basic Organizations 5.1 Data structures5.2 Security architecture of the card 5.3 APDU message str ...
- 利用.bat文件快速设置IE代理与清除IE代理
http://www.duoluodeyu.com/2009/17.html 设置IE代理.bat文件原文:将下面红色文字复制保存为.bat文件即可. 复制后将蓝色字体部分改成你要设置的代理服务器地址 ...