
虚拟机spark集群搭建
RDD弹性分布式数据集 (Resilient Distributed Dataset)
RDD只读可分区,数据集可以缓存在内存中,在多次计算间重复利用。
弹性是指内存不够时可以与磁盘进行交互
join操作就是笛卡尔积的操作过程
spark streaming
实时数据流
Discretized Streams (DStreams) 离散流
Graphx
图计算
spark sql
使用SchemaRDD来操作SQL
MLBase机器学习
MLlib算法库
Tachyon
高容错分布式文件系统
scala环境
tar -xvf scala-2.11.8.tgz

mv scala-2.11.8/ scala

#配置环境变量

export SCALA_HOME=/usr/local/scala

export PATH=$SCALA_HOME/bin:$PATH

[root@sjck-node01 ~]# scala -version

Scala code runner version 2.11.8 -- Copyright 2002-2016, LAMP/EPFL
spark环境
tar -xvf spark-2.4.0-bin-hadoop2.7.tgz

mv scala-2.11.8/ scala

export SPARK_HOME=/usr/local/spark-2.4.0-bin-hadoop2.7

export PATH=$PATH:$SPARK_HOME/bin
spark配置
cp spark-env.sh.template spark-env.sh

export JAVA_HOME=/usr/local/src/jdk/jdk1.8

export SCALA_HOME=/usr/local/scala

export HADOOP_HOME=/usr/local/hadoop

export HADOOP_CONF_DIR=/usr/local/hadoop/etc/hadoop

export SPARK_MASTER_IP=sjck-node01

export SPARK_MASTER_HOST=sjck-node01

export SPARK_LOCAL_IP=sjck-node01

export SPARK_WORKER_MEMORY=1g

export SPARK_WORKER_CORES=2

export SPARK_HOME=/usr/local/spark-2.4.0-bin-hadoop2.7

export SPARK_DIST_CLASSPATH=$(/usr/local/hadoop/bin/hadoop classpath)
slaves配置
cp slaves.template slaves

sjck-node02

sjck-node03
copy到slave节点,配置对应的环境变量
scp -r /usr/local/scala/ sjck-node02:/usr/local/

scp -r /usr/local/spark-2.4.0-bin-hadoop2.7/ sjck-node02:/usr/local/
vim spark-env.sh
把SPARK_LOCAL_IP改成对应的ip
启动顺序,先启动hadoop,再启动spark
/usr/local/hadoop/sbin/start-all.sh

/usr/local/spark-2.4.0-bin-hadoop2.7/sbin/start-all.sh

/usr/local/hadoop/sbin/stop-all.sh

/usr/local/spark-2.4.0-bin-hadoop2.7/sbin/stop-all.sh

[root@sjck-node01 ~]# /usr/local/spark-2.4.0-bin-hadoop2.7/sbin/start-all.sh

starting org.apache.spark.deploy.master.Master, logging to /usr/local/spark-2.4.0-bin-hadoop2.7/logs/spark-root-org.apache.spark.deploy.master.Master-1-sjck-node01.out

sjck-node02: starting org.apache.spark.deploy.worker.Worker, logging to /usr/local/spark-2.4.0-bin-hadoop2.7/logs/spark-root-org.apache.spark.deploy.worker.Worker-1-sjck-node02.out

sjck-node03: starting org.apache.spark.deploy.worker.Worker, logging to /usr/local/spark-2.4.0-bin-hadoop2.7/logs/spark-root-org.apache.spark.deploy.worker.Worker-1-sjck-node03.out
查看集群jps状态
[root@sjck-node01 ~]# jps

5233 Master

4595 NameNode

4788 SecondaryNameNode

5305 Jps

4942 ResourceManager

[root@sjck-node02 conf]# jps

3808 Worker

3538 DataNode

3853 Jps

3645 NodeManager

[root@sjck-node03 conf]# jps

3962 NodeManager

3851 DataNode

4173 Jps

4126 Worker
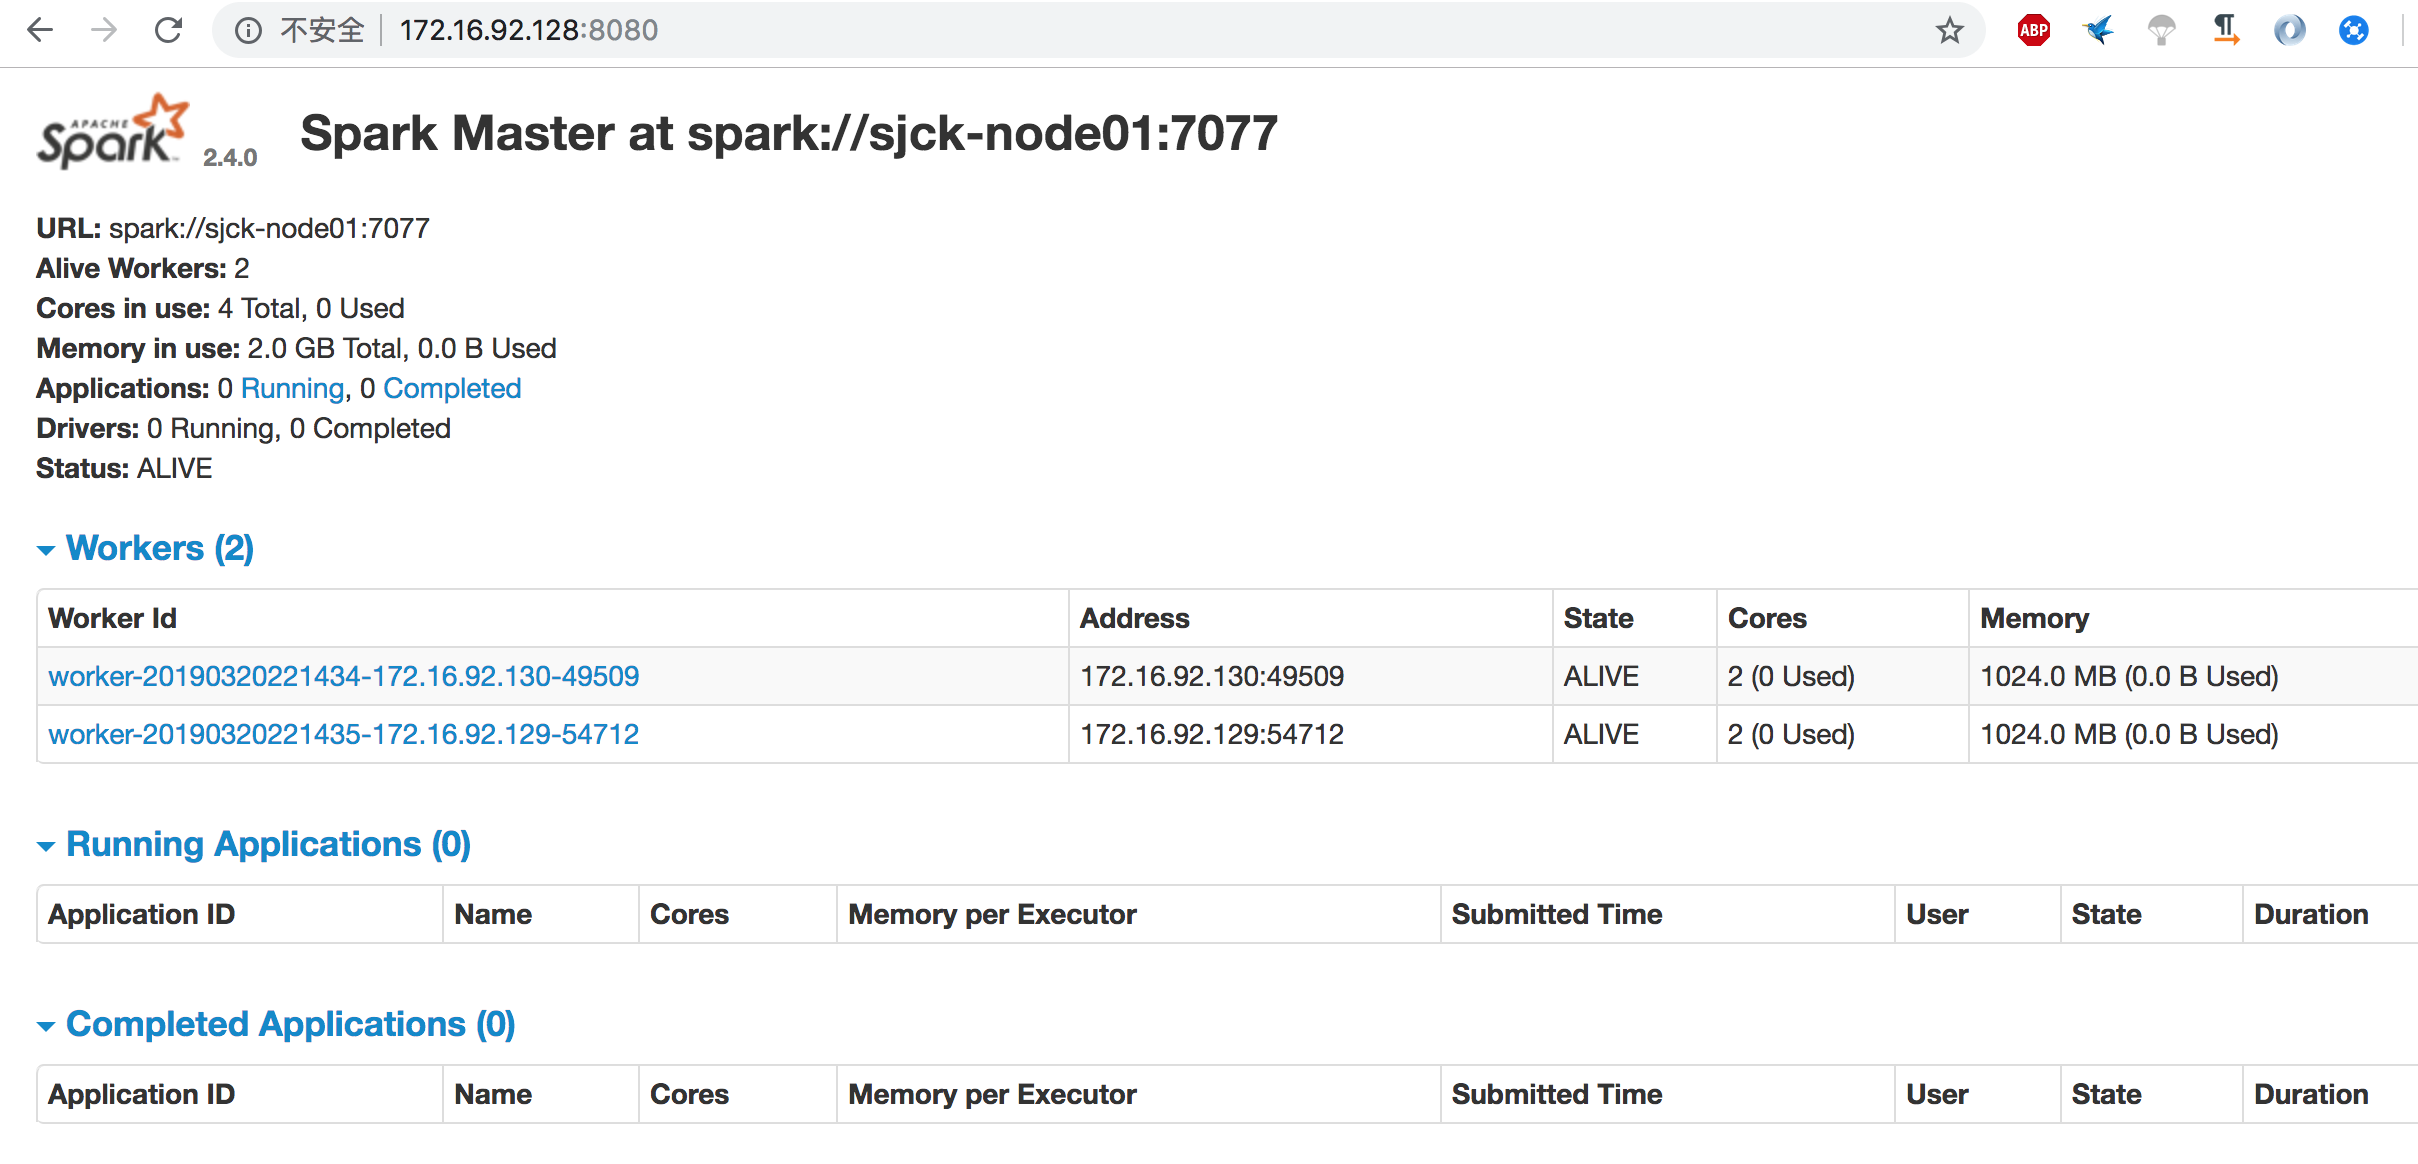
查看集群状态
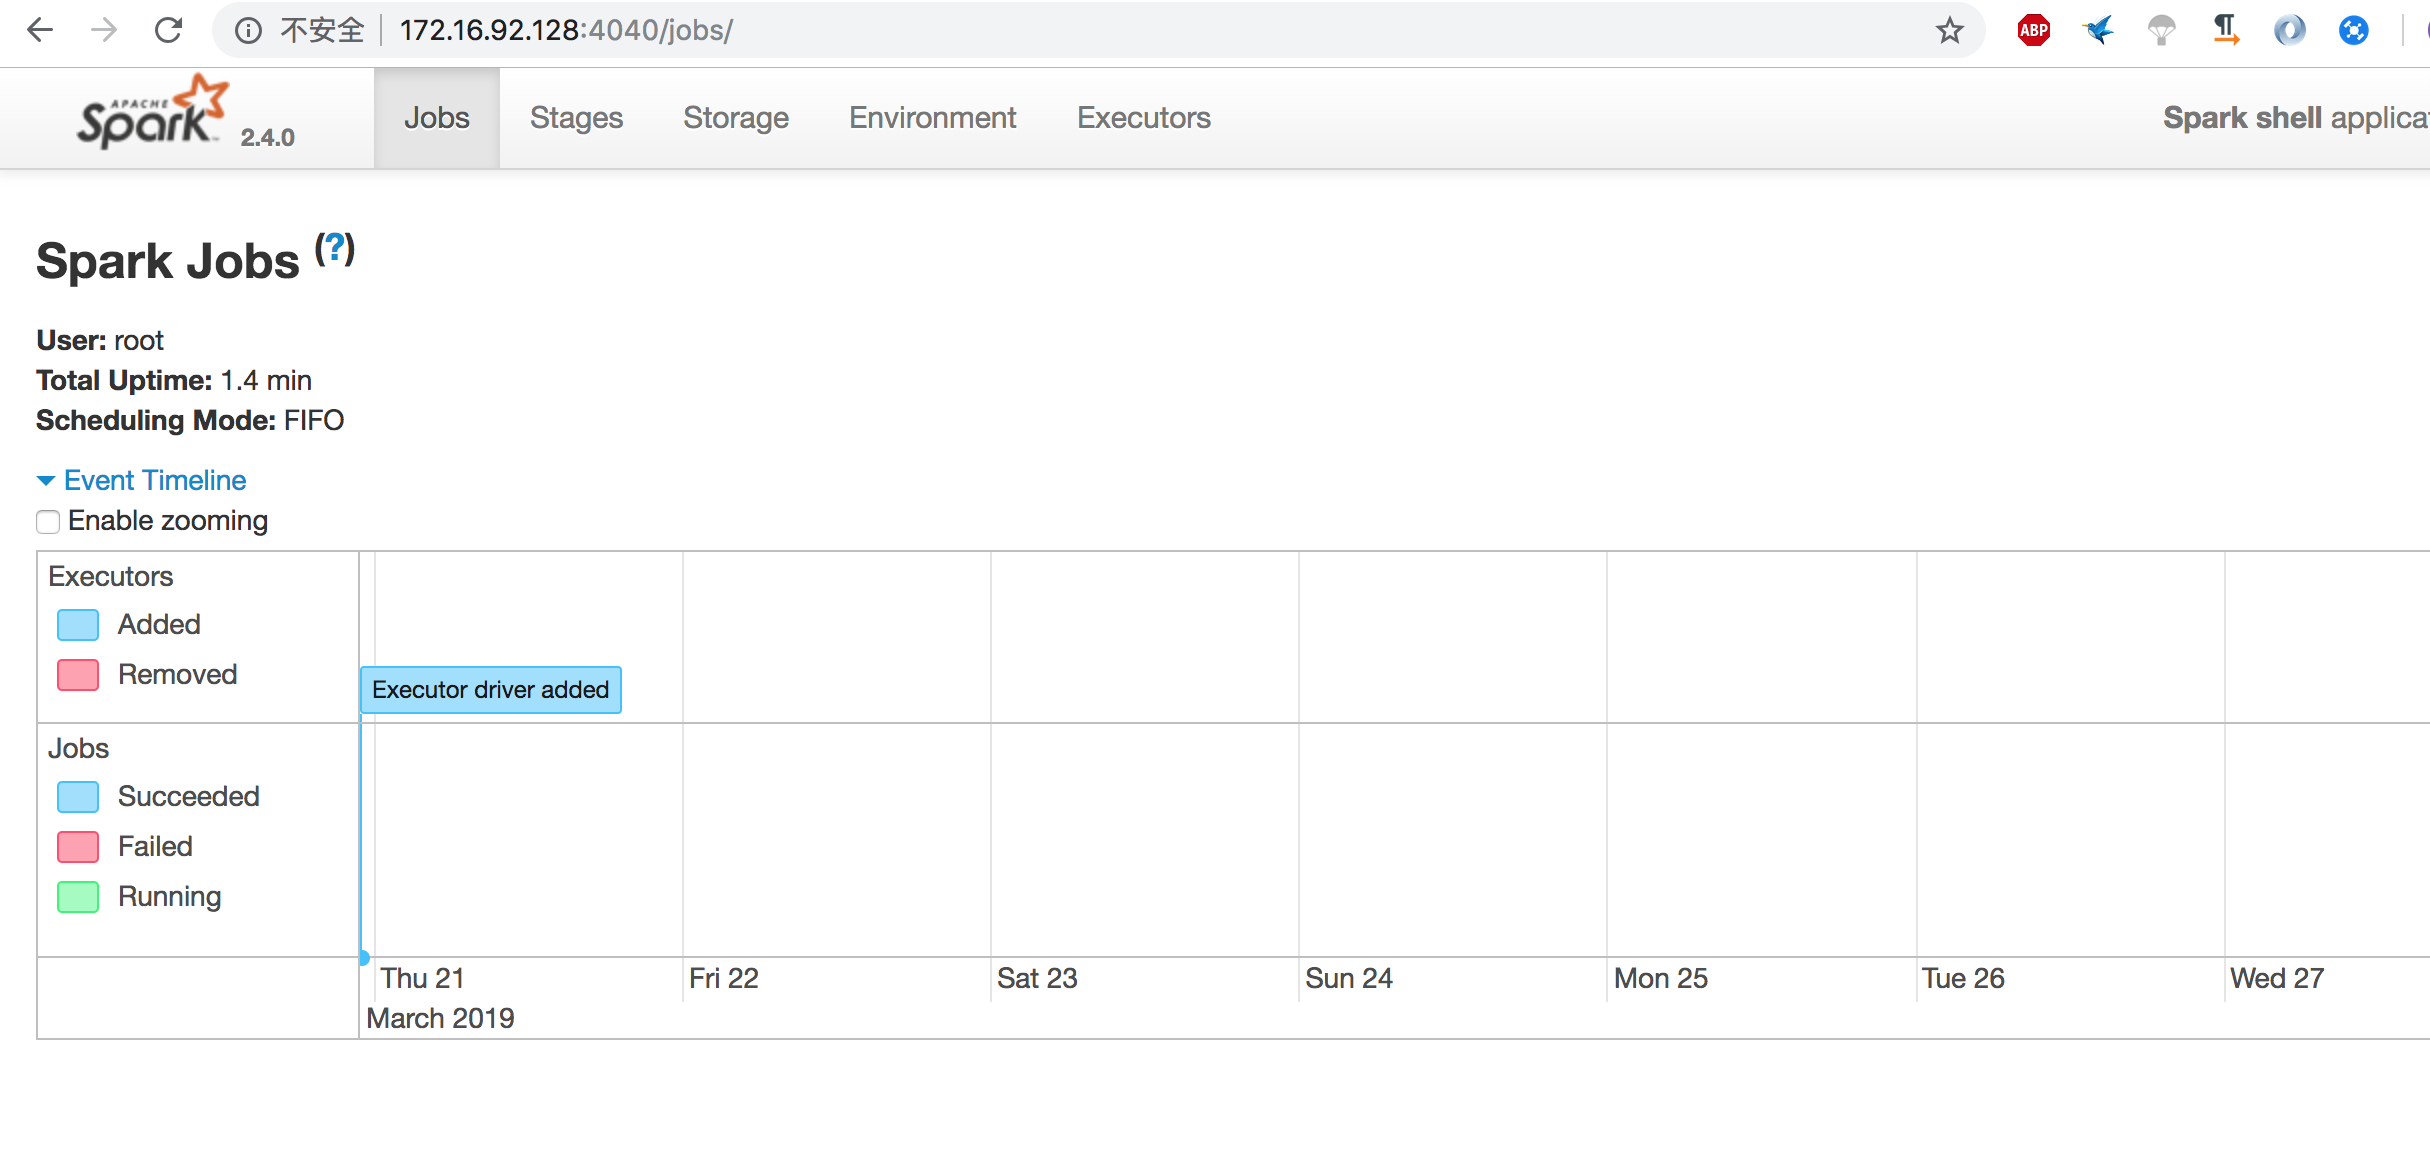
查看webui的jobs
http://172.16.92.128:4040/jobs/
pyspark,scall的是spark-shell
[root@sjck-node01 bin]# pyspark

Python 2.7.4 (default, Mar 21 2019, 00:09:49)

[GCC 4.4.7 20120313 (Red Hat 4.4.7-23)] on linux2

2019-03-21 20:53:11 WARN  NativeCodeLoader:62 - Unable to load native-hadoop library for your platform... using builtin-java classes where applicable

Setting default log level to "WARN".

Welcome to

      ____              __

     / __/__  ___ _____/ /__

    _\ \/ _ \/ _ `/ __/  '_/

   /__ / .__/\_,_/_/ /_/\_\   version 2.4.0

      /_/

Using Python version 2.7.4 (default, Mar 21 2019 00:09:49)

SparkSession available as 'spark'.

>>>
上传文件本地文件至HDFS
[root@sjck-node01 data]# hadoop fs -put /data/READ.md

[root@sjck-node01 data]# hadoop fs -ls

Found 1 items

-rw-r--r--   2 root supergroup       3952 2019-03-23 21:07 READ.md
虚拟机spark集群搭建的更多相关文章
- Spark集群搭建简配+它到底有多快?【单挑纯C/CPP/HADOOP】
最近耳闻Spark风生水起,这两天利用休息时间研究了一下,果然还是给人不少惊喜.可惜,笔者不善JAVA,只有PYTHON和SCALA接口.花了不少时间从零开始认识PYTHON和SCALA,不少时间答了 ...
- Spark集群搭建中的问题
参照<Spark实战高手之路>学习的,书籍电子版在51CTO网站 资料链接 Hadoop下载[链接](http://archive.apache.org/dist/hadoop/core/ ...
- spark集群搭建
文中的所有操作都是在之前的文章scala的安装及使用文章基础上建立的,重复操作已经简写: 配置中使用了master01.slave01.slave02.slave03: 一.虚拟机中操作(启动网卡)s ...
- hadoop+spark集群搭建入门
忽略元数据末尾 回到原数据开始处 Hadoop+spark集群搭建 说明: 本文档主要讲述hadoop+spark的集群搭建,linux环境是centos,本文档集群搭建使用两个节点作为集群环境:一个 ...
- (四)Spark集群搭建-Java&Python版Spark
Spark集群搭建 视频教程 1.优酷 2.YouTube 安装scala环境 下载地址http://www.scala-lang.org/download/ 上传scala-2.10.5.tgz到m ...
- Spark集群搭建简要
Spark集群搭建 1 Spark编译 1.1 下载源代码 git clone git://github.com/apache/spark.git -b branch-1.6 1.2 修改pom文件 ...
- Spark集群搭建_Standalone
2017年3月1日, 星期三 Spark集群搭建_Standalone Driver: node1 Worker: node2 Worker: node3 1.下载安装 下载地址 ...
- Spark集群搭建_YARN
2017年3月1日, 星期三 Spark集群搭建_YARN 前提:参考Spark集群搭建_Standalone 1.修改spark中conf中的spark-env.sh 2.Spark on ...
- Spark 集群搭建
0. 说明 Spark 集群搭建 [集群规划] 服务器主机名 ip 节点配置 s101 192.168.23.101 Master s102 192.168.23.102 Worker s103 19 ...
随机推荐
- idea注册码激活防和谐
1.到网站 http://idea.lanyus.com/ 获取注册码: 2.修改hosts文件,位于C:\Windows\System32\drivers\etc,添加一行,win10推荐使用not ...
- Linux下压缩文件-2
Linux下的压缩文件剖析 对于刚刚接触Linux的人来说,一定会给Linux下一大堆各式各样的文件名给搞晕.别个不说,单单就压缩文件为例,我们知道在Windows下最常见的压缩文件就只有两种,一是, ...
- linux 系统下IntelliJ IDEA的安装及使用
由于刚刚进入研究生阶段,通过几个月对大数据的学习,从java到hadoop,再到scala到spark.在这我写一下我在ubuntu系统下intelliJ IDEA的安装和配置.首先我的ubuntu系 ...
- 【转】 jquery easyui datagrid使用,分页、排序、查询
$('#dg').datagrid({ url: "xxx.ashx", pagination: true, p ...
- iOS学习笔记(2)— UIView用户事件响应
UIView除了负责展示内容给用户外还负责响应用户事件.本章主要介绍UIView用户交互相关的属性和方法. 1.交互相关的属性 userInteractionEnabled 默认是YES ,如果设置为 ...
- torch.nn.CrossEntropyLoss
class torch.nn.CrossEntropyLoss(weight=None, size_average=True, ignore_index=-100, reduce=True) 我这里没 ...
- LCD时序中设计到的VSPW/VBPD/VFPD/HSPW/HBPD/HFPD总结【转】
转自:https://blog.csdn.net/u011603302/article/details/50732406 下面是我在网上摘录的一些关于LCD信号所需时钟的一些介绍, 描述方式一: 来自 ...
- Apple Notification Center Service--ANCS【转】
Apple Notification Center Service 转自:http://studentdeng.github.io/blog/2014/03/22/ancs/ MAR 22ND, 20 ...
- 曹冲称象小游戏pygame实现
#!/usr/bin/env python # -*- coding: UTF-8 -*- import pygame from pygame.locals import * from sys imp ...
- Mysql_Learning_Notes_mysql系统结构_2
Mysql_Learning_Notes_mysql系统结构_2 三层体系结构,启动方式,日志类型及解析方法,mysql 升级 连接层 通信协议处理\线程处理\账号认证(用户名和密码认证)\安全检查等 ...