
PHP curl之爬虫初步
php的curl可以实现模拟http的各种请求,这也是php做网络爬虫的基础,也多用于接口api的调用。
这个时候有人就要发问了:为什么你特么不用file_get_contents?
curl的性能比它好,而且可以完成更多复杂的操作,不仅仅只是获取页面数据。
下面先分别介绍一些常用的函数。
curl_init 初始化一个curl对话
curl_exec 执行请求
curl_close 关闭一个curl对话
curl_setopt 设置curl参数,即传输选项
curl_errno 返回最后一次错误码,php已经定义了诸多错误枚举编码
curl_errror 返回一个保护当前会话最近一次错误的字符串
....
下面我先举一个例子,简单的get获取我博客首页的数据:
<?php

/**

 * test get request

 * User: freephp

 * Date: 2015/10/8

 * Time: 15:08

 */

$ch = curl_init();

// 2. 设置选项,包括URL

curl_setopt($ch, CURLOPT_URL, "http://www.cnblogs.com/freephp");

curl_setopt($ch, CURLOPT_RETURNTRANSFER, 1);

curl_setopt($ch, CURLOPT_HEADER, 0);

// 3. 执行并获取HTML文档内容

$output = curl_exec($ch);

// 4. 释放curl句柄

curl_close($ch);

print_r($output);
就可以打印出首页的html代码。
也可把内容写入某个文件存储,这不就是爬虫的第一步么?

然后我们正则匹配过滤出文章的url,我封装了一个方法:
/**

 * 从html内容中筛选链接

 *

 * @param string $web_content

 * @return array

 */

function filterUrl($web_content){

    $reg_tag_a = '/<[a|A].*?class="postTitle2".*?href=[\'\"]{0,1}([^>\'\"\ ]*).*?>/';

    $result = preg_match_all($reg_tag_a,$web_content,$match_result);

    if($result){

        return $match_result[1];

    }

}

print_r(filterUrl($output));
打印出来如图:
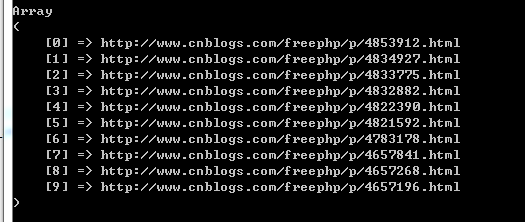
然后再遍历去请求这些url,然后拿到所有的文章内容。
(待续.....)
为了复用,我把curl请求发起,内容写入文件,过滤得到文章内容等操作封装成方法。最终的完整代码如下:
<?php

/**

 * test get request

 * User: freephp

 * Date: 2015/10/8

 * Time: 15:08

 */

/**

 * 获取网页源码

 *

 * @param $url get方式请求的url

 * @return mixed

 */

function getRquest($url)

{

    $ch = curl_init();

    curl_setopt($ch, CURLOPT_URL, $url);

    curl_setopt($ch, CURLOPT_RETURNTRANSFER, 1);

    curl_setopt($ch, CURLOPT_HEADER, 0);

    // 3. 执行并获取HTML文档内容

    $output = curl_exec($ch);

    // 4. 释放curl句柄

    curl_close($ch);

    return $output;

}

/**

 * 从html内容中筛选链接

 *

 * @param string $web_content

 * @return array

 */

function filterUrl($web_content)

{

    $reg_tag_a = '/<[a|A].*?class="postTitle2".*?href=[\'\"]{0,1}([^>\'\"\ ]*).*?>/';

    $result = preg_match_all($reg_tag_a, $web_content, $match_result);

    if ($result) {

        return $match_result[1];

    }

}

/**

 * 从html内容中筛选文章内容

 *

 * @param string $content

 * @return array

 */

function filterContent($content)

{

    $reg = '/<.*\"cnblogs_post_body\">(.*?)<\/div>/ism';

    $result = preg_match_all($reg, $content, $match_result);

    if ($result) {

        return $match_result[1];

    }

}

/**

 * 抓取文章内容写入文件。

 *

 * @param string $fileName 存储文件名

 * @param string $contents 文章内容

 */

function writeToFile($fileName, $contents)

{

    $fp = fopen($fileName, 'w');

    fwrite($fp, $contents);

    fclose($fp);

}

$output = getRquest("http://www.cnblogs.com/freephp");

$articleUrls = filterUrl($output);

if (empty($articleUrls)) {

    echo '获取文章url失败';

    die();

}

$articleNum = count($articleUrls);

echo '总共文章为:', $articleNum, "\r\n";

foreach ($articleUrls as $url) {

    echo '开始爬取url:', $url, "\r\n";

    $out = getRquest($url);

    $cont = filterContent($out);

    $filename = str_replace('.html', '', str_replace('http://www.cnblogs.com/freephp/p/', '', $url));

    writeToFile($filename . '.txt', $cont[0]);

    echo '完成爬取url:', $url, "\r\n";

}
后面还会用使用post方式等用途的curl,等到那个时候再封装成工具类吧。
PHP curl之爬虫初步的更多相关文章
- python预课04 列表,元祖,统计值计算示例,py文件转为EXE文件,爬虫初步学习
列表,元组 #list l1 = [1, 2, 3, '高弟弟'] #定义一个列表 #增 l1.append("DSB") #最后增加"DSB"的元素 #删 l ...
- python爬虫-初步认识
特此声明: 以下内容来源于博主:http://blog.csdn.net/pleasecallmewhy http://cuiq ...
- PHP之cURL(爬虫)
public static function SendDataByCurl($url,$data=array()){ //对空格进行转义 $url = str_replace(' ','+',$url ...
- curl 做爬虫 用服务器代理ip
有时候会ip会封锁,所以会用一些模拟代理ip进行抓取测试 从网上找了一下代码 function curl_string ($url,$user_agent,$proxy){ $ch = ...
- python预课05 爬虫初步学习+jieba分词+词云库+哔哩哔哩弹幕爬取示例(数据分析pandas)
结巴分词 import jieba """ pip install jieba 1.精确模式 2.全模式 3.搜索引擎模式 """ txt ...
- 爬虫抓取页面数据原理(php爬虫框架有很多 )
爬虫抓取页面数据原理(php爬虫框架有很多 ) 一.总结 1.php爬虫框架有很多,包括很多傻瓜式的软件 2.照以前写过java爬虫的例子来看,真的非常简单,就是一个获取网页数据的类或者方法(这里的话 ...
- python3爬虫初探(一)之urllib.request
---恢复内容开始--- #小白一个,在此写下自己的python爬虫初步的知识.如有错误,希望谅解并指出. #欢迎和大家交流python爬虫相关的问题 #2016/6/18 #----第一把武器--- ...
- 基于php编写的新闻类爬虫,插入WordPress数据库
这个爬虫写的比较久远,很久没有更新博客了. 1.首先思路是:通过php的curl_setopt()函数可以方便快捷的抓取网页. 2.什么样的新闻吸引人呢,当然的热点新闻了.这里选百度的搜索风云榜,获取 ...
- 转:CURL库在程序中的运用浅析
CURL库在程序中的运用浅析-nk_ysg-ChinaUnix博客 http://blog.chinaunix.net/uid-22476414-id-3286638.html 这个目录的文章转载fr ...
随机推荐
- AngulaJS实战
AngulaJS实战总结, 带你进入AngularJS世界(待续) 使用AngularJS 进行Hybrid App 开发已经有一年多时间了,这里做一个总结. 一.AngularJS 初始化加载 ...
- Android 4.4堆叠结构的变化
我们知道,activity 在 AMS 的形式是 ActivityRecord,task 在 AMS 的形式TaskRecord,流程 AMS 该管理形式 ProcessRecord. 我们先看下 4 ...
- 设计与实现的简单和经常使用的权限系统(五岁以下儿童):不维护节点的深度level,手工计算level,树形结构
以这种方式.和第三的类似介绍.所不同的是.深度未在数据库中存储节点level,添加和更改时间,护.而是,在程序中,实时去计算的. 至于后面的,依照level升序排序,再迭代全部的节点构造树,与第三篇 ...
- leetcode第23题--Swap Nodes in Pairs
Problem: Given a linked list, swap every two adjacent nodes and return its head. For example,Given 1 ...
- SQL SERVER2005 excel float导入
接到mission:将一堆excel的东西导入到SQL SERVER2005 命令很easy SELECT * INTO XLImport3 FROM OPENDATASOURCE('Microsof ...
- Objective C多态
面向对象的封装的三个基本特征是.继承和多态. 包是一组简单的数据结构和定义相关的操作在上面的其合并成一个类,继承1种亲子关系,子类能够拥有父类定的成员变量.属性以及方法. 多态就是指父类中定义的成员变 ...
- 【Web.xml配置具体解释之context-param
】
转自:http://blog.csdn.net/liaoxiaohua1981/article/details/6759206 格式定义: [html] view plaincopy <cont ...
- 18 个最新实用的 jQuery 插件
1. Simple Effects for Drop-Down Lists 一个jQuery插件用于将普通的select控件转成一个带有一些简单扩展效果的下拉列表. 2. X-editable 这个插 ...
- 利用PL/SQL Developer工具导出数据到excel,导入excel数据到表
使用PL/SQL Developer工具. 导出: 1.执行select 语句查询出需要导出的数据. 2.在数据列表中右键,选择save results.保存为.csv文件,然后已excel方式打开就 ...
- 在希望的田野上--生物柴油(Biodiesel)光明的未来
请看下图: 这是科学家Bernie Tao教授给美国Purdue大学的学生们出的题目"有关大豆.谷物产品的创新竞赛",实质上,就是鼓舞研究.开发及应用生物柴油(Biodiesel) ...