
使用XPath爬取网页数据
我们以我的博客为例,来爬取我所有写过的博客的标题。
首先,打开我的博客页面,右键“检查”开始进行网页分析。我们选中博客标题,再次右键“检查”即可找到标题相应的位置,我们继续点击右键,选择Copy,再点击Copy XPath,即可获得对应的XPath编码,我们可以先将它保存在一个文本文档中。
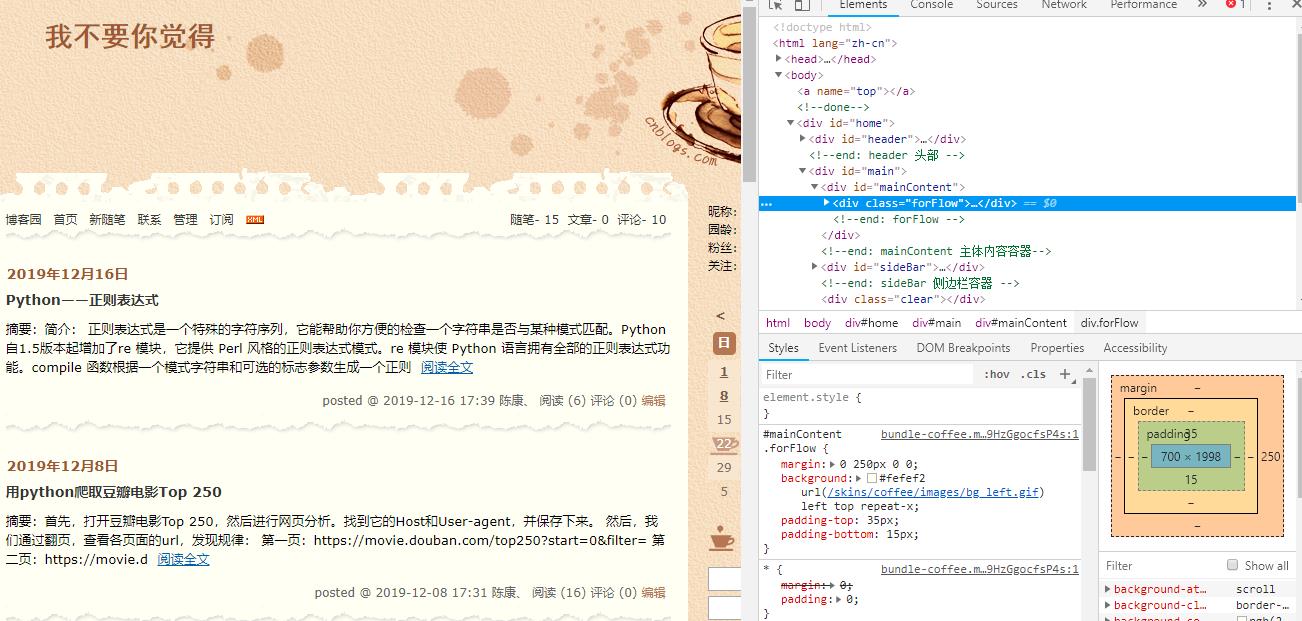
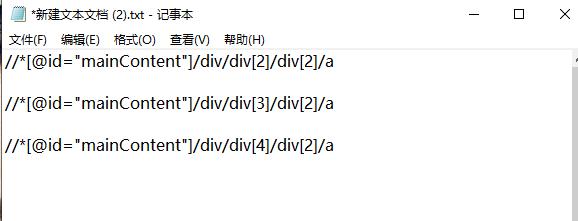
我们再多次对各个标题重复以上操作,即可得到关于标题的XPath编码的规律。我们不难看出,对于我的博客的标题的XPath编码格式为“//*[@id="mainContent"]/div/div[n]/div[2]/a”。
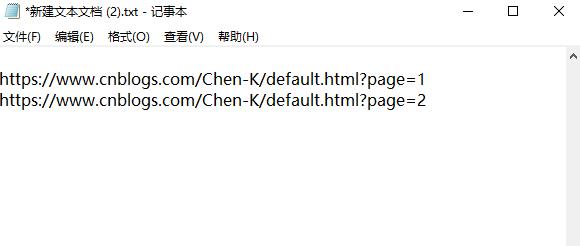
又因为我的博客共有2页,所以我们还需找到网页url的规律,经过分析,我们发现格式为'https://www.cnblogs.com/Chen-K/default.html?page='+str(i+1)。
下面便可开始写代码:
import requests

from lxml import etree

for i in range(0,2):

    url = 'https://www.cnblogs.com/Chen-K/default.html?page='+str(i+1)

    html = requests.get(url)

    etree_html = etree.HTML(html.text)

    a = etree_html.xpath('//*[@id="mainContent"]/div/div/div[2]/a/text()') # 加text()是为了将结果以txt格式输出

    for j in a:

        print(j)
运行结果:
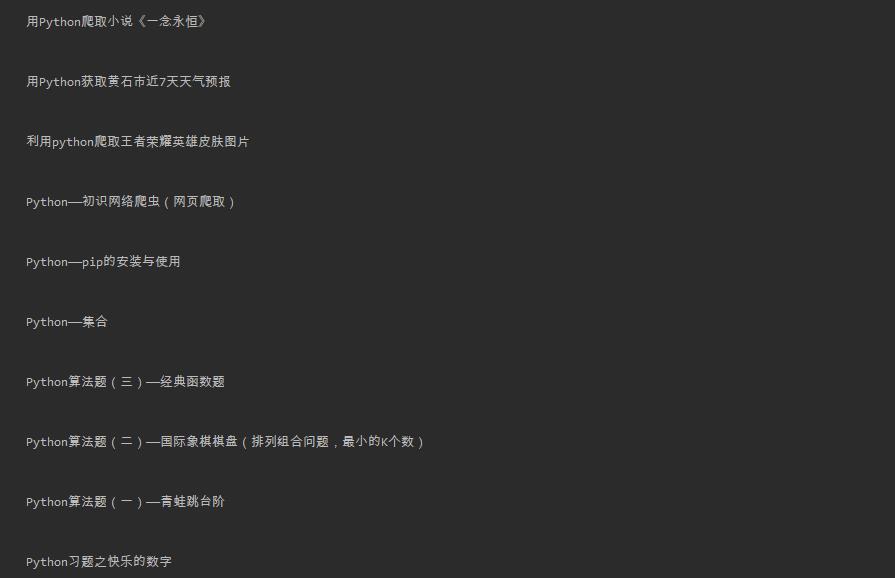
若是要爬取其他的数据,我们只需复制下来相应的XPath编码即可。操作过程大同小异,我们便不再多加赘述,下面我们以爬取每个博客的url为例:
import requests

from lxml import etree

for i in range(0,2):

    url = 'https://www.cnblogs.com/Chen-K/default.html?page='+str(i+1)

    html = requests.get(url)

    etree_html = etree.HTML(html.text)

    a = etree_html.xpath('//*[@id="mainContent"]/div/div/div[2]/a/@href')

    for j in a:

        print(j)
运行结果:
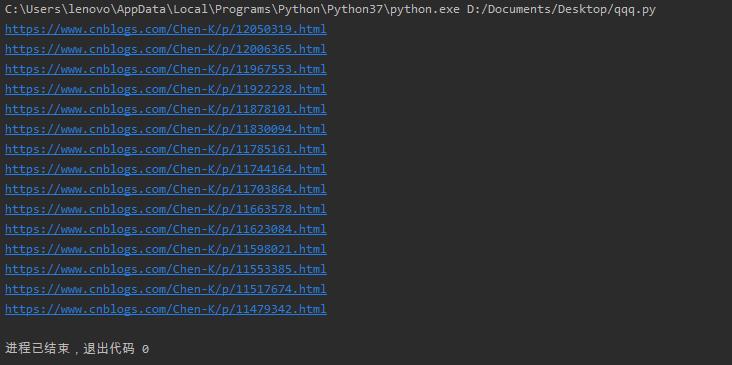
XPath与BeautifulSoup相比,操作更加简单,代码也更为简洁,如果需要爬取比较多的信息,使用XPath将会大大减少我们的工作量。当然,我们想要使用XPath,必须先安装lxml库,而我们有两个方法可以安装lxml库。
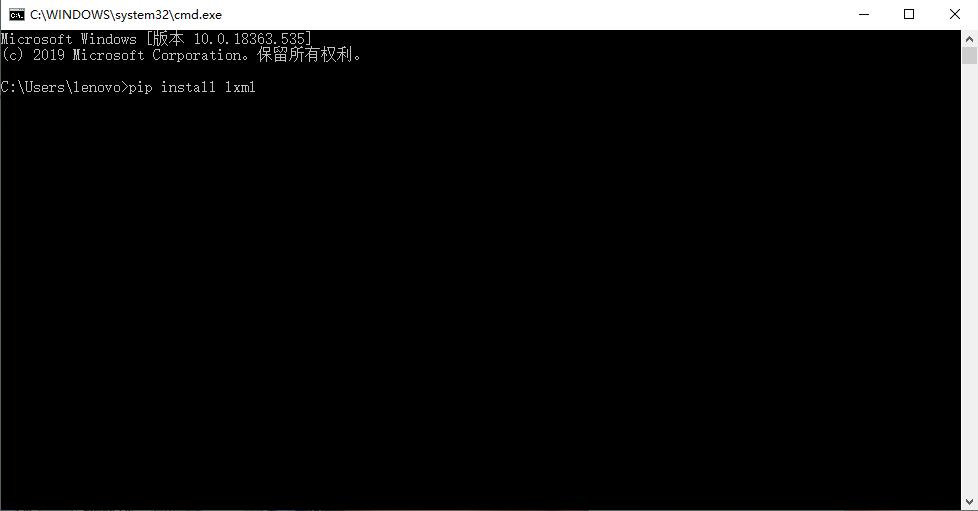
1、使用pip安装
我们只需打开命令行,输入指令“pip install lxml”,然后等待安装即可。
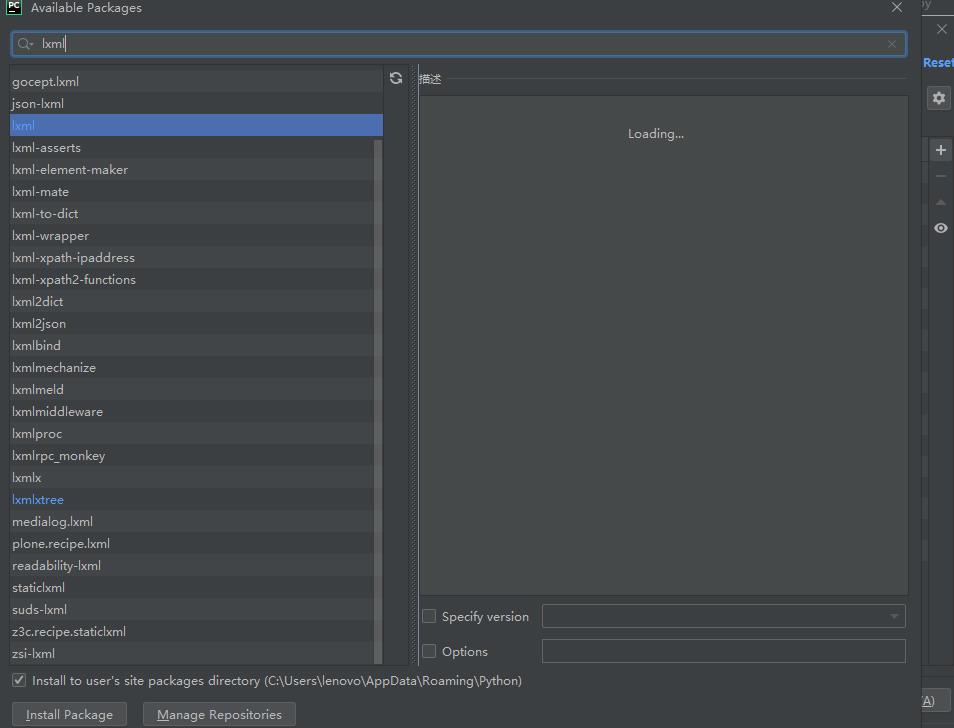
2、使用PyCharm安装
我们点击“文件”,找到设置,打开后点击右边的加号,然后在上面的搜索框中输入lxml,然后点击下方install,等待安装即可。
安装好lxml库之后,我们便可以使用其相关功能了。
使用XPath爬取网页数据的更多相关文章
- 爬虫系列4:Requests+Xpath 爬取动态数据
爬虫系列4:Requests+Xpath 爬取动态数据 [抓取]:参考前文 爬虫系列1:https://www.cnblogs.com/yizhiamumu/p/9451093.html [分页]:参 ...
- 使用webdriver+urllib爬取网页数据(模拟登陆,过验证码)
urilib是python的标准库,当我们使用Python爬取网页数据时,往往用的是urllib模块,通过调用urllib模块的urlopen(url)方法返回网页对象,并使用read()方法获得ur ...
- python之爬取网页数据总结(一)
今天尝试使用python,爬取网页数据.因为python是新安装好的,所以要正常运行爬取数据的代码需要提前安装插件.分别为requests Beautifulsoup4 lxml 三个插件 ...
- python爬虫——爬取网页数据和解析数据
1.网络爬虫的基本概念 网络爬虫(又称网络蜘蛛,机器人),就是模拟客户端发送网络请求,接收请求响应,一种按照一定的规则,自动地抓取互联网信息的程序.只要浏览器能够做的事情,原则上,爬虫都能够做到. 2 ...
- 使用 Python 爬取网页数据
1. 使用 urllib.request 获取网页 urllib 是 Python 內建的 HTTP 库, 使用 urllib 可以只需要很简单的步骤就能高效采集数据; 配合 Beautiful 等 ...
- 03:requests与BeautifulSoup结合爬取网页数据应用
1.1 爬虫相关模块命令回顾 1.requests模块 1. pip install requests 2. response = requests.get('http://www.baidu.com ...
- Selenium+Tesseract-OCR智能识别验证码爬取网页数据
1.项目需求描述 通过订单号获取某系统内订单的详细数据,不需要账号密码的登录验证,但有图片验证码的动态识别,将获取到的数据存到数据库. 2.整体思路 1.通过Selenium技术,无窗口模式打开浏览器 ...
- 【推荐】oc解析HTML数据的类库(爬取网页数据)
TFhpple是一个用于解析html数据的第三方库,本人感觉功能还算可以,只不过在使用前必须配置项目. 配置 1.导入libxml2.tbd 2.设置编译路径 使用 这里使用一个例子来说明 http: ...
- 使用puppeteer爬取网页数据实践小结
简单介绍Puppeteer Puppeteer是一个Node库,它通过DevTools协议提供高级API来控制Chrome或Chromium.Puppeteer默认以无头方式运行,但可以配置为有头方式 ...
随机推荐
- 在HTML中直接使用onclick很不专业
原因 1.onclick添加的事件处理函数是在全局环境下执行的,这污染了全局环境,很容易产生意料不到的后果: 2.给很多DOM元素添加onclick事件,可能会影响网页的性能,毕竟网页需要的事件处理函 ...
- C++ STL 排序查找最大的5个
#include <iostream>#include <algorithm>#include <deque>#include <vector>#inc ...
- train_faster_rcnn.sh
#!/bin/bash set -x set -e export PYTHONUNBUFFERED="True" GPU_ID=$1 DATASET=$2 NET=$3 array ...
- Qt编写数据可视化大屏界面电子看板11-自定义控件
一.前言 说到自定义控件,我是感觉特别熟悉的几个字,本人亲自原创的自定义控件超过110个,都是来自各个行业的具体应用真实需求,而不是凭空捏造的,当然有几个小控件也有点凑数的嫌疑,在编写整个数据可视化大 ...
- 解析Python编程中的包结构
解析Python编程中的包结构 假设你想设计一个模块集(也就是一个"包")来统一处理声音文件和声音数据.通常由它们的扩展有不同的声音格式,例如:WAV,AIFF,AU),所以你可能 ...
- 科普贴:什么是上证50ETF期权?如何交易?
这两天很多上证50ETF期权即将开通的新闻,有几个朋友表示,看了很多新闻,同样还是云里雾里,没搞清楚究竟是个什么东东?今天科普一下,部分内容摘自网络. 1.什么是ETF?ETF的英文全称是:Excha ...
- Python中bytes与字符串的相互转化
代码: # bytes转字符串方式一 b=b'\xe9\x80\x86\xe7\x81\xab' string=str(b,'utf-8') print(string) # bytes转字符串方式二 ...
- MyBatis使用技巧、总结、注意事项
目录 1.mybatis的官方文档地址 2.其他技巧: 2.1 如何在代码中拼接 like %% 2.2 数据库比较时日期的错误操作 2.2.1 异常情况: 2.2.2 为什么会在后面指定jdbcTy ...
- 如何创建spring web 工程(maven工程)
1.在项目资源管理器右键,New-Spring Starter Project 2.设置一些参数 3.点击Next,然后勾选两个选项 4.点击finish
- Python报错总结丶自定义报错
Python报错总结: 常见异常 1,NameError: name 'a' is not defined:未定义函数名 2,IndentationError: uninden ...