
python爬虫——爬取网页数据和解析数据
1.网络爬虫的基本概念
网络爬虫(又称网络蜘蛛,机器人),就是模拟客户端发送网络请求,接收请求响应,一种按照一定的规则,自动地抓取互联网信息的程序。
只要浏览器能够做的事情,原则上,爬虫都能够做到。
2.网络爬虫的功能
 图2
网络爬虫可以代替手工做很多事情,比如可以用于做搜索引擎,也可以爬取网站上面的图片,比如有些朋友将某些网站上的图片全部爬取下来,集中进行浏览,同时,网络爬虫也可以用于金融投资领域,比如可以自动爬取一些金融信息,并进行投资分析等。
有时,我们比较喜欢的新闻网站可能有几个,每次都要分别打开这些新闻网站进行浏览,比较麻烦。此时可以利用网络爬虫,将这多个新闻网站中的新闻信息爬取下来,集中进行阅读。
有时,我们在浏览网页上的信息的时候,会发现有很多广告。此时同样可以利用爬虫将对应网页上的信息爬取过来,这样就可以自动的过滤掉这些广告,方便对信息的阅读与使用。
有时,我们需要进行营销,那么如何找到目标客户以及目标客户的联系方式是一个关键问题。我们可以手动地在互联网中寻找,但是这样的效率会很低。此时,我们利用爬虫,可以设置对应的规则,自动地从互联网中采集目标用户的联系方式等数据,供我们进行营销使用。
有时,我们想对某个网站的用户信息进行分析,比如分析该网站的用户活跃度、发言数、热门文章等信息,如果我们不是网站管理员,手工统计将是一个非常庞大的工程。此时,可以利用爬虫轻松将这些数据采集到,以便进行进一步分析,而这一切爬取的操作,都是自动进行的,我们只需要编写好对应的爬虫,并设计好对应的规则即可。
除此之外,爬虫还可以实现很多强大的功能。总之,爬虫的出现,可以在一定程度上代替手工访问网页,从而,原先我们需要人工去访问互联网信息的操作,现在都可以用爬虫自动化实现,这样可以更高效率地利用好互联网中的有效信息。
3.安装第三方库
在进行爬取数据和解析数据前,需要在Python运行环境中下载安装第三方库requests。
在Windows系统中,打开cmd(命令提示符)界面,在该界面输入pip install requests,按回车键进行安装。(注意连接网络)如图3
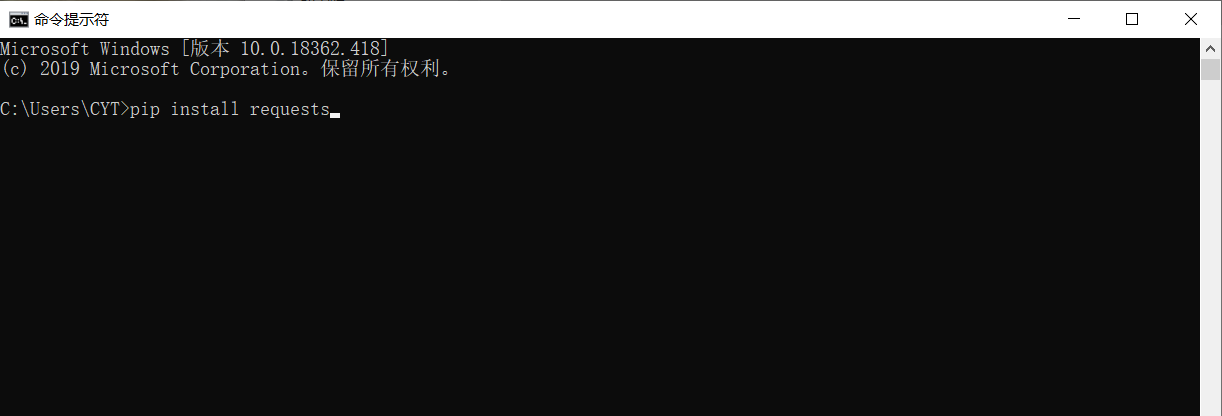
图3
安装完成,如图4
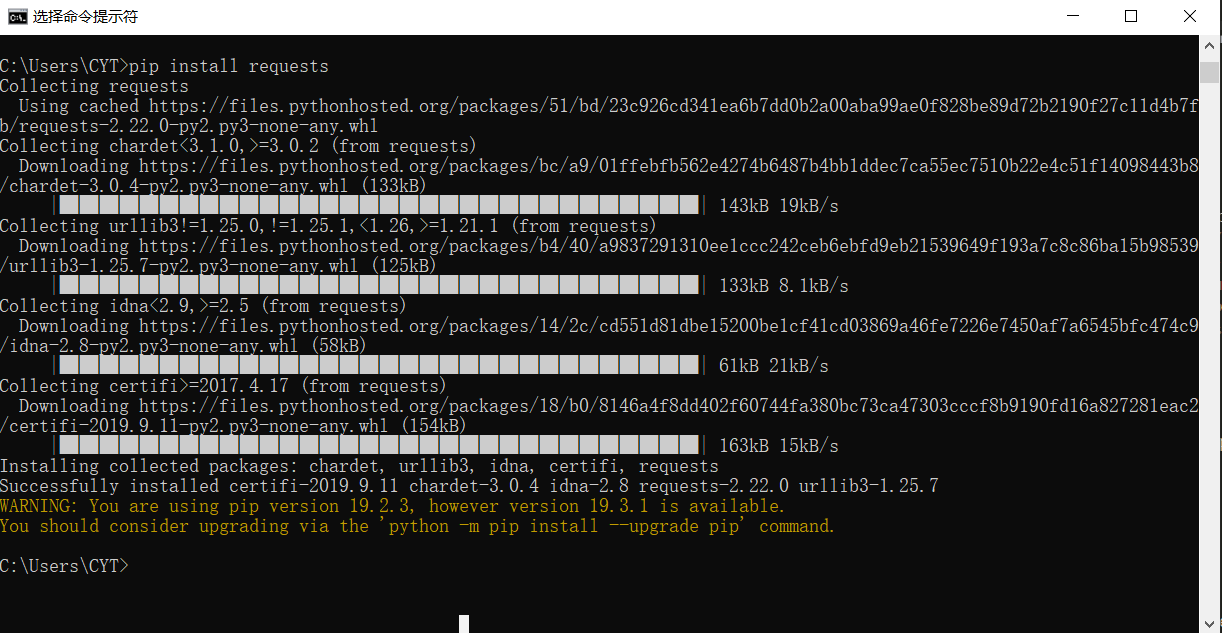
图4
4.爬取淘宝首页
 # 请求库

 import requests

 # 用于解决爬取的数据格式化

 import io

 import sys

 sys.stdout = io.TextIOWrapper(sys.stdout.buffer,encoding='utf-8')

 # 爬取的网页链接

 r= requests.get("https://www.taobao.com/")

 # 类型

 # print(type(r))

 print(r.status_code)

 # 中文显示

 # r.encoding='utf-8'

 r.encoding=None

 print(r.encoding)

 print(r.text)

 result = r.text
运行结果,如图5
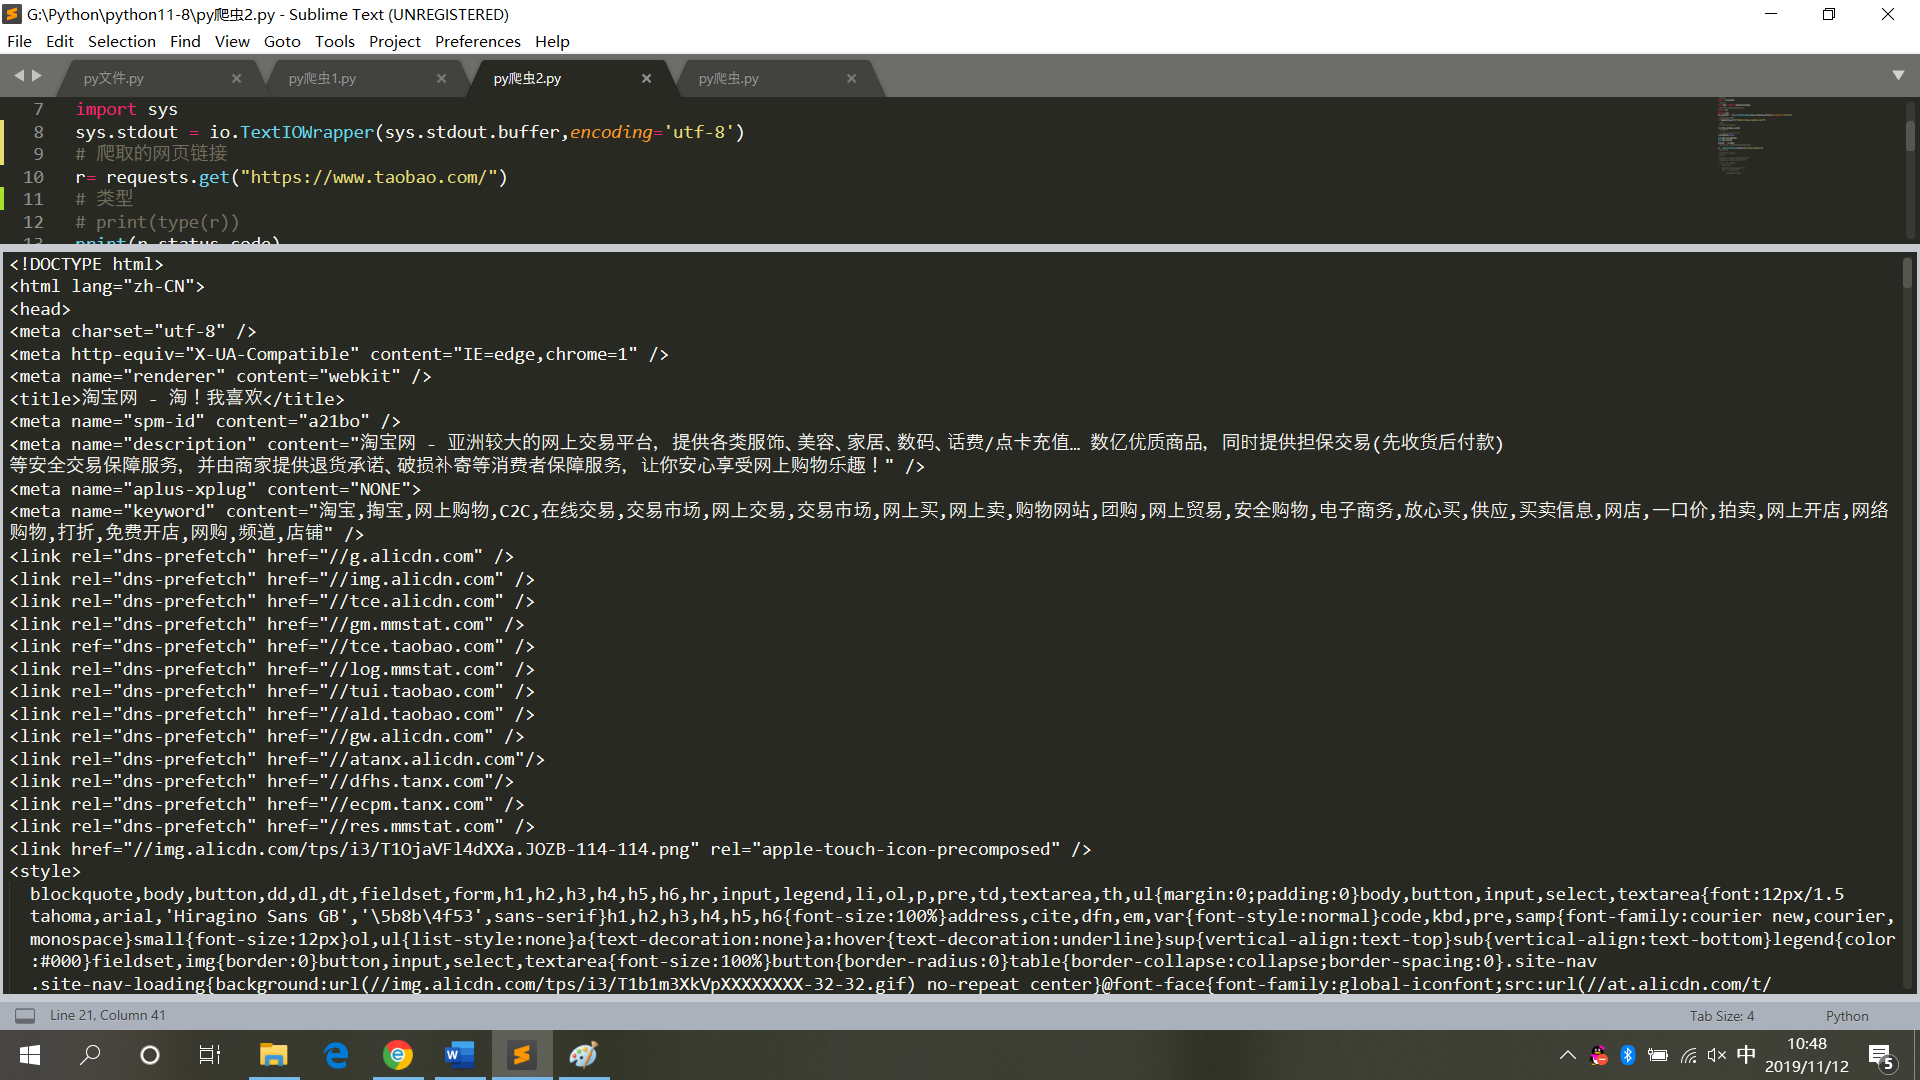
图5
5.爬取和解析淘宝网首页
 # 请求库

 import requests

 # 解析库

 from bs4 import BeautifulSoup

 # 用于解决爬取的数据格式化

 import io

 import sys

 sys.stdout = io.TextIOWrapper(sys.stdout.buffer,encoding='utf-8')

 # 爬取的网页链接

 r= requests.get("https://www.taobao.com/")

 # 类型

 # print(type(r))

 print(r.status_code)

 # 中文显示

 # r.encoding='utf-8'

 r.encoding=None

 print(r.encoding)

 print(r.text)

 result = r.text

 # 再次封装,获取具体标签内的内容

 bs = BeautifulSoup(result,'html.parser')

 # 具体标签

 print("解析后的数据")

 print(bs.span)

 a={}

 # 获取已爬取内容中的script标签内容

 data=bs.find_all('script')

 # 获取已爬取内容中的td标签内容

 data1=bs.find_all('td')

 # 循环打印输出

 for i in data:

     a=i.text

     print(i.text,end='')

     for j in data1:

         print(j.text)
运行结果,如图6
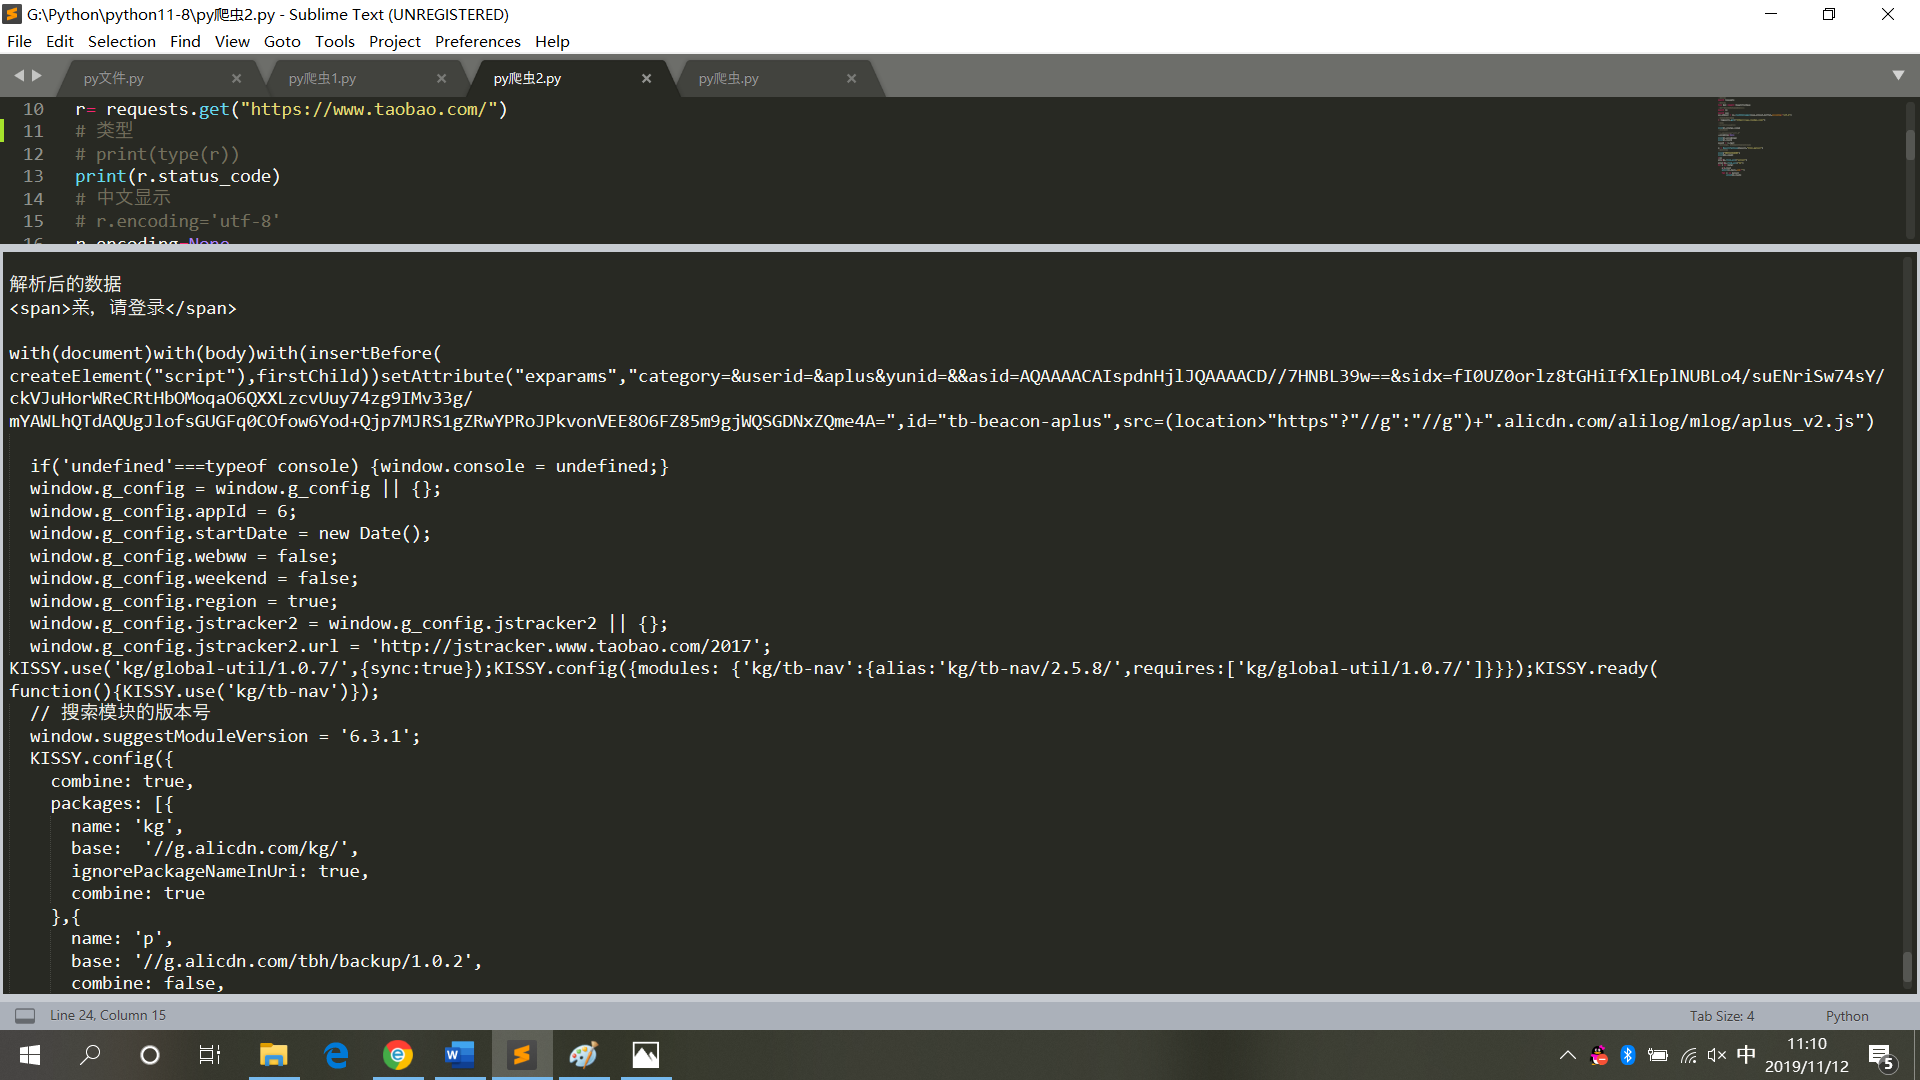
图6
7.小结
在对网页代码进行爬取操作时,不能频繁操作,更不要将其设置成死循环模式(每一次爬取则为对网页的访问,频繁操作会导致系统崩溃,会追究其法律责任)。
所以在获取网页数据后,将其保存为本地文本模式,再对其进行解析(不再需要访问网页)。
python爬虫——爬取网页数据和解析数据的更多相关文章
- python爬虫爬取get请求的页面数据代码样例
废话不多说,上代码 #!/usr/bin/env python # -*- coding:utf-8 -*- # 导包 import urllib.request import urllib.pars ...
- Python爬虫爬取异步加载的数据
前言 本文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理.作者:努力努力再努力 爬取qq音乐歌手数据接口数据 https://y.qq ...
- Python爬虫爬取网页图片
没想到python是如此强大,令人着迷,以前看见图片总是一张一张复制粘贴,现在好了,学会python就可以用程序将一张张图片,保存下来. 今天逛贴吧看见好多美图,可是图片有点多,不想一张一张地复制粘贴 ...
- 1.记我的第一次python爬虫爬取网页视频
It is my first time to public some notes on this platform, and I just want to improve myself by reco ...
- python之爬取网页数据总结(一)
今天尝试使用python,爬取网页数据.因为python是新安装好的,所以要正常运行爬取数据的代码需要提前安装插件.分别为requests Beautifulsoup4 lxml 三个插件 ...
- 使用Python爬虫爬取网络美女图片
代码地址如下:http://www.demodashi.com/demo/13500.html 准备工作 安装python3.6 略 安装requests库(用于请求静态页面) pip install ...
- python3爬虫爬取网页思路及常见问题(原创)
学习爬虫有一段时间了,对遇到的一些问题进行一下总结. 爬虫流程可大致分为:请求网页(request),获取响应(response),解析(parse),保存(save). 下面分别说下这几个过程中可以 ...
- python爬虫—爬取英文名以及正则表达式的介绍
python爬虫—爬取英文名以及正则表达式的介绍 爬取英文名: 一. 爬虫模块详细设计 (1)整体思路 对于本次爬取英文名数据的爬虫实现,我的思路是先将A-Z所有英文名的连接爬取出来,保存在一个cs ...
- 用Python爬虫爬取广州大学教务系统的成绩(内网访问)
用Python爬虫爬取广州大学教务系统的成绩(内网访问) 在进行爬取前,首先要了解: 1.什么是CSS选择器? 每一条css样式定义由两部分组成,形式如下: [code] 选择器{样式} [/code ...
随机推荐
- C#中数组、集合(ArrayList)、泛型集合List<T>、字典(dictionary<TKey,TValue>)全面对比
C#中数组.集合(ArrayList).泛型集合List<T>.字典(dictionary<TKey,TValue>)全面对比 为什么把这4个东西放在一起来说,因为c#中的这4 ...
- python基础 — 致初学者的天梯
Python简介 Python是一种计算机程序设计语言.是一种面向对象的动态类型语言,最初被设计用于编写自动化脚本(shell),随着版本的不断更新和语言新 功能的添加,越来越多被用于独立的.大型项目 ...
- JavaScript进行UTF-8编码与解码
JavaScript本身可通过charCodeAt方法得到一个字符的Unicode编码,并通过fromCharCode方法将Unicode编码转换成对应字符. 但charCodeAt方法得到的应该是一 ...
- PHP写入文件
file_put_contents('log.txt',PHP_EOL.'zhangsan'.$time.'查看了数据', FILE_APPEND);
- 解决Ubuntu 16.04 环境下Python 无法显示中文的问题
一.下载中文字体(https://pan.baidu.com/s/1EqabwENMxR2WJrHfKvyrIw 这里下载多是SImhei字体) 安装字体:解压:unzip SimHei.zip拷贝字 ...
- Java8 基础数据类型包装类-Long
https://blog.csdn.net/u012562117/article/details/79023440 基础 //final修饰不可更改,每次赋值都是新建类(其中-128~127是通过L ...
- Python接口自动化基础---token鉴权
有些登录使用cookie,有些登录需要token验证,token传参一般有两种形式,一种是在请求头中,一种是使用URL传参 这里举例说明一下请求头中的token方式: #登录 param1={'use ...
- Java开发环境搭建(二):环境变量配置
如果不配置环境变量,java 命令就只能在 bin 目录下才能使用,而且很多Java软件也需要在配置JAVA_HOME和PATH的状态下才能运行.为了在任何目录下都可以使用 java 命令.保证程序正 ...
- 【转载】 C#中List集合使用First方法查找符合条件的第一个元素
在C#的List集合相关操作中,很多时候需要从List集合中查找出符合条件的第一个元素对象,如果确认在List集合中一定存在符合条件的元素,则可以使用First方法来查找,First方法调用格式为Fi ...
- js 一些有意思的小Demo