
【机器学习】Learning to Rank之Ranking SVM 简介
Learning to Rank之Ranking SVM 简介
排序一直是信息检索的核心问题之一,Learning to Rank(简称LTR)用机器学习的思想来解决排序问题(关于Learning to Rank的简介请见我的博文Learning
to Rank简介)。LTR有三种主要的方法:PointWise,PairWise,ListWise。Ranking SVM算法是PointWise方法的一种,由R. Herbrich等人在2000提出, T. Joachims介绍了一种基于用户Clickthrough数据使用Ranking SVM来进行排序的方法(SIGKDD, 2002)。
1. Ranking SVM的主要思想
Ranking SVM是一种Pointwise的排序算法, 给定查询q, 文档d1>d2>d3(亦即文档d1比文档d2相关, 文档d2比文档d3相关, x1,
x2, x3分别是d1, d2, d3的特征)。为了使用机器学习的方法进行排序,我们将排序转化为一个分类问题。我们定义新的训练样本, 令x1-x2, x1-x3, x2-x3为正样本,令x2-x1, x3-x1,
x3-x2为负样本, 然后训练一个二分类器(支持向量机)来对这些新的训练样本进行分类,如下图所示:
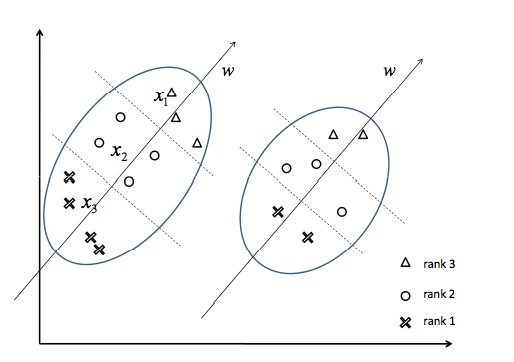
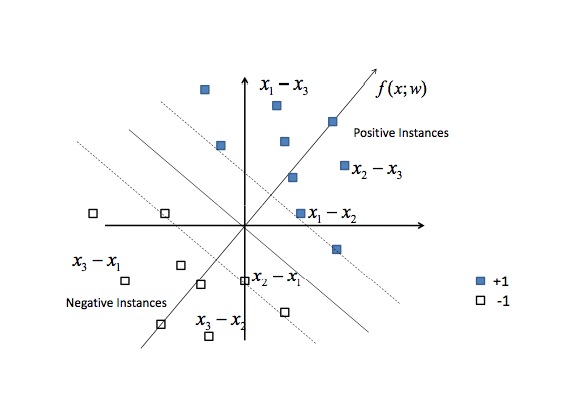
左图中每个椭圆代表一个查询, 椭圆内的点代表那些要计算和该查询的相关度的文档, 三角代表很相关, 圆圈代表一般相关, 叉号代表不相关。我们把左图中的单个的文档转换成右图中的文档对(di, dj), 实心方块代表正样本, 亦即di>dj,
空心方块代表负样本, 亦即di<dj。
2. Ranking SVM
将排序问题转化为分类问题之后, 我们就可以使用常用的机器学习方法解决该问题。 Ranking SVM使用SVM来进行分类:
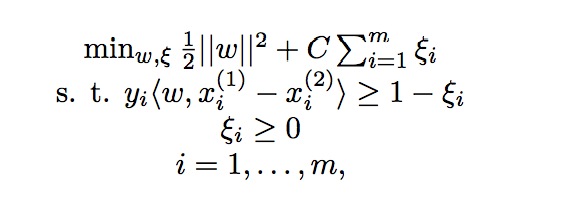
其中w为参数向量, x为文档的特征,y为文档对之间的相对相关性, ξ为松弛变量。
3. 使用Clickthrough数据作为训练数据
T. Joachims提出了一种非常巧妙的方法, 来使用Clickthrough数据作为Ranking SVM的训练数据。
假设给定一个查询"Support Vector Machine", 搜索引擎的返回结果为

其中1, 3, 7三个结果被用户点击过, 其他的则没有。因为返回的结果本身是有序的, 用户更倾向于点击排在前面的结果, 所以用户的点击行为本身是有偏(Bias)的。为了从有偏的点击数据中获得文档的相关信息, 我们认为: 如果一个用户点击了a而没有点击b, 但是b在排序结果中的位置高于a, 则a>b。
所以上面的用户点击行为意味着: 3>2, 7>2, 7>4, 7>5, 7>6。
4. Ranking SVM的开源实现
H. Joachims的主页上有Ranking
SVM的开源实现。
数据的格式与LIBSVM的输入格式比较相似, 第一列代表文档的相关性, 值越大代表越相关, 第二列代表查询, 后面的代表特征

3 qid:1 1:1 2:1 3:0 4:0.2 5:0 # 1A

2 qid:1 1:0 2:0 3:1 4:0.1 5:1 # 1B

1 qid:1 1:0 2:1 3:0 4:0.4 5:0 # 1C

1 qid:1 1:0 2:0 3:1 4:0.3 5:0 # 1D

1 qid:2 1:0 2:0 3:1 4:0.2 5:0 # 2A

2 qid:2 1:1 2:0 3:1 4:0.4 5:0 # 2B

1 qid:2 1:0 2:0 3:1 4:0.1 5:0 # 2C

1 qid:2 1:0 2:0 3:1 4:0.2 5:0 # 2D

2 qid:3 1:0 2:0 3:1 4:0.1 5:1 # 3A

3 qid:3 1:1 2:1 3:0 4:0.3 5:0 # 3B

4 qid:3 1:1 2:0 3:0 4:0.4 5:1 # 3C

1 qid:3 1:0 2:1 3:1 4:0.5 5:0 # 3D
训练模型和对测试数据进行排序的代码分别为:
./svm_rank_learn path/to/train path/to/model
./svm_classify path/to/test path/to/model path/to/rank_result
参考文献:
[1]. R. Herbrich, T. Graepel, and K. Obermayer. Large margin rank boundaries for ordinal regression. In Advances in Large Margin Classifiers, 2000.
[2]. T. Joachims. Optimizing Search Engines using Clickthrough Data. SIGKDD, 2002.
[3]. Hang Li. A Short Introduction to Learning to Rank.
[4]. Tie-yan Liu. Learning to Rank for Information Retrieval.
[5]. Learning to Rank简介
【机器学习】Learning to Rank之Ranking SVM 简介的更多相关文章
- Learning to Rank之Ranking SVM 简介
排序一直是信息检索的核心问题之一,Learning to Rank(简称LTR)用机器学习的思想来解决排序问题(关于Learning to Rank的简介请见我的博文Learning to Rank简 ...
- Kemaswill 机器学习 数据挖掘 推荐系统 Ranking SVM 简介
Ranking SVM 简介 排序一直是信息检索的核心问题之一,Learning to Rank(简称LTR)用机器学习的思想来解决排序问题(关于Learning to Rank的简介请见我的博文Le ...
- Learning to Rank之RankNet算法简介
排序一直是信息检索的核心问题之一, Learning to Rank(简称LTR)用机器学习的思想来解决排序问题(关于Learning to Rank的简介请见我的博文Learning to Rank ...
- Robust Tracking via Weakly Supervised Ranking SVM
参考文献:Yancheng Bai and Ming Tang. Robust Tracking via Weakly Supervised Ranking SVM Abstract 通常的算法:ut ...
- 【机器学习】Learning to Rank 简介
Learning to Rank 简介 去年实习时,因为项目需要,接触了一下Learning to Rank(以下简称L2R),感觉很有意思,也有很大的应用价值.L2R将机器学习的技术很好的应用到了排 ...
- [Machine Learning] Learning to rank算法简介
声明:以下内容根据潘的博客和crackcell's dustbin进行整理,尊重原著,向两位作者致谢! 1 现有的排序模型 排序(Ranking)一直是信息检索的核心研究问题,有大量的成熟的方法,主要 ...
- Learning to Rank 简介
转自:http://www.cnblogs.com/kemaswill/archive/2013/06/01/3109497.html,感谢分享! 本文将对L2R做一个比较深入的介绍,主要参考了刘铁岩 ...
- Learning to Rank简介
Learning to Rank是采用机器学习算法,通过训练模型来解决排序问题,在Information Retrieval,Natural Language Processing,Data Mini ...
- 【机器学习】Learning to Rank入门小结 + 漫谈
Learning to Rank入门小结 + 漫谈 Learning to Rank入门小结 Table of Contents 1 前言 2 LTR流程 3 训练数据的获取4 特征抽取 3.1 人工 ...
随机推荐
- Hadoop-No.6之文件在HDFS中的位置
在设计一种HDFS模式时,首先应该决定文件的位置.标准化的位置会使得团队之间更容易查找和共享数据. 推荐HDFS目录结构实例.目录结构简化了不同组和用户的权限分配 /user/{username} 只 ...
- Python-multiprocessing-Pool模块
from multiprocessing import Pool import os import time import random def long_time_task(name): print ...
- Acwing-202-最幸运的数字(同余, 欧拉定理)
链接: https://www.acwing.com/problem/content/204/ 题意: 8是中国的幸运数字,如果一个数字的每一位都由8构成则该数字被称作是幸运数字. 现在给定一个正整数 ...
- RobotFramework 截取中文中的数字比较时长
先看下需求,这个报表中有个时长,需要对昨日和前日的时长进行比较,我们获取到的元素是例如“9分43秒”这样的格式 1.首先要讲中文中的分和秒分别提取出来 提取python代码如下: import res ...
- jsp大文件传输断点续传源码
这里只写后端的代码,基本的思想就是,前端将文件分片,然后每次访问上传接口的时候,向后端传入参数:当前为第几块文件,和分片总数 下面直接贴代码吧,一些难懂的我大部分都加上注释了: 上传文件实体类: 看得 ...
- 错误/异常:org.hibernate.id.IdentifierGenerationException: ids for this class must be manually assigned before calling save() 的解决方法
1.错误/异常视图 错误/异常描述:id的生成错误,在调用save()方法之前,必须先生成id. 2.解决方法 在对应的实体类的主键(id)的get方法上加上:@GeneratedValue( ...
- CDOJ 1255 斓少摘苹果 图论 2016_5_14
斓少摘苹果 Time Limit: 3000/3000MS (Java/Others) Memory Limit: 65535/65535KB (Java/Others) Submit St ...
- 【CUDA 基础】0.0 腾讯云CUDA环境搭建
title: [CUDA 基础]0.0 腾讯云CUDA环境搭建 categories: CUDA Freshman tags: CUDA 环境搭建 toc: true date: 2018-02-13 ...
- Python基础之赋值运算符
如下图所示,假设变量a = 10, b = 20
- getFieldDecorator用法(三)——Table增删改
后台管理系统常用到表单的增删改,这里也做了个封装 例如:user/index.js import React from 'react' import { Card, Button, Table, Fo ...