
【Python】爬虫-2
8、 urllib2.urlopen可以接受一个Request对象或者url,(在接受Request对象时候,并以此可以来设置一个URL的headers),urllib.urlopen只接收一个url
9、 urllib 有urlencode,urllib2没有,这也是为什么总是urllib,urllib2常会一起使用的原因
10、 urlencode不能直接处理unicode对象,所以如果是unicode,需要先编码,有unicode转到utf8,举例:
urllib.urlencode (u'bl'.encode('utf-8'))
11、 编解码示例 urllib.quote(空格用%20代替)和urllib.urlencode(空格用+代替)都是编码,但用法不一样

8、 IV. urlretrieve() urlretrieve多数适用单纯的只下载的功能或者显示下载的进度,直接把url链接网页内容下载到retrieve_index.html里了,适用于单纯的下载的功能

8、 在对字典数据编码时候,用到的是urllib.urlencode()
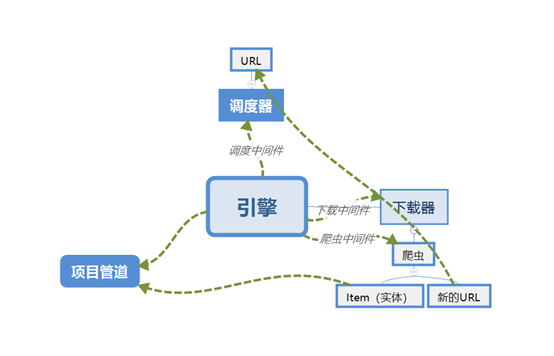
9、 Scrapy组成
(1)引擎(Scrapy Engine):用来处理整个系统的数据流处理,触发事务。
(2)调度器(Scheduler):用来接受引擎发过来的请求,压入队列中,并在引擎再次请求的时候返回。可以决定下载器下一步要下载的网址并去除重复的网址。
(3)下载器(Downloader):用来下载网页内容,并将网页内容返回给爬虫(Spiders)。
(4)爬虫(Spiders):从特定的网页中提取出需要的信息。可以用它来制定特定网页的解析规则,提取特定的实体(Item)或URL链接。每一个Spider负责一个或多个特定的网站。
(5)项目管道(Item Pipeline):负责处理爬虫从网页中抽取的实体,主要的功能是持久化实体、验证实体的有效性、清除不需要的信息。当页面被爬虫解析后,将被发送到项目管道,并经过几个特定的次序处理数据。
(6)下载器中间件(Downloader Middlewares):位于Scrapy引擎和下载器之间的子框架,主要是处理Scrapy引擎与下载器之间的请求及响应。
(7)爬虫中间件(Spider Middlewares):介于Scrapy引擎和爬虫之间的框架,主要工作是处理爬虫的响应输入和请求输出。
(8)调度中间件(Scheduler Middewares):介于Scrapy引擎和调度之间的中间件,处理从Scrapy引擎发送到调度的请求和响应。
10、 Scrapy执行流程
(1) 创建一个Scrapy项目
(2) 引擎从调度器取出一个URL用于抓取
(3) 引擎把URL封装成一个Requests请求然后传给下载器把相应结果下载下来并封装成应答包
(4) 解析应答包
(5) 定义解析规则(Item)
(6) 根据定义规则解析内容后交给实体管道等待处理
(7) 解析出URL交给调度器继续等待被抓取
【Python】爬虫-2的更多相关文章
- Python 爬虫模拟登陆知乎
在之前写过一篇使用python爬虫爬取电影天堂资源的博客,重点是如何解析页面和提高爬虫的效率.由于电影天堂上的资源获取权限是所有人都一样的,所以不需要进行登录验证操作,写完那篇文章后又花了些时间研究了 ...
- python爬虫成长之路(一):抓取证券之星的股票数据
获取数据是数据分析中必不可少的一部分,而网络爬虫是是获取数据的一个重要渠道之一.鉴于此,我拾起了Python这把利器,开启了网络爬虫之路. 本篇使用的版本为python3.5,意在抓取证券之星上当天所 ...
- python爬虫学习(7) —— 爬取你的AC代码
上一篇文章中,我们介绍了python爬虫利器--requests,并且拿HDU做了小测试. 这篇文章,我们来爬取一下自己AC的代码. 1 确定ac代码对应的页面 如下图所示,我们一般情况可以通过该顺序 ...
- python爬虫学习(6) —— 神器 Requests
Requests 是使用 Apache2 Licensed 许可证的 HTTP 库.用 Python 编写,真正的为人类着想. Python 标准库中的 urllib2 模块提供了你所需要的大多数 H ...
- 批量下载小说网站上的小说(python爬虫)
随便说点什么 因为在学python,所有自然而然的就掉进了爬虫这个坑里,好吧,主要是因为我觉得爬虫比较酷,才入坑的. 想想看,你可以批量自动的采集互联网上海量的资料数据,是多么令人激动啊! 所以我就被 ...
- python 爬虫(二)
python 爬虫 Advanced HTML Parsing 1. 通过属性查找标签:基本上在每一个网站上都有stylesheets,针对于不同的标签会有不同的css类于之向对应在我们看到的标签可能 ...
- Python 爬虫1——爬虫简述
Python除了可以用来开发Python Web之后,其实还可以用来编写一些爬虫小工具,可能还有人不知道什么是爬虫的. 一.爬虫的定义: 爬虫——网络爬虫(又被称为网页蜘蛛,网络机器人,在FOAF社区 ...
- Python爬虫入门一之综述
大家好哈,最近博主在学习Python,学习期间也遇到一些问题,获得了一些经验,在此将自己的学习系统地整理下来,如果大家有兴趣学习爬虫的话,可以将这些文章作为参考,也欢迎大家一共分享学习经验. Pyth ...
- [python]爬虫学习(一)
要学习Python爬虫,我们要学习的共有以下几点(python2): Python基础知识 Python中urllib和urllib2库的用法 Python正则表达式 Python爬虫框架Scrapy ...
- python爬虫学习(1) —— 从urllib说起
0. 前言 如果你从来没有接触过爬虫,刚开始的时候可能会有些许吃力 因为我不会从头到尾把所有知识点都说一遍,很多文章主要是记录我自己写的一些爬虫 所以建议先学习一下cuiqingcai大神的 Pyth ...
随机推荐
- Java虚拟机JVM简单理解
Java虚拟机JVM的作用: Java源文件(.java)通过编译器编译成.class文件,.class文件通过JVM中的解释器解释成特定机器上的机器代码,从而实现Java语言的跨平台. JVM的体系 ...
- Oracle11g温习-第二十章:数据装载 sql loader
2013年4月27日 星期六 10:53 1. sql loader :将外部数据(比如文本型)数据导入oracle database.(用于数据导入.不同类型数据库数据迁移) 2.sqlloade ...
- JS实现下拉单的二级联动
因工作需要,做了一个下拉单的二级联动. 第一级是固定的选项,有A.B两个选项,第二级的选项随着第一级选项的变化而变化. 一开始是这样的: HTML代码 <html> <head> ...
- 关于 EF 对象的创建问题
在开发过程中,项目往往被划分为多层,而一个请求过来往往是从表示层开始一层一层向下调用,那么如果我们在不同的层中都使用到了 EF 上下文对象,而 有好几层都这么创建一个 EF 对象然后对其进行操作,那么 ...
- Thinkphp5 Nginx Pathinfo配置
server { listen ; server_name sui.com; root /tmmee/sad.cn/public; index index.php index.html index.h ...
- 【转】vuex2.0 之 modules
vue 使用的是单一状态树对整个应用的状态进行管理,也就是说,应用中的所有状态都放到store中,如果是一个大型应用,状态非常多, store 就会非常庞大,不太好管理.这时vuex 提供了另外一种方 ...
- Struts 2 初步入门(三)
接Struts 2初步入门(二) 若想用多个通配符设定访问: <struts> <package name="default" namespace="/ ...
- Centos 7.4 源码 Nginx 安装
一.安装编译工具及库文件 yum -y install make zlib zlib-devel gcc-c++ libtool openssl openssl-devel 二.首先要安装 PCRE ...
- Jenkins的安装、启动和配置
一.Jenkins的安装 1.前提条件:已经成功安装了JDK,因为jenkins是一款基于Java的持续集成工具. 2.准备工具:下载一个jenkins的war包. 3.启动方法:如把jenkins. ...
- Win10系列:UWP界面布局进阶8
StackPanel StackPanel能够以水平或垂直的方式整齐地排列位于其内部的元素.通过设置StackPanel的Orientation属性可以定义内部元素的排列方式,当将Orientatio ...