
scrapy分布式原理
scrapy分布式原理
关于Scrapy工作流程回顾
Scrapy单机架构
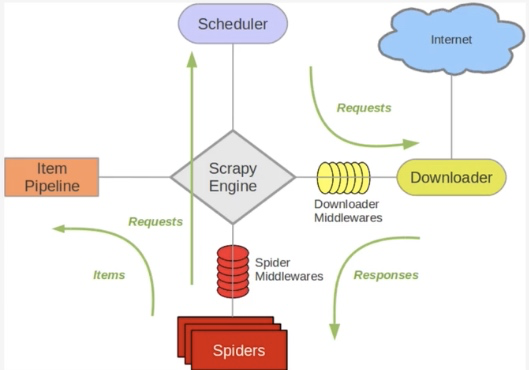
上图的架构其实就是一种单机架构,只在本机维护一个爬取队列,Scheduler进行调度,而要实现多态服务器共同爬取数据关键就是共享爬取队列。
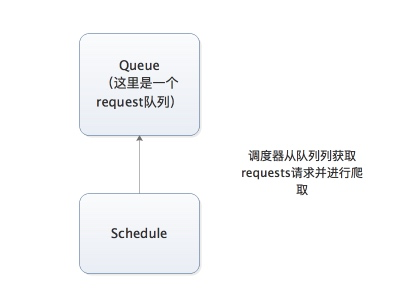
分布式架构
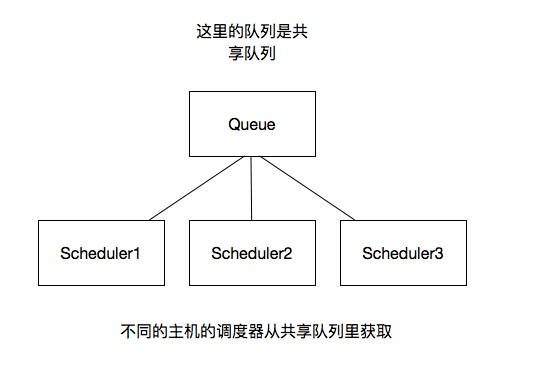
我将上图进行再次更改
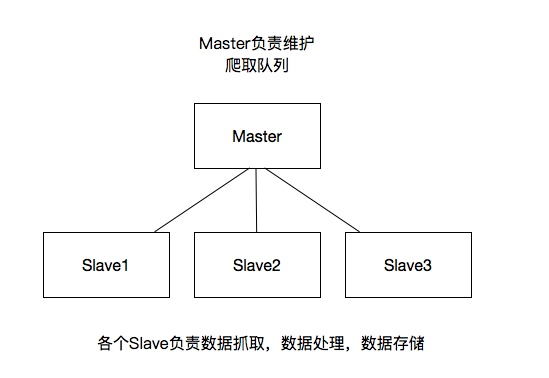
这里重要的就是我的队列通过什么维护?
这里一般我们通过Redis为维护,Redis,非关系型数据库,Key-Value形式存储,结构灵活。
并且redis是内存中的数据结构存储系统,处理速度快,提供队列集合等多种存储结构,方便队列维护
如何去重?
这里借助redis的集合,redis提供集合数据结构,在redis集合中存储每个request的指纹
在向request队列中加入Request前先验证这个Request的指纹是否已经加入集合中。如果已经存在则不添加到request队列中,如果不存在,则将request加入到队列并将指纹加入集合
如何防止中断?如果某个slave因为特殊原因宕机,如何解决?
这里是做了启动判断,在每台slave的Scrapy启动的时候都会判断当前redis request队列是否为空
如果不为空,则从队列中获取下一个request执行爬取。如果为空则重新开始爬取,第一台丛集执行爬取向队列中添加request
如何实现上述这种架构?
这里有一个scrapy-redis的库,为我们提供了上述的这些功能
scrapy-redis改写了Scrapy的调度器,队列等组件,利用他可以方便的实现Scrapy分布式架构
关于scrapy-redis的地址:https://github.com/rmax/scrapy-redis
搭建分布式爬虫
参考官网地址:https://scrapy-redis.readthedocs.io/en/stable/
前提是要安装scrapy_redis模块:pip install scrapy_redis
这里的爬虫代码是用的之前写过的爬取知乎用户信息的爬虫
修改该settings中的配置信息:
替换scrapy调度器
SCHEDULER = "scrapy_redis.scheduler.Scheduler"
添加去重的class
DUPEFILTER_CLASS = "scrapy_redis.dupefilter.RFPDupeFilter"
添加pipeline
如果添加这行配置,每次爬取的数据也都会入到redis数据库中,所以一般这里不做这个配置
ITEM_PIPELINES = {
'scrapy_redis.pipelines.RedisPipeline': 300
}
共享的爬取队列,这里用需要redis的连接信息
这里的user:pass表示用户名和密码,如果没有则为空就可以
REDIS_URL = 'redis://user:pass@hostname:9001'
设置为为True则不会清空redis里的dupefilter和requests队列
这样设置后指纹和请求队列则会一直保存在redis数据库中,默认为False,一般不进行设置
SCHEDULER_PERSIST = True
设置重启爬虫时是否清空爬取队列
这样每次重启爬虫都会清空指纹和请求队列,一般设置为False
SCHEDULER_FLUSH_ON_START=True
分布式
将上述更改后的代码拷贝的各个服务器,当然关于数据库这里可以在每个服务器上都安装数据,也可以共用一个数据,我这里方面是连接的同一个mongodb数据库,当然各个服务器上也不能忘记:
所有的服务器都要安装scrapy,scrapy_redis,pymongo
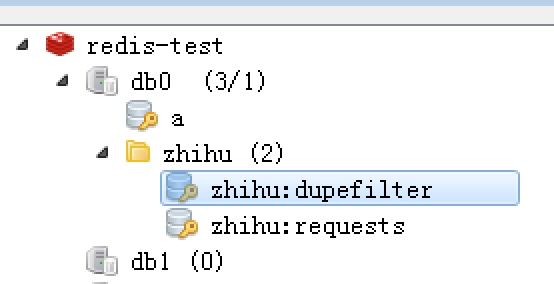
这样运行各个爬虫程序启动后,在redis数据库就可以看到如下内容,dupefilter是指纹队列,requests是请求队列
scrapy分布式原理的更多相关文章
- Python 爬虫之 Scrapy 分布式原理以及部署
Scrapy分布式原理 关于Scrapy工作流程 Scrapy单机架构 上图的架构其实就是一种单机架构,只在本机维护一个爬取队列,Scheduler进行调度,而要实现多态服务器共同爬取数据关键就是共享 ...
- Python爬虫从入门到放弃(二十)之 Scrapy分布式原理
关于Scrapy工作流程回顾 Scrapy单机架构 上图的架构其实就是一种单机架构,只在本机维护一个爬取队列,Scheduler进行调度,而要实现多态服务器共同爬取数据关键就是共享爬取队列. 分布式架 ...
- Python爬虫【五】Scrapy分布式原理笔记
Scrapy单机架构 在这里scrapy的核心是scrapy引擎,它通过里面的一个调度器来调度一个request的队列,将request发给downloader,然后来执行request请求 但是这些 ...
- 爬虫(十七):scrapy分布式原理
一:scrapy工作流程 scrapy单机架构: 单主机爬虫架构: 分布式爬虫架构: 这里重要的就是我的队列通过什么维护?这里一般我们通过Redis为维护,Redis,非关系型数据库,Key-Valu ...
- Python之爬虫(二十二) Scrapy分布式原理
关于Scrapy工作流程回顾 Scrapy单机架构 上图的架构其实就是一种单机架构,只在本机维护一个爬取队列,Scheduler进行调度,而要实现多态服务器共同爬取数据关键就是共享爬取队列. 分布式架 ...
- 第三百五十六节,Python分布式爬虫打造搜索引擎Scrapy精讲—scrapy分布式爬虫要点
第三百五十六节,Python分布式爬虫打造搜索引擎Scrapy精讲—scrapy分布式爬虫要点 1.分布式爬虫原理 2.分布式爬虫优点 3.分布式爬虫需要解决的问题
- 学习笔记TF061:分布式TensorFlow,分布式原理、最佳实践
分布式TensorFlow由高性能gRPC库底层技术支持.Martin Abadi.Ashish Agarwal.Paul Barham论文<TensorFlow:Large-Scale Mac ...
- scrapy分布式的几个重点问题
我们之前的爬虫都是在同一台机器运行的,叫做单机爬虫.scrapy的经典架构图也是描述的单机架构.那么分布式爬虫架构实际上就是:由一台主机维护所有的爬取队列,每台从机的sheduler共享该队列,协同存 ...
- scrapy分布式浅谈+京东示例
scrapy分布式浅谈+京东示例: 学习目标: 分布式概念与使用场景 浅谈去重 浅谈断点续爬 分布式爬虫编写流程 基于scrapy_redis的分布式爬虫(阳关院务与京东图书案例) 环境准备: 下载r ...
随机推荐
- 2018年东北农业大学春季校赛 D wyh的迷宫 【BFS】
题目链接 https://www.nowcoder.com/acm/contest/93/D 思路 BFS模板题 AC代码 #include <cstdio> #include <c ...
- 需要注意的一些Mysql语句
1. 日期处理函数:date_format() select COUNT(*) from (SELECT SERIAL_NO, APPLY_SERIAL_NO, FLAG, PAY_DATE, SEQ ...
- charles刷分微信跳一跳小程序对https的理解
以前以为只要安装了https 客户端与服务端的数据会被加密就安全了 事实上 只要任意一款抓包工具 并伪造证书 就可以解密这个被所谓https加密的数据 如 可以下载charles的根证书 作为伪 ...
- POJ 2309 BST(二叉搜索树)
BST Time Limit: 1000MS Memory Limit: 65536K Total Submissions: 8657 Accepted: 5277 Description C ...
- java-线程(一)
1.进程与线程的区别 多个进程的内部数据和状态都是完全独立的,而多个线程是共享一块内存空间和一组系统资源,有可能互相影响.多线程程序比多进程程序需要更少的管理费用.进程是重量级的任务,需要分配他们的单 ...
- Object.prototype.constructor
Returns a reference to the Object function that created the instance's prototype. 注意这个属性的值是函数本省的引用,而 ...
- Spring MVC 注解json 配置
1.首先在pom.xml中添加依赖jar包 <dependency> <groupId>org.codehaus.jackson</groupId> ...
- python之yield和Generator
首先我们从一个小程序导入,各定一个list,找出其中的素数,我们会这样写 import math def is_Prims(number): if number == 2: return True / ...
- MTK HDMI 流程
一.HDMI初始化 1. kernel-3.18/drivers/misc/mediatek/ext_disp/mtk_extd_mgr.c static int __init mtk_extd_mg ...
- Java使用Jacob转换Word为HTML
从今天开始,我也要养成记录开发中遇到的问题和解决方法的好习惯! 最近开发一个Android项目,需要用到查看Word和Pdf文档的功能,由于Android没有直接显示Word和PDF文档的组件,只有一 ...