
【Python图像特征的音乐序列生成】如何标记照片的特征
目前我能想到的办法是这样的:
1,提取照片中的实体特征,借用某个pre-trained model进行tag标记。
2,将特征组合起来,形成一个bag-of-word model,然后将这个向量作为输入。进入CNN。
3,手动对照片贴标签,主要是对情感进行分类(如:安静、快乐,这样可以直观调节旋律)
4,将图片本身的这个特征向量,与情感标签一起作为旋律的生成参数。
首先要做的是提取照片中的实体特征。这是一个非常庞大的工程,需要很多的预训练。但是幸运地是,我手上的Azure付费订阅,可以支撑微软的Cognitive Service平台。
https://azure.microsoft.com/zh-cn/services/cognitive-services
不得不承认今年微软的Cognitive Service在功能上又有了一些强化,增加了QnA Maker、说话人识别等一系列很实用的API,为我之后的很多idea提供了方便,而且更重要的是,微软恰巧也强化了原来的计算机视觉API,现在的计算机视觉API相比之前的已经进化了很多。以前如果我放一个面包的照片,它最多返回一个“Food”标签。而现在,它不仅返回了Result分类结果,还返回了一大堆tag,请看下面两张图片:
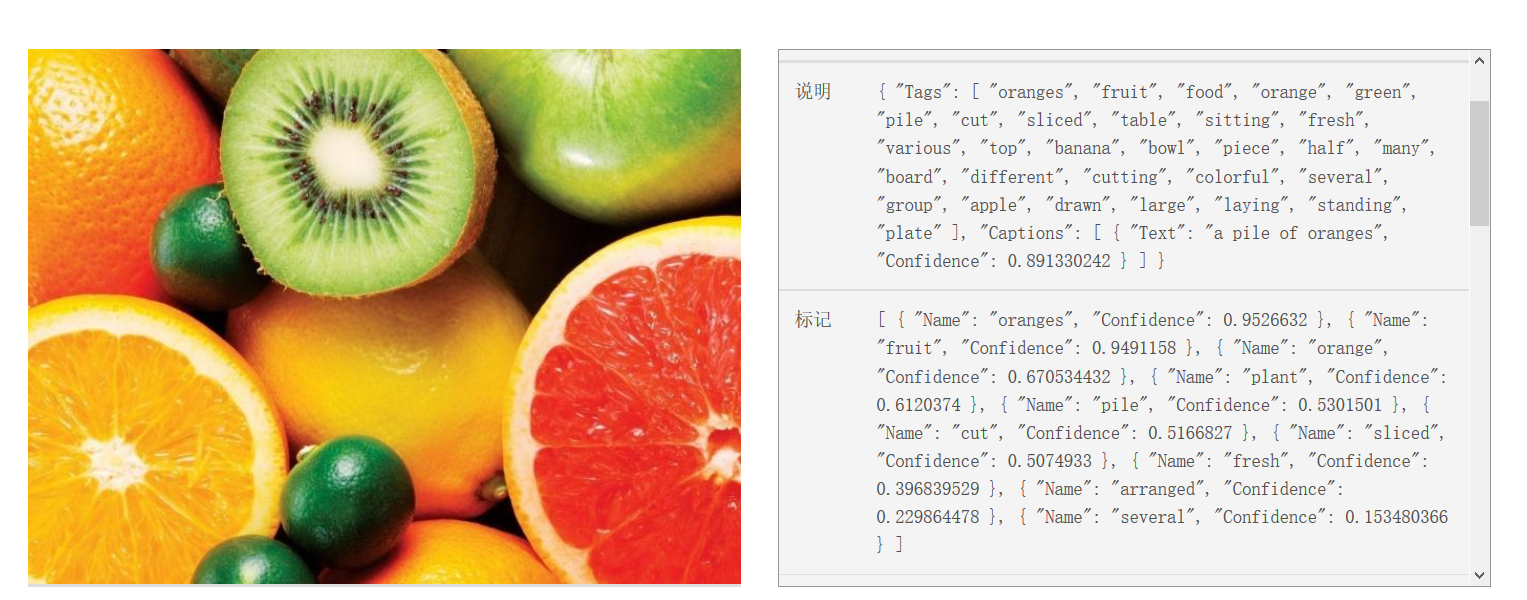

尽管最近微软缩减了各个俱乐部的经费,我还是要在这里大喊三声:
微软大法好!
微软大法好!
微软大法好!
好了,那么这个tag就处理完毕。接下来我们要处理的是bag-of-word model。这个思想很简单,想象一个向量空间,我们把所有的词汇都映射成一个向量,那么这个向量的特征和这个词的特征是挂钩的,相似的词语会很近,而相反的词语会几乎线性相关。目前将词转换为向量的成熟方案是word2vec,英文上最出名、实用的应该是C&W 2008模型,中文方面没有业界知名的模型,但是我推荐这个:
http://spaces.ac.cn/archives/4304/
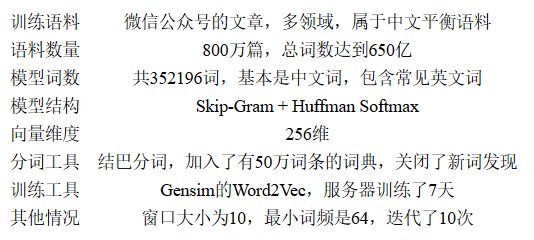
我个人觉得非常地好用。
那么我以C&W 2008模型举例,取词向量dimension = 50,那么我们将所有的向量相加(反正没有相互联系),得到一个综合向量,再作为卷积网络的输出即可。
卷积神经网络的结构我之后再继续讲述,最后讲一下怎么对图片手动贴标签。在我的设想中,这个标签应该是直观的情感标签,是一个人类看到这张图片所有的直觉反应。
所以我设想,将标签设为:生、老、病、死、爱别离、怨憎会、求不得、五阴炽盛
平静、快乐、悲伤、惊奇、厌恶、愤怒……
之后通过神经网络进行multi-labeled classification。
【Python图像特征的音乐序列生成】如何标记照片的特征的更多相关文章
- 【Python图像特征的音乐序列生成】使用Python生成简单的MIDI文件
这个全新的Python音乐创作系列,将会不定期更新.写作这个系列的初衷,是为了做一个项目<基于图像特征的音乐序列生成模型>,实时地提取照片特征,进行神经网络处理,生成一段音乐. 千里之行, ...
- 【Python图像特征的音乐序列生成】关于数据集的分享和样例数据
数据集还在制作中,样例数据如下: 我将一条数据作为一行,X是ID,O代表了情感向量,S是速度,是一个很关键的参数,K是调式,M是节拍,L是基本拍.后面是ABC格式的序列,通过embedding化这些音 ...
- 【Python图像特征的音乐序列生成】图像特征在旋律生成中有什么用
jishude 首先援引一个资料网页:http://www.cosmosshadow.com/ml/%E5%BA%94%E7%94%A8/2016/03/01/%E9%9F%B3%E4%B9%90%E ...
- 【Python图像特征的音乐序列生成】关于mingus一个bug的修复,兼改进情感模型
mingus在输出midi文件的时候,使用这样的函数: from mingus.containers import NoteContainer from mingus.midi import midi ...
- 【Python图像特征的音乐序列生成】关于音乐生成的思路转变
在前几天的讨论会上,有师兄指出原来的方法实在是很难训练,所以我改进了音乐生成的思路. 首先,我用LSTM生成的一定是一段音乐的序列化表达,那么我就可以用成型的一些数据集去训练LSTM.为了避免生成的音 ...
- 【Python图像特征的音乐序列生成】第一阶段的任务分配
从即日起到7月20号,项目成员进行了第一次任务分配. 赵同学A.岳同学.周同学,负责了图像数据的情感数据集制作,他们根据自己的经验,对图像进行了情绪提取. 赵同学B全权负责向量映射这一块的网络搭建. ...
- 【Python图像特征的音乐序列生成】关于小样本的一些思考
我之前就注意到,深度学习和音乐结合,尤其是从乐理出发进行结合(而不是纯粹的进行音乐生成),是一个尚未被深度挖掘的全新领域.可想而知,这个方向符合我要求的数据肯定是要自己搜集了. 自己搜集的数据,在量上 ...
- 【Python图像特征的音乐序列生成】思路的转变
关于生成网络这边,可能会做一个深度的受限玻尔兹曼机,这样可以保证生成的音乐不会太相似. 情绪识别网络和生成网络的耦合,中间变量可能直接就是一个one-hot向量,用来标注指定的情绪,不做成坐标那种难以 ...
- 【Python图像特征的音乐序列生成】如何生成旋律(大纲),以及整个项目的全部流程
今天连看三篇论文,不是很细致地看,也没有具体去实现,只是大概明白了一些新思路.这三篇论文,一篇概述了Decoder-Encoder模型,一篇延伸这个模型,首次提出了Attention机制,最后一篇详细 ...
随机推荐
- 从零开始Spring项目
Spring Boot是什么 SpringBoot是伴随着Spring4.0诞生的: 从字面理解,Boot是引导的意思,SpringBoot帮助开发者快速搭建Spring框架: SpringBoot帮 ...
- Golang : pflag 包简介
笔者在前文中介绍了 Golang 标准库中 flag 包的用法,事实上有一个第三方的命令行参数解析包 pflag 比 flag 包使用的更为广泛.pflag 包的设计目的就是替代标准库中的 flag ...
- __stdcall
__stdcall是函数调用约定的一种,函数调用约定主要约束了两件事: 1.参数传递顺序 2.调用堆栈由谁(调用函数或被调用函数)清理 常见的函数调用约定:stdcall cdecl fastcall ...
- solidity 学习笔记(7)内联汇编
为什么要有内联汇编? //普通循环和内敛汇编循环比较 pragma solidity ^0.4.25; contract Assembly{ function nativeLoop() public ...
- jzoj6003. 【THUWC2019模拟2019.1.16】Square (乱搞)
题面 题解 不难发现,如果一行最后被染色,那么这行的颜色肯定一样,如果倒数第二个被染色,那么除了被最后一个染色的覆盖的那一部分剩下的颜色肯定一样 于是题目可以转化为每一次删去一行或一列颜色相同的,问最 ...
- LeetCode.8-字符串转整数(String to Integer (atoi))
这是悦乐书的第349次更新,第374篇原创 01 看题和准备 今天介绍的是LeetCode算法题中Medium级别的第4题(顺位题号是8).实现将字符串转换为整数的atoi方法. 该函数首先去掉所需丢 ...
- ios 适配问题
两张图解决
- SQL SERVER Study
1. SQL SERVER Install 可以免费试用天.最新的是2014版本. 2. Attach, Detach 可以添加或去掉已有的数据库文件. 数据库文件的格式是: .md ...
- 【BZOJ2428】均分数据
题解 先说说黄学长的做法: 当温度比较高的时候,贪心 每次随机一个数,把他放进当前和最少的那一组里面 温度足够低的时候就完全随机然后转移 对于一个排列,分组强制连续 答案显然唯一,做一遍(dp)就好 ...
- Webservice入门简单实例
转载大神 项目目的: 程序A调用程序B中的方法C.. https://blog.csdn.net/lovebosom/article/details/51558139 ...