
Person Re-identification 系列论文笔记(五):SVD-net
SVDNet for Pedestrian Retrieval
Sun Y, Zheng L, Deng W, et al. SVDNet for Pedestrian Retrieval[J]. 2017.
a spotlight at ICCV 2017
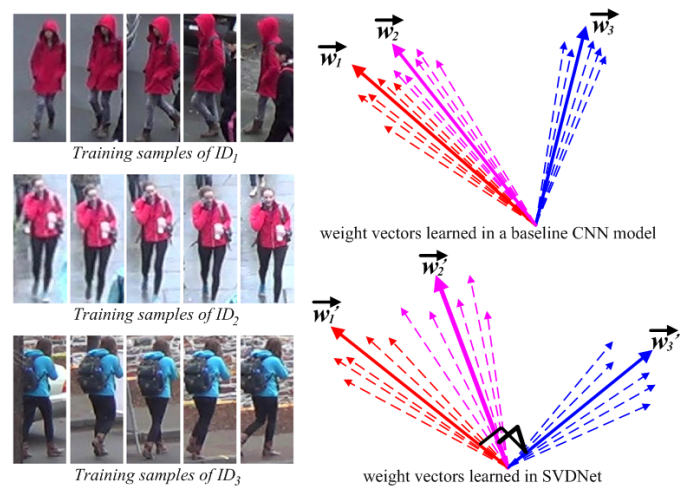
这篇的出发点是全连接层的权值相关性分析,作者认为全连接层的作用可以看做一组向量投影。当权值直接相关性较高时(可以理解为权值冗余),特征差异小,直接导致检索中距离差异小,无法获取差异化的特征。
作者提出用SVD对降维层进行操作,提高权值矩阵的正交性,从而提高检索性能。但整个算法流程中,需要人工操作的地方很多,导致整个流程非常不自然。性能不错,但实际操作起来需要过多的人工干预,倒不如将正交性做成一种正则,添加到训练中。
有兴趣的可以看看这篇论文《All You Need is Beyond a Good Init: Exploring Better Solution for Training Extremely Deep Convolutional Neural Networks with Orthonormality and Modulation》。
contributions
提出对全连接层进行SVD,让权值向量正交化从而减少冗余,提高检索性。
SVD简介
A是m*n的矩阵且rank(A)是k,A的SVD如下:
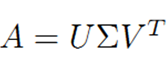
其中,U是m*m的正交阵,U的列向量称为A的左奇异向量,V是n*n的正交阵,V的列向量称为A的右奇异向量, 是m*n的对角阵,对角线上的值称为A的奇异值。
SVD物理意义
借用《数学之美》中的解释,
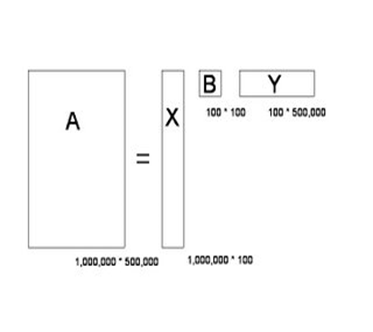
奇异值分解是把一个大矩阵,分解成三个小矩阵相乘。比如把上面的例子中的矩阵分解成一个一百万乘以一百的矩阵X,
一个一百乘以一百的矩阵B,和一个一百乘以五十万的矩阵Y。这三个矩阵的元素总数加起来也不过1.5亿,
仅仅是原来的三千分之一。相应的存储量和计算量都会小三个数量级以上。
三个矩阵物理含义:X中的每一行表示意思相关的一类词,其中的每个非零元素表示这类词中每个词的重要性(或者说相关性),数值越大越相关。
Y中的每一列表示同一主题一类文章,其中每个元素表示这类文章中每篇文章的相关性。中间的矩阵则表示类词和文章类之间的相关性。
因此,我们只要对关联矩阵A进行一次奇异值分解,w 我们就可以同时完成了近义词分类和文章的分类。(同时得到每类文章和每类词的相关性)。
SVD-net pipeline
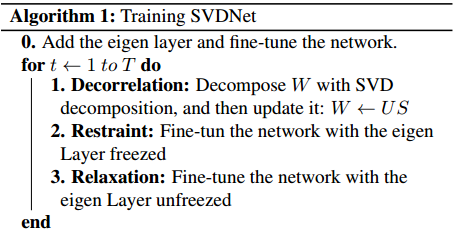
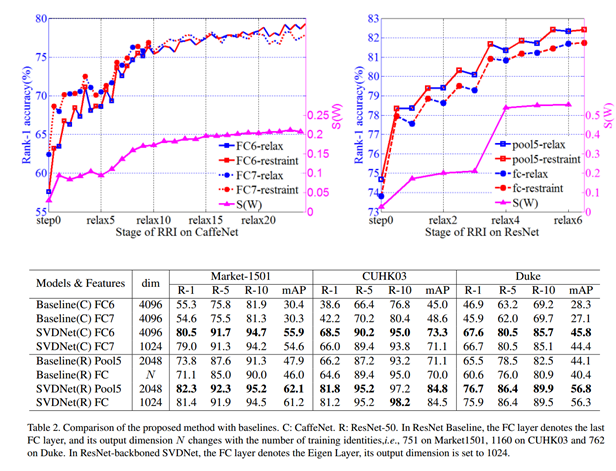
将倒数第二个FC层(如果是最后一个FC会出现不收敛,有可能是最后一层FC是由样本分布决定)进行SVD,且bias设置为0(bias会破坏正交性),测试特征用输入前的特征会更好一点(经过测试得到的结论)。

RRI训练步骤:
相关性指标S(W)

experiments
Person Re-identification 系列论文笔记(五):SVD-net的更多相关文章
- Person Re-identification 系列论文笔记(一):Scalable Person Re-identification: A Benchmark
打算整理一个关于Person Re-identification的系列论文笔记,主要记录近年CNN快速发展中的部分有亮点和借鉴意义的论文. 论文笔记流程采用contributions->algo ...
- Person Re-identification 系列论文笔记(二):A Discriminatively Learned CNN Embedding for Person Re-identification
A Discriminatively Learned CNN Embedding for Person Re-identification Zheng Z, Zheng L, Yang Y. A Di ...
- Person Re-identification 系列论文笔记(三):Improving Person Re-identification by Attribute and Identity Learning
Improving Person Re-identification by Attribute and Identity Learning Lin Y, Zheng L, Zheng Z, et al ...
- Person Re-identification 系列论文笔记(八):SPReID
Human Semantic Parsing for Person Re-identification Kalayeh M M, Basaran E, Gokmen M, et al. Human S ...
- Person Re-identification 系列论文笔记(六):AlignedReID
AlignedReID Zhang X, Luo H, Fan X, et al. AlignedReID: Surpassing Human-Level Performance in Person ...
- Person Re-identification 系列论文笔记(七):PCB+RPP
Beyond Part Models: Person Retrieval with Refined Part Pooling Sun Y, Zheng L, Yang Y, et al. Beyond ...
- Person Re-identification 系列论文笔记(四):Re-ID done right: towards good practices for person re-identification
Re-ID done right: towards good practices for person re-identification Almazan J, Gajic B, Murray N, ...
- 论文笔记系列-Neural Network Search :A Survey
论文笔记系列-Neural Network Search :A Survey 论文 笔记 NAS automl survey review reinforcement learning Bayesia ...
- 论文笔记系列-Auto-DeepLab:Hierarchical Neural Architecture Search for Semantic Image Segmentation
Pytorch实现代码:https://github.com/MenghaoGuo/AutoDeeplab 创新点 cell-level and network-level search 以往的NAS ...
随机推荐
- NOSQL数据库之 REDIS
NOSQL数据库之 REDIS 一.NOSQL 1.简介 NoSQL ,(Not Only SQL),泛指非关系型数据库. 特点: NoSQL 通常是以key-value形式存储, 不支持SQL语句, ...
- JAVA面试常见问题之进程和线程篇
1.线程和进程的概念.并行和并发的概念 进程:计算机中的程序关于某数据集合上的一次运行活动,是系统进行资源分配和调度的基本单位,是操作系统结构的基础.在早期面向进程设计的计算机结构中,进程是程序的基本 ...
- Spring.Net2.0+NHibernate4.0 +Asp.Net Mvc4 二
6.SN.Controllers 文件夹Config(Controllers.xml) 文件夹Controllers(TestController.cs) Controllers.xml <?x ...
- bzoj 1179 [Apio2009]Atm——SCC缩点+spfa
题目:https://www.lydsy.com/JudgeOnline/problem.php?id=1179 显然SCC缩点. 然后准备倒着拓扑序推到st,结果WA. 听TJ说dj求最长路会发生不 ...
- CodeChef August Lunchtime 2014 题解
A题 给一个由a和b两种类型的字符组成的字符串,每次可以从中选取任意长度的回文子序列(不一定连续)并删除.问最少需要几次能将整个字符串为空. 思路:如果本身是个回文串,那么只需要一次,否则需要两次(第 ...
- hdu 1059 Dividing(多重背包优化)
Dividing Time Limit: 2000/1000 MS (Java/Others) Memory Limit: 65536/32768 K (Java/Others)Total Su ...
- 给没有id主键的表添加id,并设置为not null 然后填充自增id
买的ip数据库,表上不带id 使用hibernate比较麻烦,所以直接改表 增加一个字段id,类型int ALTER TABLE t_ip ADD id int; 设置id不为空设置为主键,自增 AL ...
- Apache HttpComponents 工具类 [ HttpUtil ]
pom.xml <dependency> <groupId>org.apache.httpcomponents</groupId> <artifactId&g ...
- 利用InformationSchema与阿里云交易和账单管理API实现MaxCompute费用对账分摊统计
利用MaxCompute InformationSchema与阿里云交易和账单管理API 实现MaxCompute费用对账分摊统计 一.需求场景分析 很多的企业用户选择MaxCompute按量付费模式 ...
- 微信小程序-- WXML语法
页面数据 test.js test.wxml 运行结果: