
Machine Learning in Action -- Logistic regression
这个系列,重点关注如何实现,至于算法基础,参考Andrew的公开课
相较于线性回归,logistic回归更适合用于分类
因为他使用Sigmoid函数,因为分类的取值是0,1
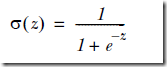
对于分类,最完美和自然的函数,当然是Heaviside step function,即0-1阶跃函数,但是这个函数中数学上有时候比较难处理
所以用Sigmoid函数来近似模拟阶跃函数,
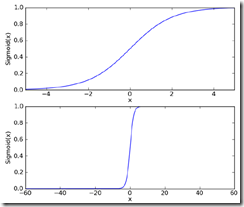
可以看到Sigmoid在增大坐标尺度后,已经比较接近于阶跃函数
其中,
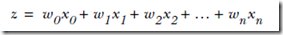
而logistic回归就是要根据训练集找到,最优的w向量
下面就通过源码来看看如何用梯度下降来解logistic问题,
def loadDataSet():

    dataMat = []; labelMat = []  #数组

    fr = open('testSet.txt')

    for line in fr.readlines():

        lineArr = line.strip().split()

        dataMat.append([1.0, float(lineArr[0]), float(lineArr[1])]) #加入一个数据点,其中‘1.0’代表截距

        labelMat.append(int(lineArr[2])) #每个数据点的lable,用于训练

    return dataMat,labelMat

def sigmoid(inX):

    return 1.0/(1+exp(-inX))

def gradAscent(dataMatIn, classLabels):

    dataMatrix = mat(dataMatIn)  #首先将array转换为matrix

    labelMat = mat(classLabels).transpose()  #将lables转秩,因为一个lable对应于dataMatrix中的一行,即一个数据点

    m,n = shape(dataMatrix)

    alpha = 0.001   #学习率

    maxCycles = 500  #迭代次数

    weights = ones((n,1))   #初始化weights向量

    for k in range(maxCycles):

        h = sigmoid(dataMatrix*weights)  #这里是矩阵计算,最终h是个列向量,表示每个数据点的预估值

        error = (labelMat - h)  #和真实值比较,算出error列向量

        weights = weights + alpha * dataMatrix.transpose()* error #这个公式是通过梯度下降推导出来的

    return weights #获得最终的weights参数
这里需要注意,numpy支持矩阵计算,所以
h = sigmoid(dataMatrix*weights), 其实是完成n×m矩阵和n×1矩阵乘,然后执行n次sigmoid,得到h列向量
至于那个公式,是由于由梯度下降求出的weight迭代公式如下,

得到weights后,进行predict很容易,直接把数据点和weights代入sigmoid函数算出h,以0.5为界近似成0或1
这种原始的梯度下降算法的问题,就是计算量比较大,对于每个weight的迭代都需要遍历数据集一遍,所以如果weight和数据集比较大,很低效
stochastic gradient ascent
对于随机梯度下降,每次只用一个数据点来迭代weights
def stocGradAscent0(dataMatrix, classLabels):

    m,n = shape(dataMatrix)

    alpha = 0.01

    weights = ones(n)

    for i in range(m):

        h = sigmoid(sum(dataMatrix[i]*weights)) #只取一个数据点

        error = classLabels[i] - h

        weights = weights + alpha * error * dataMatrix[i]

    return weights
但这个简单的随机算法有些问题,
首先只迭代训练集一遍,很可能没有达到收敛,所以准确率不够
其次,每次是依次选取数据点,所以weights会产生周期性的波动
最后,收敛速度不够
def stocGradAscent1(dataMatrix, classLabels, numIter=150):

    m,n = shape(dataMatrix)

    weights = ones(n)

    for j in range(numIter):  #增加迭代次数

        for i in range(m):

            alpha = 4/(1.0+j+i)+0.01   #动态改变学习率

            randIndex = int(random.uniform(0,len(dataIndex))) #随机选取数据点

            h = sigmoid(sum(dataMatrix[randIndex]*weights))

            error = classLabels[randIndex] - h

            weights = weights + alpha * error * dataMatrix[randIndex]

            del(dataIndex[randIndex])

    return weights
对于动态改变学习率,
可以看到,学习率会随着迭代次数变大,不断变小,但不会为0,因为有常数项,可以缓解数据波动,并保持多次迭代后仍然对数据有一定的影响
并且当i>>j时,学习略随着迭代次数增加,也不是严格下降的
而随机选取数据点,用于解决周期性波动问题
Machine Learning in Action -- Logistic regression的更多相关文章
- [Machine Learning]学习笔记-Logistic Regression
[Machine Learning]学习笔记-Logistic Regression 模型-二分类任务 Logistic regression,亦称logtic regression,翻译为" ...
- Andrew Ng Machine Learning 专题【Logistic Regression & Regularization】
此文是斯坦福大学,机器学习界 superstar - Andrew Ng 所开设的 Coursera 课程:Machine Learning 的课程笔记. 力求简洁,仅代表本人观点,不足之处希望大家探 ...
- CheeseZH: Stanford University: Machine Learning Ex3: Multiclass Logistic Regression and Neural Network Prediction
Handwritten digits recognition (0-9) Multi-class Logistic Regression 1. Vectorizing Logistic Regress ...
- 机器学习---朴素贝叶斯与逻辑回归的区别(Machine Learning Naive Bayes Logistic Regression Difference)
朴素贝叶斯与逻辑回归的区别: 朴素贝叶斯 逻辑回归 生成模型(Generative model) 判别模型(Discriminative model) 对特征x和目标y的联合分布P(x,y)建模,使用 ...
- machine learning(10) -- classification:logistic regression cost function 和 使用 gradient descent to minimize cost function
logistic regression cost function(single example) 图像分布 logistic regression cost function(m examples) ...
- Machine Learning No.3: Logistic Regression
1. Decision boundary when hθ(x) > 0, g(z) = 1; when hθ(x) < 0, g(z) = 0. so the hyppthesis is: ...
- [Machine Learning] 逻辑回归 (Logistic Regression) -分类问题-逻辑回归-正则化
在之前的问题讨论中,研究的都是连续值,即y的输出是一个连续的值.但是在分类问题中,要预测的值是离散的值,就是预测的结果是否属于某一个类.例如:判断一封电子邮件是否是垃圾邮件:判断一次金融交易是否是欺诈 ...
- 机器学习实战(Machine Learning in Action)学习笔记————05.Logistic回归
机器学习实战(Machine Learning in Action)学习笔记————05.Logistic回归 关键字:Logistic回归.python.源码解析.测试作者:米仓山下时间:2018- ...
- 《Machine Learning in Action》—— Taoye给你讲讲Logistic回归是咋回事
在手撕机器学习系列文章的上一篇,我们详细讲解了线性回归的问题,并且最后通过梯度下降算法拟合了一条直线,从而使得这条直线尽可能的切合数据样本集,已到达模型损失值最小的目的. 在本篇文章中,我们主要是手撕 ...
随机推荐
- 兼容古董级IE小结
IE6已经死亡,当然7,8,9,10也挂掉了.微软对IE11更下了狠手,对其停止了更新.以为前端就可以安安心心地写代码了.可是就是有些顽固分子,竟然用的还是IE6,尊崇客户至上的原则,就恶心着给他兼容 ...
- C++程序设计课程学习的网址
很详细 C++程序设计课程主页 http://blog.csdn.net/sxhelijian/article/details/7910565 孙鑫C++视频教程 rmvb格式 全20CD完整版 ...
- MVC的处理过程
MVC的处理过程,首先控制器接受用户的请求,并决定应该调用哪个模型来进行处理,然后模型用业务逻辑来处理用户的请求并返回数据,最后控制器用相应的视图格式化模型返回的数据,并通过表示层呈现给用户.
- 小甲鱼PE详解之基址重定位详解(PE详解10)
今天有一个朋友发短消息问我说“老师,为什么PE的格式要讲的这么这么细,这可不是一般的系哦”.其实之所以将PE结构放在解密系列继基础篇之后讲并且尽可能细致的讲,不是因为小甲鱼没事找事做,主要原因是因为P ...
- Linux常用命令_(文件搜索)
文件查找主要包含以下几个命令 which.whereis.grep.find.wc
- WireShark抓包过程
wireshark是非常流行的网络封包分析软件,功能十分强大.可以截取各种网络封包,显示网络封包的详细信息.使用wireshark的人必须了解网络协议,否则就看不懂wireshark了. 为了安全考虑 ...
- ModifyInfo.aspx.cs代码
涉及修改密码,提交请求 操作,修改数据库内容 using System; using System.Collections.Generic; using System.Linq; using Syst ...
- javascript优化--04高质量编码
库和API的设计: 在参数设计中保持好的习惯:如顺序,width,height;top,right,bottom,left;如命名: 将undefined看作没有值而不要表示非特定的值: 在允许0,空 ...
- ARP侦查工具Netdiscover
ARP侦查工具Netdiscover Netdiscover是一个主动/被动的ARP侦查工具.该工具在不使用DHCP的无线网络上非常有用.使用Netdiscover工具可以在网络上扫描IP地址,ARP ...
- Making raycast ignore multiple layers
I know how to make the raycast ignore a layer but I want it to ignore layers 9 and 10 but collide wi ...