
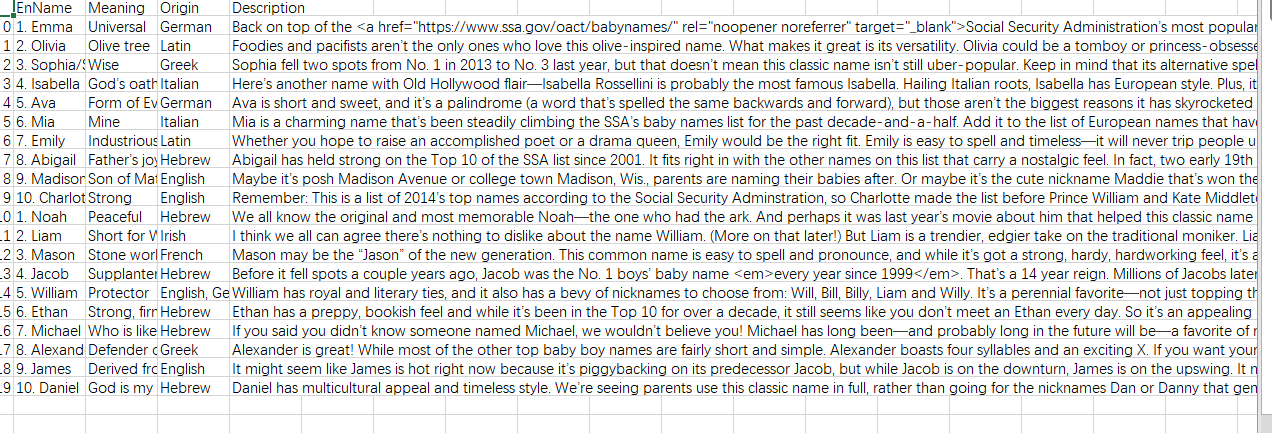
爬取https://www.parenting.com/baby-names/boys/earl网站top10男女生名字及相关信息
爬取源代码如下:
import requests

import bs4

from bs4 import BeautifulSoup

import re

import pandas as pd

import io

import sys

sys.stdout = io.TextIOWrapper(sys.stdout.buffer,encoding='gb18030')

lilist=[]

r=requests.get('https://www.parenting.com/baby-names/boys/earl')

soup=BeautifulSoup(r.text,"lxml")

soup= soup.find_all('a',href=True)

for i in soup:

    if 'https://www.parenting.com/pregnancy/baby-names/baby-boy-names/' in str(i)or'https://www.parenting.com/pregnancy/baby-names/girl-baby-names/' in str(i):

        lilist.append(i.get("href"))

lilist1=[]

results1=[]

results=[]

results2=[]

for i in list(set(lilist)):

    r=requests.get(i)

    soup=BeautifulSoup(r.text,"lxml")

    Source=soup.find_all('p')

    Source=soup.find_all(attrs={'class': 'description'})

    results0 = re.findall('<h4>(.*?)</h4>', r.text)

    for c in results0:

        if c!='':

            lilist1.append(c)

    #print(lilist1)

    #lilist1=[]

    pattern = re.compile('<p><strong>Origin:</strong>\s(.*?)</p>', re.S)

    results += re.findall(pattern, str(Source))

    pattern1 = re.compile('<p><strong>Meaning:</strong>\s(.*?)</p>', re.S)

    results1 += re.findall(pattern1, str(Source))

    pattern2 = re.compile("<p><strong>Why it’s big:</strong>\s(.*?)</p>", re.S)

    results2 += re.findall(pattern2, str(Source))

print(lilist1)

print(results1)

print(results)

print(results2)

data = {

    'EnName':lilist1,

    'Meaning':results1,

    'Origin':results,

    'Description':results2

}

frame = pd.DataFrame(data)

frame.to_csv('wt10.csv',encoding="gb18030")

#print(results2)
爬取https://www.parenting.com/baby-names/boys/earl网站top10男女生名字及相关信息的更多相关文章
- 一个爬取https和http通用的工具类(JDK自带的URL的用法)
今天在java爬取天猫的时候因为ssl报错,所以从网上找了一个可以爬取https和http通用的工具类.但是有的时候此工具类爬到的数据不全,此处不得不说python爬虫很厉害. package cn. ...
- 解决:Python爬取https站点时SNIMissingWarning和InsecurePlatformWarning
今天想利用Requests库爬取糗事百科站点,写了一个请求,却报错了: 后来参考kinsomy的博客,在cmd中pip install pyopenssl ndg-httpsclient pyasn1 ...
- 爬取https页面遇到“SSLError: hostname 'xxx' doesn't match either of”的解决方法
使用python requests 框架包访问https://itunes.apple.com 页面是遇到 SSLError: hostname 'itunes.apple.com' doesn't ...
- java爬虫爬取https协议的网站时,SSL报错, java.lang.IllegalArgumentException TSLv1.2 报错
目前在广州一家小公司实习,这里的学习环境还是挺好的,今天公司从业十几年的大佬让我检查一下几年前的爬虫程序是否还能使用…… 我从myeclipse上check out了大佬的程序,放到workspace ...
- pyspider爬取tourism management 所有文章的标题 作者 摘要 关键词等等所有你想要的信息
#!/usr/bin/env python # -*- encoding: utf-8 -*- # vim: set et sw=4 ts=4 sts=4 ff=unix fenc=utf8: # C ...
- python爬取酒店信息练习
爬取酒店信息,首先知道要用到那些库.本次使用request库区获取网页,使用bs4来解析网页,使用selenium来进行模拟浏览. 本次要爬取的美团网的蚌埠酒店信息及其评价.爬取的网址为“http:/ ...
- Python 利用 BeautifulSoup 爬取网站获取新闻流
0. 引言 介绍下 Python 用 Beautiful Soup 周期性爬取 xxx 网站获取新闻流: 图 1 项目介绍 1. 开发环境 Python: 3.6.3 BeautifulSoup: ...
- python网络爬虫之解析网页的BeautifulSoup(爬取电影图片)[三]
目录 前言 一.BeautifulSoup的基本语法 二.爬取网页图片 扩展学习 后记 前言 本章同样是解析一个网页的结构信息 在上章内容中(python网络爬虫之解析网页的正则表达式(爬取4k动漫图 ...
- 教你分分钟学会用python爬虫框架Scrapy爬取心目中的女神
本博文将带领你从入门到精通爬虫框架Scrapy,最终具备爬取任何网页的数据的能力.本文以校花网为例进行爬取,校花网:http://www.xiaohuar.com/,让你体验爬取校花的成就感. Scr ...
随机推荐
- 2019-9-20:渗透测试,基础学习,笔记,metasploit的基础使用
使用kali下metasploit生成木马,控制windows系统 kali基于debin的数字取证系统,上面集成了很多渗透测试工具,前身为bt r3(BrackTrack) Metasploit,是 ...
- JavaScript笔记七
1.函数 - 返回值,就是函数执行的结果. - 使用return 来设置函数的返回值. - 语法:return 值; - 该值就会成为函数的返回值,可以通过一个变量来接收返回值 - return后边的 ...
- 源码分析— java读写锁ReentrantReadWriteLock
前言 今天看Jraft的时候发现了很多地方都用到了读写锁,所以心血来潮想要分析以下读写锁是怎么实现的. 先上一个doc里面的例子: class CachedData { Object data; vo ...
- 《程序人生》系列-害敖丙差点被开除的P0事故
你知道的越多,你不知道的越多 点赞再看,养成习惯 GitHub https://github.com/JavaFamily上已经收录有一线大厂面试点脑图.个人联系方式和技术交流群,欢迎Star和指教 ...
- tcp协议传输方法&粘包问题
socket实现客户端和服务端 tcp协议可以用socket模块实现服务端可客户端的交互 # 服务端 import socket #生成一个socket对象 soc = socket.socket(s ...
- 【JZOJ2019.10.07】模拟赛C组
\(T1\) 题目描述&大意 贝西牛在每个点左右撞来撞去,不能出去 的情况下能活动(达到)的空间总共有多少? 思路 部分过程为: 反正就是能撞的撞 代码:
- 怎么解决js中如滑动到最底端一次操作触发多次
定义一个布尔类型到标志,处理中将起设置为true ,处理完改完false,逻辑: data{ isInProcessing:false } //逻辑函数过程中: if(isInProcessing){ ...
- Linux运维的第一周总结
这个阶段主要学习 Linux 运维技术,包括 Linux 基本操作.Bash 编程.应用服务部署.数据库服务部署.日志管理.系统监控等. 第1周: Linux基础本周学习 Linux 基本操作.用户与 ...
- 基于springboot的web项目最佳实践
springboot 可以说是现在做javaweb开发最火的技术,我在基于springboot搭建项目的过程中,踩过不少坑,发现整合框架时并非仅仅引入starter 那么简单. 要做到简单,易用,扩展 ...
- webpack4分包方案
webpack4放弃了 commonsChunkPlugin,使用更方便灵活智能的 splitChunks 来做分包的操作. 下面有几个例子,并且我们假设所有的chunks大小至少为30kb(采用sp ...