
java爬虫爬取https协议的网站时,SSL报错, java.lang.IllegalArgumentException TSLv1.2 报错
目前在广州一家小公司实习,这里的学习环境还是挺好的,今天公司从业十几年的大佬让我检查一下几年前的爬虫程序是否还能使用……
我从myeclipse上check out了大佬的程序,放到workspace中开始试探……
第一个错误出现了:握手失败,https三次握手机制是我遇到的第一个问题……
大佬似乎发现了我的问题,于是过来指导,“你先这样,再这样,就可以了”……
惊慌的我赶快点头,“嗯嗯……”
于是按照大佬的指点,首先在对应的jdk目录下添加文件……
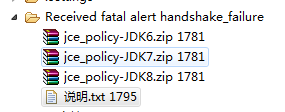

对应文件我放在百度上了,链接是:链接: https://pan.baidu.com/s/1GpKaF8zlF0ONJf3y_L7igg 提取码: nscm
大佬给我说的是:上面三个压缩包,选择对应的版本,把里面的两个文件:local_policy.jar,US_export_policy.jar覆盖掉,目录就是第一行的目录。
然后在选项:windows-preferences-java-Installed JREs中,点击你的jdk版本,点右边的edit键,在Default VM Arguments中,把调试模式打开,并添加支持的协议类型(建议大家按我这样写)……当然,具体情况需要具体分析,看报什么错。

我严格的按照大佬的要求来,发现没用,还是报错,不知道是不是我刚开始把所有的协议都写上去的原因……
但是还是要搞定这个问题啊,于是,我开始疯狂百度,终于让我找到了解决办法。
那就是,下载 bcprov-ext-jdk15on-1.52 bcprov-jdk15on-1.52 这两个jar包,给大家贡献一个下载jar包的网站:https://mvnrepository.com/ 基本上我找jar包都是在这里了……
给大家下载好了这两个文件,放到网盘上:链接: https://pan.baidu.com/s/1Sfw7wxBSySXYpeyJm52Mow 提取码: 3is7
下载好之后,我们把jar包放到 $JAVA_HOME/jre/lib/ext 目录下面,然后编辑 $JAVA_HOME/jre/lib/security/目录下的 java.security 文件……
找到security.provider.9,然后在这句话下面加上:
security.provider.10=org.bouncycastle.jce.provider.BouncyCastleProvider
之后,就重启一下myeclipse,毕竟重启能解决很多问题……
如果你严格按照我的步骤做到这里,问题基本上应该能解决了,如果还没有解决的话,那就换jdk版本试试。
需要更换项目jdk版本的话吗,请参照我的另一篇随笔…… https://www.cnblogs.com/sixgodbiao/p/10479887.html
java爬虫爬取https协议的网站时,SSL报错, java.lang.IllegalArgumentException TSLv1.2 报错的更多相关文章
- Java爬虫爬取网站电影下载链接
之前有看过一段时间爬虫,了解了爬虫的原理,以及一些实现的方法,本项目完成于半年前,一直放在那里,现在和大家分享出来. 网络爬虫简单的原理就是把程序想象成为一个小虫子,一旦进去了一个大门,这个小虫子就像 ...
- java爬虫爬取网页内容前,对网页内容的编码格式进行判断的方式
近日在做爬虫功能,爬取网页内容,然后对内容进行语义分析,最后对网页打标签,从而判断访问该网页的用户的属性. 在爬取内容时,遇到乱码问题.故需对网页内容编码格式做判断,方式大体分为三种:一.从heade ...
- 一个简单java爬虫爬取网页中邮箱并保存
此代码为一十分简单网络爬虫,仅供娱乐之用. java代码如下: package tool; import java.io.BufferedReader; import java.io.File; im ...
- java爬虫爬取的html内容中空格( )变为问号“?”的解决方法
用java编写的爬虫,使用xpath爬取内容后,发现网页源码中的 全部显示为?(问号),但是使用字符串的replace("?", ""),并不能替换,网上找了一 ...
- java爬虫爬取资源,小白必须会的入门代码块
java作为目前最火的语言之一,他的实用性也在被无数的java语言爱好者逐渐的开发,目前比较流行的爬取资源,用java来做也更简单一些,下面是爬取网页上所有手机型号,参数等极为简便的数据 packag ...
- 用Java爬虫爬取凤凰财经提供的沪深A股所有股票代号名称
要爬取的凤凰财经网址:http://app.finance.ifeng.com/list/stock.php?t=hs 本作主要采用的技术是jsoup,相关介绍网页:https://www.jians ...
- Java爬虫爬取京东商品信息
以下内容转载于<https://www.cnblogs.com/zhuangbiing/p/9194994.html>,在此仅供学习借鉴只用. Maven地址 <dependency ...
- 如何使用robots禁止各大搜索引擎爬虫爬取网站
ps:由于公司网站配置的测试环境被百度爬虫抓取,干扰了线上正常环境的使用,刚好看到每次搜索淘宝时,都会有一句由于robots.txt文件存在限制指令无法提供内容描述,于是便去学习了一波 1.原来一般来 ...
- 用scrapy爬取亚马逊网站项目
这次爬取亚马逊网站,用到了scrapy,代理池,和中间件: spiders里面: # -*- coding: utf-8 -*- import scrapy from scrapy.http.requ ...
随机推荐
- excel中如何让每n行显示同一个数据
由于需要将数据按照下表格式存储,以方便读取展示,年份列需要每隔7行再递增1 方法: 1. 输入这个公式: = INT((ROW(E1)-1)/ 5)+ 1 进入一个空白单元格,您可以在其中填写序列号, ...
- sql server还原到指定时间
BACKUP LOG yjxy_1010 TO DISK='d:\yixy_log.bak' WITH FORMAT 数据库右击->任务->还原->还原事务日志.
- c# in out ref关键字
class in_out_ref { #region in 关键字 delegate void DContravariant<in A>(A argumen); static void o ...
- zstack相关学习的博客
https://segmentfault.com/u/camile/articles?page=1
- (转)最全正则表达式总结:验证QQ号、手机号、Email、中文、邮编、身份证、IP地址等
什么是 RegExp? RegExp 是正则表达式(Regular expression)的缩写,作用是对字符串执行模式匹配. 通常用于格式验证.正则替换.查找子串等 各种编程语言的正则表达式基本相同 ...
- kolla-ansible安装openstack(Ocata)
基本功能部署 基础环境 角色 操作系统 硬件配置 Depoly CentOS 7 Server 磁盘:40GB 内存:8GB 网卡:ens3(内网) ens4(外网) Sched CentOS 7 S ...
- 虚拟化安全 sandbox 技术分析
原文链接:https://cloud.tencent.com/developer/news/215218 前言: libvirt-4.3搭配qemu-2.12使用,如果使用默认的编译选项,可能会让qe ...
- PTA——删除重复字符
PTA 7-60 删除重复字符 #include<stdio.h> #include<string.h> #define N 85 int main() { ,flag; ch ...
- PHP设计日历类一 (38)
由两个文件组成: 第一个test.php <style> table { border:1px solid #; } .fontb { color:white; background:bl ...
- “全栈2019”Java第一百零七章:匿名内部类与构造方法注意事项
难度 初级 学习时间 10分钟 适合人群 零基础 开发语言 Java 开发环境 JDK v11 IntelliJ IDEA v2018.3 文章原文链接 "全栈2019"Java第 ...