
HDFS之DataNode
DataNode工作机制
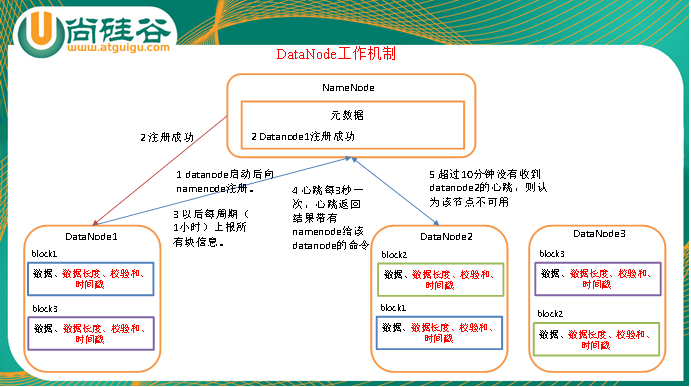
1)一个数据块在datanode上以文件形式存储在磁盘上,包括两个文件,一个是数据本身,一个是元数据包括数据块的长度,块数据的校验和,以及时间戳。
2)DataNode启动后向namenode注册,通过后,周期性(1小时)的向namenode上报所有的块信息。
3)心跳是每3秒一次,心跳返回结果带有namenode给该datanode的命令如复制块数据到另一台机器,或删除某个数据块。如果超过10分钟没有收到某个datanode的心跳,则认为该节点不可用。
4)集群运行中可以安全加入和退出一些机器
数据完整性
1)当DataNode读取block的时候,它会计算checksum
2)如果计算后的checksum,与block创建时值不一样,说明block已经损坏。
3)client读取其他DataNode上的block.
4)datanode在其文件创建后周期验证checksum
掉线时限参数设置
datanode进程死亡或者网络故障造成datanode无法与namenode通信,namenode不会立即把该节点判定为死亡,要经过一段时间,这段时间暂称作超时时长。HDFS默认的超时时长为10分钟+30秒。如果定义超时时间为timeout,则超时时长的计算公式为:
timeout = 2 * dfs.namenode.heartbeat.recheck-interval + 10 * dfs.heartbeat.interval。
而默认的dfs.namenode.heartbeat.recheck-interval 大小为5分钟,dfs.heartbeat.interval默认为3秒。
需要注意的是hdfs-site.xml 配置文件中的heartbeat.recheck.interval的单位为毫秒,dfs.heartbeat.interval的单位为秒。
|
<property> <name>dfs.namenode.heartbeat.recheck-interval</name> <value>300000</value> </property> <property> <name> dfs.heartbeat.interval </name> <value>3</value> </property> |
服役新数据节点
(1)在namenode的/opt/module/hadoop-2.7.2/etc/hadoop目录下创建dfs.hosts文件
[atguigu@hadoop105 hadoop]$ pwd
/opt/module/hadoop-2.7.2/etc/hadoop
[atguigu@hadoop105 hadoop]$ touch dfs.hosts
[atguigu@hadoop105 hadoop]$ vi dfs.hosts
添加如下主机名称(包含新服役的节点)
hadoop102
hadoop103
hadoop104
hadoop105
(2)在namenode的hdfs-site.xml配置文件中增加dfs.hosts属性
|
<property> <name>dfs.hosts</name> <value>/opt/module/hadoop-2.7.2/etc/hadoop/dfs.hosts</value> </property> |
(3)刷新namenode
[atguigu@hadoop102 hadoop-2.7.2]$ hdfs dfsadmin -refreshNodes
(4)更新resourcemanager节点
[atguigu@hadoop102 hadoop-2.7.2]$ yarn rmadmin -refreshNodes
(5)在namenode的slaves文件中增加新主机名称
增加105 不需要分发
hadoop102
hadoop103
hadoop104
hadoop105
(6)单独命令启动新的数据节点和节点管理器
[atguigu@hadoop105 hadoop-2.7.2]$ sbin/hadoop-daemon.sh start datanode
[atguigu@hadoop105 hadoop-2.7.2]$ sbin/yarn-daemon.sh start nodemanager
(7)在web浏览器上检查是否ok
3)如果数据不均衡,可以用命令实现集群的再平衡
[atguigu@hadoop102 sbin]$ ./start-balancer.sh
退役旧数据节点
1)在namenode的/opt/module/hadoop-2.7.2/etc/hadoop目录下创建dfs.hosts.exclude文件
[atguigu@hadoop102 hadoop]$ pwd
/opt/module/hadoop-2.7.2/etc/hadoop
[atguigu@hadoop102 hadoop]$ touch dfs.hosts.exclude
[atguigu@hadoop102 hadoop]$ vi dfs.hosts.exclude
添加如下主机名称(要退役的节点)
hadoop105
2)在namenode的hdfs-site.xml配置文件中增加dfs.hosts.exclude属性
|
<property> <name>dfs.hosts.exclude</name> <value>/opt/module/hadoop-2.7.2/etc/hadoop/dfs.hosts.exclude</value> </property> |
3)刷新namenode、刷新resourcemanager
[atguigu@hadoop102 hadoop-2.7.2]$ hdfs dfsadmin -refreshNodes
[atguigu@hadoop102 hadoop-2.7.2]$ yarn rmadmin -refreshNodes
4)检查web浏览器,退役节点的状态为decommission in progress(退役中),说明数据节点正在复制块到其他节点。
5)等待退役节点状态为decommissioned(所有块已经复制完成),停止该节点及节点资源管理器。注意:如果副本数是3,服役的节点小于等于3,是不能退役成功的,需要修改副本数后才能退役。
[atguigu@hadoop105 hadoop-2.7.2]$ sbin/hadoop-daemon.sh stop datanode
[atguigu@hadoop105 hadoop-2.7.2]$ sbin/yarn-daemon.sh stop nodemanager
6)从include文件中删除退役节点,再运行刷新节点的命令
(1)从namenode的dfs.hosts文件中删除退役节点hadoop105
hadoop102
hadoop103
hadoop104
(2)刷新namenode,刷新resourcemanager
[atguigu@hadoop102 hadoop-2.7.2]$ hdfs dfsadmin -refreshNodes
[atguigu@hadoop102 hadoop-2.7.2]$ yarn rmadmin -refreshNodes
7)从namenode的slave文件中删除退役节点hadoop105
hadoop102
hadoop103
hadoop104
8)如果数据不均衡,可以用命令实现集群的再平衡
[atguigu@hadoop102 hadoop-2.7.2]$ sbin/start-balancer.sh
HDFS之DataNode的更多相关文章
- HDFS Namenode&Datanode
HDFS Namenode&Datanode HDFS 机制粗略示意图 客户端写入文件流程: NN && DN Namenode(NN)工作机制 NN是整个文件系统的管理节点. ...
- org.apache.hadoop.hdfs.server.datanode.DataNode: Exception in receiveBlock for block
Hbase依赖的datanode日志中如果出现如下报错信息:DataXceiverjava.io.EOFException: INFO org.apache.hadoop.hdfs.server.da ...
- Datanode启动问题 FATAL org.apache.hadoop.hdfs.server.datanode.DataNode: Initialization failed for Block pool <registering>
-- ::, INFO org.apache.hadoop.hdfs.server.datanode.DataNode: supergroup = supergroup -- ::, INFO org ...
- ERROR org.apache.hadoop.hdfs.server.datanode.DataNode: Incompatible namespaceIDs
用三台centos操作系统的机器搭建了一个hadoop的分布式集群.启动服务后失败,查看datanode的日志,提示错误:ERROR org.apache.hadoop.hdfs.server.dat ...
- FATAL org.apache.hadoop.hdfs.server.datanode.DataNode: Initialization failed for Block pool <registering> (Datanode Uuid unassigned) service to controller/192.168.1.183:9000. Exiting. java.io.IOExcep
2018-01-09 09:47:38,297 FATAL org.apache.hadoop.hdfs.server.datanode.DataNode: Initialization failed ...
- hdfs.server.datanode.DataNode: Block pool ID needed, but service not yet registered with NN
启动hadoop 发现 50070 的 livenode 数量是 0 查看日志, hdfs.server.datanode.DataNode: Block pool ID needed, but se ...
- Hadoop启动HDFS时DataNode未启动
在用$HADOOP_HOME/sbin/start-dfs.sh启动HDFS时发现只有NameNode和SecondaryNameNode启动,没有DataNode. 查看logs下的DataNode ...
- 启动HDFS时datanode无法启动的坑
启动HDFS 启动hdfs,进入sbin目录,也可以执行./start-all.sh - $cd /app/hadoop/hadoop-2.2.0/sbin - $./start-dfs.sh 在此之 ...
- hdfs的datanode工作原理
datanode的作用: (1)提供真实文件数据的存储服务. (2)文件块(block):最基本的存储单位.对于文件内容而言,一个文件的长度大小是size,那么从文件的0偏移开始,按照固定的大小,顺序 ...
- hdfs namenode/datanode工作机制
一. namenode工作机制 1. 客户端上传文件时,namenode先检查有没有同名的文件,如果有,则直接返回错误信息.如果没有,则根据要上传文件的大小以及block的大小,算出需要分成几个blo ...
随机推荐
- javascript domAPI整理
对一般兼容性和特点做了标识(主要是ie8+) 节点类型 节点类型 节点值 标签节点(Element) 1 属性节点(Attr) 2 文本节点(Text) 3 CDATA节点(CDATASetion) ...
- [NOI2001]食物链(并查集拓展域)&& [HAOI2006]旅行(Kruskal)
题目描述 动物王国中有三类动物 A,B,C,这三类动物的食物链构成了有趣的环形.A 吃 B,B 吃 C,C 吃 A. 现有 N 个动物,以 1 - N 编号.每个动物都是 A,B,C 中的一种,但是我 ...
- Docker 实战—使用 Dockerfile 构建镜像
Dockerfile 指令详解请访问:https://www.cnblogs.com/cloudfloating/p/11737447.html 使用 Alpine Linux 作为基础镜像 Alpi ...
- 这一次,终于系统的学习了 JVM 内存结构
最近在看< JAVA并发编程实践 >这本书,里面涉及到了 Java 内存模型,通过 Java 内存模型顺理成章的来到的 JVM 内存结构,关于 JVM 内存结构的认知还停留在上大学那会的课 ...
- Luogu P1816 忠诚
rmq模板题.用st表切一个. 关于st表的详解见我的博客:st表.树状数组与线段树 笔记与思路整理 题目描述 老管家是一个聪明能干的人.他为财主工作了整整10年,财主为了让自已账目更加清楚.要求管家 ...
- 7.22 NOIP模拟7
又是炸掉的一次考试 T1.方程的解 本次考试最容易骗分的一道题,但是由于T2花的时间太多,我竟然连a+b=c都没判..暴力掉了40分. 首先a+b=c,只有一组解. 然后是a=1,b=1,答案是c-1 ...
- NOIP模拟27
两个机房又和在一起考试 开场看了看T1,感觉挺水的,过. T2,这个式子有点奇怪,暂时没什么思路,过 T3,好像保留最后几位换个根处理一下就行了,过,先去打T1 于是T1大概打了0.5h,连暴力带正解 ...
- CSPS模拟 42
T3数位$dp$还没改完啊 哭了 T1 对$DAG$里所有点求他能到达的点的数量 考试时算了$bitset$内存扛不住,yy了个线段树合并上去 没有A不是因为被卡了,而是数组又开小了.. 我以为不能卡 ...
- 009-2010网络最热的 嵌入式学习|ARM|Linux|wince|ucos|经典资料与实例分析
前段时间做了一个关于ARM9 2440资料的汇总帖,很高兴看到21ic和CSDN等论坛朋友们的支持和鼓励.当年学单片机的时候datasheet和学习资料基本都是在论坛上找到的,也遇到很多好心的高手朋友 ...
- python函数的基本语法<三>
实参和形参: 定义函数括号里的一般叫形参 调用时括号里传递的参数一般叫实参 def students(age): print('my age is %s' % age) students(18) ag ...