
HDFS Namenode&Datanode
HDFS Namenode&Datanode
HDFS 机制粗略示意图
客户端写入文件流程:
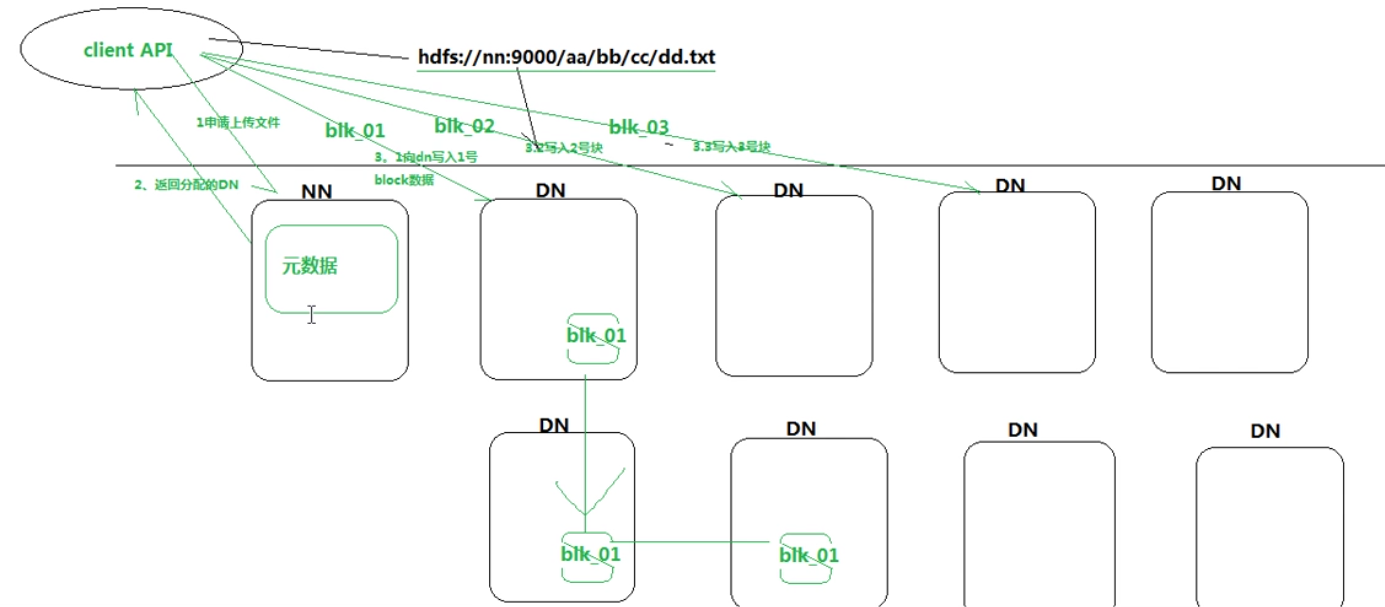
NN && DN
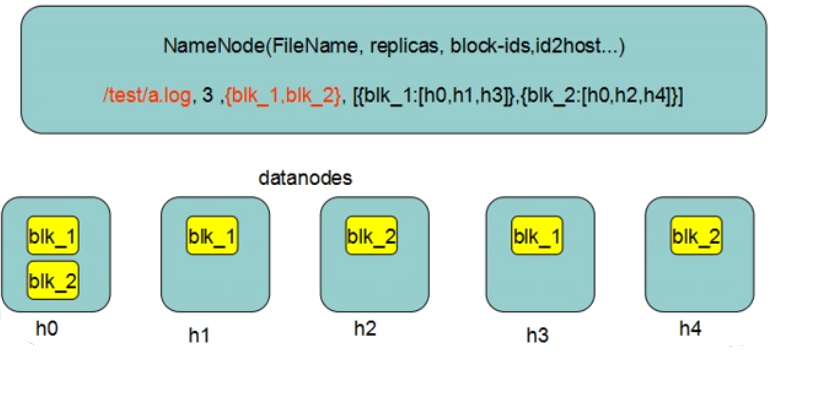
Namenode(NN)工作机制
NN是整个文件系统的管理节点。维护着整个文件系统的文件目录树,文件/目录的元信息和每个文件对应的数据块列表(管理元数据)。接收用户的操作请求。
fsimage:元数据镜像文件。存储某一时段NN内存元数据信息
edits:操作日志文件
fstime:保存最近一次checkpoint的时间
(以上文件保存在linux文件系统中)
主流程
- 客户端上传文件时,NN首先往edits log文件中记录元数据操作日志
- 客户端开始上传文件,完成后返回成功信息给NN。NN就在内存中写入这次上传操作而新产生的元数据信息。既实现了客户端可以从内存中查询(读写速度比从磁盘快),又保证了可靠性(若断电内存中的信息丢失,则可以从edits log文件中找回)。
- 每当edits log写满时,由secondary namenode将这部分新的元数据合并到fsimage文件中(checkpoint操作)。
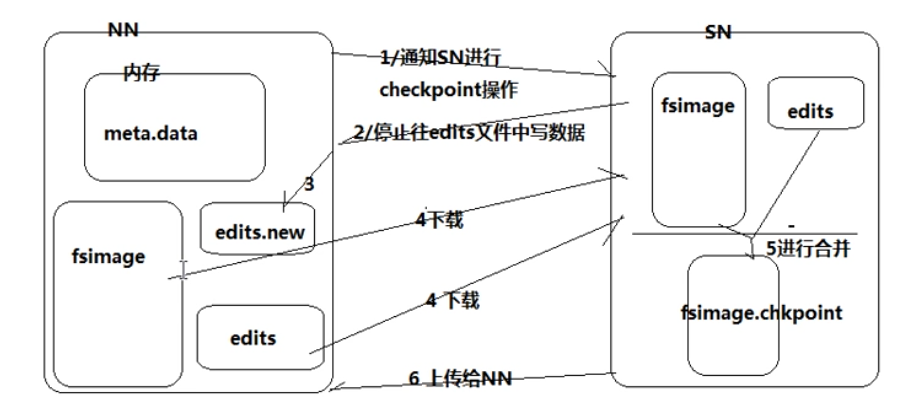
secondary namenode 的 checkpoint 操作
工作流程
- secondary通知namenode切换edits文件(改为写到edits.new)
- secondary从namenode获得fsimage和edits(通过http)
- secondary将fsimage载入内存,然后开始合并edits,产生新的fsimage
- secondary将新的fsimage发回给namenode
- namenode用新的fsimage替换旧的fsimage,并将edits.new重命名为edits
进行checkpoint的时间
- fs.checkpoint.period 指定两次checkpoint的间隔(默认3600秒)
- fs.chekpoint.size 规定edits文件的最大值,一旦超过则强制checkpoint,不管是否达到时间间隔(默认64M)
(以上可在hdfs-site.xml中设置)
Datanode(DN)工作原理
DN提供真实文件数据的存储服务。
文件块(block):最基本的存储单位。对于文件而言,一个文件的长度大小是size,那么从文件的0偏移开始,按照固定的大小顺序对文件进行划分并编号,划分好的每一块称一个block。
block的默认大小是128M,可以修改dfs.block.size参数进行更改
上传一个文件看看分块情况
上传 hadoop fs -put xxx(随便一个稍大一些的文件) /
打开datanode的数据文件夹 cd /app/hadoop-3.0.0/data/dfs/data/current/BP-1998331996-192.168.216.100-1521773499028/current/finalized/subdir0/subdir0
查看 du -sh *
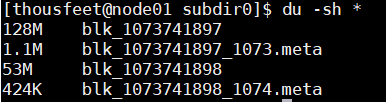
能看到被分作了两个block,其中一个正是128M。(.mate是校验和文件不是一个block)
HDFS Namenode&Datanode的更多相关文章
- hdfs namenode/datanode工作机制
一. namenode工作机制 1. 客户端上传文件时,namenode先检查有没有同名的文件,如果有,则直接返回错误信息.如果没有,则根据要上传文件的大小以及block的大小,算出需要分成几个blo ...
- 【Hadoop】hdfs的秘密,namenode,datanode,yarn,安全模式,fsimage,edits...
1.bin/hdfs namenode -format ** 注意事项 1.在配置好了配置文件之后,首次启动之前,做初始化操作 2.在后续启动的时候,不需要再初始化 3.初始化的一些影响 一.初始化操 ...
- Hadoop(五)—— HDFS NameNode、DataNode工作机制
一.NN与2NN工作机制 NameNode(NN) 1.当HDFS启动时,会加载日志(edits)和镜像文件(fsImage)到内存中. 2-4.当元数据的增删改查请求进来时,NameNode会先将操 ...
- HDFS NameNode 设计实现解析
接前文 分布式存储-HDFS 架构解析,我们总体分析了 HDFS 架构的主要构成组件包括:NameNode.DataNode 和 Client.本文首先进一步解析 HDFS NameNode 的设计和 ...
- NameNode & DataNode
NameNode类位于org.apache.hadoop.hdfs.server.namenode包下. NameNode serves as both directory namespace man ...
- 后端分布式系列:分布式存储-HDFS NameNode 设计实现解析
接前文 分布式存储-HDFS 架构解析,我们总体分析了 HDFS 架构的主要构成组件包括:NameNode.DataNode 和 Client.本文首先进一步解析 HDFS NameNode 的设计和 ...
- Hadoop:HDFS NameNode内存全景
原文转自:https://tech.meituan.com/namenode.html 感谢原作者 一.概述 从整个HDFS系统架构上看,NameNode是其中最重要.最复杂也是最容易出现问题的地方, ...
- Hadoop HDFS NameNode工作机制
Secondary namenode 首先,我们假设如果存储在Namenode节点的磁盘中,因为经常需要进行随机访问,还有响应客户请求,必然是效率过低.因此,元数据需要存放在内存中.但如果只存在内存中 ...
- 启动HDFS时datanode无法启动的坑
启动HDFS 启动hdfs,进入sbin目录,也可以执行./start-all.sh - $cd /app/hadoop/hadoop-2.2.0/sbin - $./start-dfs.sh 在此之 ...
随机推荐
- 使用JS传递数组型数据回服务器
//为数组添加一个方法,判断某个值是否存在于数组中 Array.prototype.in_array = function (e) { for (i = 0; i < this.length & ...
- Linq to SharePoint与权限提升(转)
转自http://www.cnblogs.com/kaneboy/archive/2012/01/25/2437086.html SharePoint 2010支持Linq to SharePoint ...
- 【c++】类中的const成员
const成员变量 举个例子 #include <iostream> using namespace std; class A { public: A(int size) : SIZE(s ...
- Excel的vlookup函数的用法
VLOOKUP函数用于搜索指定区域内首列满足条件的元素,确定待检测单元格在区域中的行序号,再进一步返回选定单元格的值. 为了讲解的需要,特制作如图所示的表格.当然,大家也可以根据自己的实际情况设计合适 ...
- C# Winform程序CPU占用高的原因和解决方法
程序CPU占用高的可能原因: 1.存在死循环: 为什么死循环会导致CPU占用高呢? 虽然分时操作系统是采用时间片的机制对CPU的时间进行管理的,也就是说到了一定时间它会自动从一个进程切换到下 ...
- Sublime Text - 在浏览器打开当前文件
有没有办法通过快捷键在指定的浏览器中打开当前文件? 有点怀念Dreamweaver的F12? 其实Sublime也可以实现这一效果,而且不需要安装任何插件. 进入Tools -> Build S ...
- AJAX同步问题
@using ShippingRen.CommonV2.CloudStorage; @using ShippingRen.Api.ServiceModel.PublicDataEntity.Looku ...
- Hadoop学习笔记(9) ——源码初窥
Hadoop学习笔记(9) ——源码初窥 之前我们把Hadoop算是入了门,下载的源码,写了HelloWorld,简要分析了其编程要点,然后也编了个较复杂的示例.接下来其实就有两条路可走了,一条是继续 ...
- 二:Bootstrap-css组件
Glyphicons 图标: span.glyphicon glyphicon-align-center 下拉菜单: div.dropdown/div.btn-group button[data-to ...
- MVC 手机端页面 使用标签file 图片上传到后台处理
最近刚做了一个头像上传的功能,使用的是H5 的界面,为了这个功能搞了半天的时间,找了各种插件,有很多自己都不知道怎么使用,后来只是使用了一个标签就搞定了:如果对样式没有太大的要求我感觉使用这个就足够了 ...