
Kubernetes 服务部署最佳实践(二) ——如何提高服务可用性
引言
上一篇文章我们围绕如何合理利用资源的主题做了一些最佳实践的分享,这一次我们就如何提高服务可用性的主题来展开探讨。
怎样提高我们部署服务的可用性呢?K8S 设计本身就考虑到了各种故障的可能性,并提供了一些自愈机制以提高系统的容错性,但有些情况还是可能导致较长时间不可用,拉低服务可用性的指标。本文将结合生产实践经验,为大家提供一些最佳实践来最大化的提高服务可用性。
如何避免单点故障?
K8S 的设计就是假设节点是不可靠的。节点越多,发生软硬件故障导致节点不可用的几率就越高,所以我们通常需要给服务部署多个副本,根据实际情况调整 replicas 的值,如果值为 1 就必然存在单点故障,如果大于 1 但所有副本都调度到同一个节点了,那还是有单点故障,有时候还要考虑到灾难,比如整个机房不可用。
所以我们不仅要有合理的副本数量,还需要让这些不同副本调度到不同的拓扑域(节点、可用区),打散调度以避免单点故障,这个可以利用 Pod 反亲和性来做到,反亲和主要分强反亲和与弱反亲和两种。更多亲和与反亲和信息可参考官方文档Affinity and anti-affinity。
先来看个强反亲和的示例,将 DNS 服务强制打散调度到不同节点上:
affinity: podAntiAffinity: requiredDuringSchedulingIgnoredDuringExecution: - labelSelector: matchExpressions: - key: k8s-app operator: In values: - kube-dns topologyKey: kubernetes.io/hostname
labelSelector.matchExpressions写该服务对应 pod 中 labels 的 key 与 value,因为 Pod 反亲和性是通过判断 replicas 的 pod label 来实现的。topologyKey指定反亲和的拓扑域,即节点 label 的 key。这里用的kubernetes.io/hostname表示避免 pod 调度到同一节点,如果你有更高的要求,比如避免调度到同一个可用区,实现异地多活,可以用failure-domain.beta.kubernetes.io/zone。通常不会去避免调度到同一个地域,因为一般同一个集群的节点都在一个地域,如果跨地域,即使用专线时延也会很大,所以topologyKey一般不至于用failure-domain.beta.kubernetes.io/region。requiredDuringSchedulingIgnoredDuringExecution调度时必须满足该反亲和性条件,如果没有节点满足条件就不调度到任何节点 (Pending)。
如果不用这种硬性条件可以使用 preferredDuringSchedulingIgnoredDuringExecution 来指示调度器尽量满足反亲和性条件,即弱反亲和性,如果实在没有满足条件的,只要节点有足够资源,还是可以让其调度到某个节点,至少不会 Pending。
我们再来看个弱反亲和的示例:
affinity: podAntiAffinity: preferredDuringSchedulingIgnoredDuringExecution: - weight: 100 podAffinityTerm: labelSelector: matchExpressions: - key: k8s-app operator: In values: - kube-dns topologyKey: kubernetes.io/hostname
注意到了吗?相比强反亲和有些不同哦,多了一个 weight,表示此匹配条件的权重,而匹配条件被挪到了 podAffinityTerm 下面。
如何避免节点维护或升级时导致服务不可用?
有时候我们需要对节点进行维护或进行版本升级等操作,操作之前需要对节点执行驱逐 (kubectl drain),驱逐时会将节点上的 Pod 进行删除,以便它们漂移到其它节点上,当驱逐完毕之后,节点上的 Pod 都漂移到其它节点了,这时我们就可以放心的对节点进行操作了。
有一个问题就是,驱逐节点是一种有损操作,驱逐的原理:
- 封锁节点 (设为不可调度,避免新的 Pod 调度上来)。
- 将该节点上的 Pod 删除。
- ReplicaSet 控制器检测到 Pod 减少,会重新创建一个 Pod,调度到新的节点上。
这个过程是先删除,再创建,并非是滚动更新,因此更新过程中,如果一个服务的所有副本都在被驱逐的节点上,则可能导致该服务不可用。
我们再来下什么情况下驱逐会导致服务不可用:
- 服务存在单点故障,所有副本都在同一个节点,驱逐该节点时,就可能造成服务不可用。
- 服务没有单点故障,但刚好这个服务涉及的 Pod 全部都部署在这一批被驱逐的节点上,所以这个服务的所有 Pod 同时被删,也会造成服务不可用。
- 服务没有单点故障,也没有全部部署到这一批被驱逐的节点上,但驱逐时造成这个服务的一部分 Pod 被删,短时间内服务的处理能力下降导致服务过载,部分请求无法处理,也就降低了服务可用性。
针对第一点,我们可以使用前面讲的反亲和性来避免单点故障。
针对第二和第三点,我们可以通过配置 PDB (PodDisruptionBudget) 来避免所有副本同时被删除,驱逐时 K8S 会 "观察" nginx 的当前可用与期望的副本数,根据定义的 PDB 来控制 Pod 删除速率,达到阀值时会等待 Pod 在其它节点上启动并就绪后再继续删除,以避免同时删除太多的 Pod 导致服务不可用或可用性降低,下面给出两个示例。
示例一 (保证驱逐时 nginx 至少有 90% 的副本可用):
apiVersion: policy/v1beta1kind: PodDisruptionBudgetmetadata: name: zk-pdbspec: minAvailable: 90% selector: matchLabels: app: zookeeper
示例二 (保证驱逐时 zookeeper 最多有一个副本不可用,相当于逐个删除并等待在其它节点完成重建):
apiVersion: policy/v1beta1kind: PodDisruptionBudgetmetadata: name: zk-pdbspec: maxUnavailable: 1 selector: matchLabels: app: zookeeper
如何让服务进行平滑更新?
解决了服务单点故障和驱逐节点时导致的可用性降低问题后,我们还需要考虑一种可能导致可用性降低的场景,那就是滚动更新。为什么服务正常滚动更新也可能影响服务的可用性呢?别急,下面我来解释下原因。
假如集群内存在服务间调用:
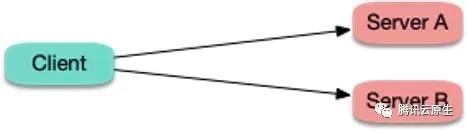
当 server 端发生滚动更新时:
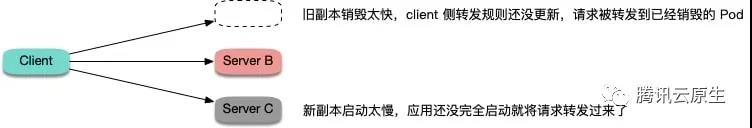
发生两种尴尬的情况:
- 旧的副本很快销毁,而 client 所在节点 kube-proxy 还没更新完转发规则,仍然将新连接调度给旧副本,造成连接异常,可能会报 "connection refused" (进程停止过程中,不再接受新请求) 或 "no route to host" (容器已经完全销毁,网卡和 IP 已不存在)。
- 新副本启动,client 所在节点 kube-proxy 很快 watch 到了新副本,更新了转发规则,并将新连接调度给新副本,但容器内的进程启动很慢 (比如 Tomcat 这种 java 进程),还在启动过程中,端口还未监听,无法处理连接,也造成连接异常,通常会报 "connection refused" 的错误。
针对第一种情况,可以给 container 加 preStop,让 Pod 真正销毁前先 sleep 等待一段时间,等待 client 所在节点 kube-proxy 更新转发规则,然后再真正去销毁容器。这样能保证在 Pod Terminating 后还能继续正常运行一段时间,这段时间如果因为 client 侧的转发规则更新不及时导致还有新请求转发过来,Pod 还是可以正常处理请求,避免了连接异常的发生。听起来感觉有点不优雅,但实际效果还是比较好的,分布式的世界没有银弹,我们只能尽量在当前设计现状下找到并实践能够解决问题的最优解。
针对第二种情况,可以给 container 加 ReadinessProbe (就绪检查),让容器内进程真正启动完成后才更新 Service 的 Endpoint,然后 client 所在节点 kube-proxy 再更新转发规则,让流量进来。这样能够保证等 Pod 完全就绪了才会被转发流量,也就避免了链接异常的发生。
最佳实践 yaml 示例:
readinessProbe: httpGet: path: /healthz port: 80 httpHeaders: - name: X-Custom-Header value: Awesome initialDelaySeconds: 10 timeoutSeconds: 1 lifecycle: preStop: exec: command: ["/bin/bash", "-c", "sleep 10"]
更多信息请参考Specifying a Disruption Budget for your Application。
健康检查怎么配才好?
我们都知道,给 Pod 配置健康检查也是提高服务可用性的一种手段,配置 ReadinessProbe (就绪检查) 可以避免将流量转发给还没启动完全或出现异常的 Pod;配置 LivenessProbe (存活检查) 可以让存在 bug 导致死锁或 hang 住的应用重启来恢复。但是,如果配置配置不好,也可能引发其它问题,这里根据一些踩坑经验总结了一些指导性的建议:
- 不要轻易使用 LivenessProbe,除非你了解后果并且明白为什么你需要它,参考 Liveness Probes are Dangerous
- 如果使用 LivenessProbe,不要和 ReadinessProbe 设置成一样 (failureThreshold 更大)
- 探测逻辑里不要有外部依赖 (db, 其它 pod 等),避免抖动导致级联故障
- 业务程序应尽量暴露 HTTP 探测接口来适配健康检查,避免使用 TCP 探测,因为程序 hang 死时, TCP 探测仍然能通过 (TCP 的 SYN 包探测端口是否存活在内核态完成,应用层不感知)
【腾讯云原生】云说新品、云研新术、云游新活、云赏资讯,扫码关注同名公众号,及时获取更多干货!!
Kubernetes 服务部署最佳实践(二) ——如何提高服务可用性的更多相关文章
- Kubernetes 服务部署最佳实践(一) ——如何更好地设置 Request 与 Limit
如何为容器配置 Request 与 Limit? 这是一个即常见又棘手的问题,这个根据服务类型,需求与场景的不同而不同,没有固定的答案,这里结合生产经验总结了一些最佳实践,可以作为参考. 所有容器都应 ...
- 在CentOS 7.6 以 kubeadm 安装 Kubernetes 1.15 最佳实践
前言 Kubernetes作为容器编排工具,简化容器管理,提升工作效率而颇受青睐.很多新手部署Kubernetes由于"scientifically上网"问题举步维艰,本文以实战经 ...
- tomcat部署最佳实践(一)
Tomcat部署最佳实践 标签: linux 笔者Q:972581034 交流群:605799367.有任何疑问可与笔者或加群交流 tomcat是玩web软件必会技能之一,今天我给大家介绍一下tomc ...
- [转]在 Azure 云服务上设计大规模服务的最佳实践
本文转自:http://technet.microsoft.com/zh-cn/magazine/jj717232.aspx 英文版:http://msdn.microsoft.com/library ...
- Cobbler自动化部署最佳实践
第1章 Cobbler自动化部署最佳实践 运维自动化在生产环境中占据着举足轻重的地位,尤其是面对几百台,几千台甚至几万台的服务器时,仅仅是安装操作系统,如果不通过自动化来完成,根本是不可想象的. 面对 ...
- 从Uber微服务看最佳实践如何炼成?
导读:Uber成长非常迅速,工程师团队快速扩充,据说Uber有2000名工程师,8000个代码仓库,部署了1000多个微服务.微服务架构是Uber应对技术团队快速增长,功能快速上线很出色的解决方案.本 ...
- express 最佳实践(二):中间件
express 最佳实践(二):中间件 第一篇 express 最佳实践(一):项目结构 express 中最重要的就是中间件了,可以说中间件组成了express,中间件就是 express 的核心. ...
- 【实战】Docker入门实践二:Docker服务基本操作 和 测试Hello World
操作环境 操作系统:CentOS7.2 内存:1GB CPU:2核 Docker服务常用命令 docker服务操作命令如下 service docker start #启动服务 service doc ...
- nodejs 实践:express 最佳实践(二) 中间件
express 最佳实践(二):中间件 第一篇 express 最佳实践(一):项目结构 express 中最重要的就是中间件了,可以说中间件组成了express,中间件就是 express 的核心. ...
随机推荐
- 2020-07-09:mysql如何开启慢查询?
福哥答案2020-07-09: 1.参数说明 slow_query_log 慢查询开启状态slow_query_log_file 慢查询日志存放的位置(这个目录需要MySQL的运行帐号的可写权限,一般 ...
- [持续更新]——关于C++的一些可能会常用的函数
写在前面 这些函数都是我和朋友一点一点写出来的,可能部分代码会有点雷同,但大部分代码都是自我总结出来的.目前包含的函数功能分别是: 1.设置控制台颜色 2.设置控制台光标位置 3.隐藏控制台光标 4. ...
- 初始化itable
在InstanceKlass::link_class_impl()方法中完成方法连接后会继续初始化vtable与itable,之前已经介绍过vtable与itable,并且在类解析过程中已经完成了大小 ...
- Kubernetes 编写自定义 controller
原文链接:Kubernetes编写自定义controller 来自kubernetes官方github的一张图: 如图所示,图中的组件分为client-go和custom controller两部分: ...
- 第五篇Scrum冲刺博客--Interesting-Corps
第五篇Scrum冲刺博客 站立式会议 1.会议照片 2.队友完成情况 团队成员 昨日完成 今日计划 鲍鱼铭 音乐详情页面跳转.设计及布局实现设计 搜索页面以及音乐详情页面数据导入及测试 叶学涛 编写分 ...
- Revisiting Fundamentals of Experience Replay
郑重声明:原文参见标题,如有侵权,请联系作者,将会撤销发布! ICML 2020 Abstract 经验回放对于深度RL中的异策算法至关重要,但是在我们的理解上仍然存在很大差距.因此,我们对Q学习方法 ...
- 如何为指定python解释器安装pip
有时候我们通常会有很多python解释器,例如python2.python3.python(Anaconda). 参考链接:https://www.cnblogs.com/michaelcjl/p/1 ...
- SpringBoot使用简单缓存
第一步开启缓存(只要是springboot项目就可以) 数据库连接等相关配置请读者自行实现. 在Application启动类上添加注解 @EnableCaching 开启缓存 @SpringBoot ...
- 借助FRP反向代理实现内网穿透
一.frp 是什么? frp 是一个专注于内网穿透的高性能的反向代理应用,支持 TCP.UDP.HTTP.HTTPS 等多种协议.可以将内网服务以安全.便捷的方式通过具有公网 IP 节点的中转暴露到公 ...
- Javascript基本数据认识
1.Js的组成 2.Js的三种引入 行内式 <input type="button" value="来嘛来嘛" onclick="alert(' ...