
Spark Shuffle之Sort Shuffle
源文件放在github,随着理解的深入,不断更新,如有谬误之处,欢迎指正。原文链接https://github.com/jacksu/utils4s/blob/master/spark-knowledge/md/sort-shuffle.md
正如你所知,spark实现了多种shuffle方法,通过 spark.shuffle.manager来确定。暂时总共有三种:hash shuffle、sort shuffle和tungsten-sort shuffle,从1.2.0开始默认为sort shuffle。本节主要介绍sort shuffle。
从1.2.0开始默认为sort shuffle(spark.shuffle.manager = sort),实现逻辑类似于Hadoop MapReduce,Hash Shuffle每一个reducers产生一个文件,但是Sort Shuffle只是产生一个按照reducer id排序可索引的文件,这样,只需获取有关文件中的相关数据块的位置信息,并fseek就可以读取指定reducer的数据。但对于rueducer数比较少的情况,Hash Shuffle明显要比Sort Shuffle快,因此Sort Shuffle有个“fallback”计划,对于reducers数少于 “spark.shuffle.sort.bypassMergeThreshold” (200 by default),我们使用fallback计划,hashing相关数据到分开的文件,然后合并这些文件为一个,具体实现为BypassMergeSortShuffleWriter。
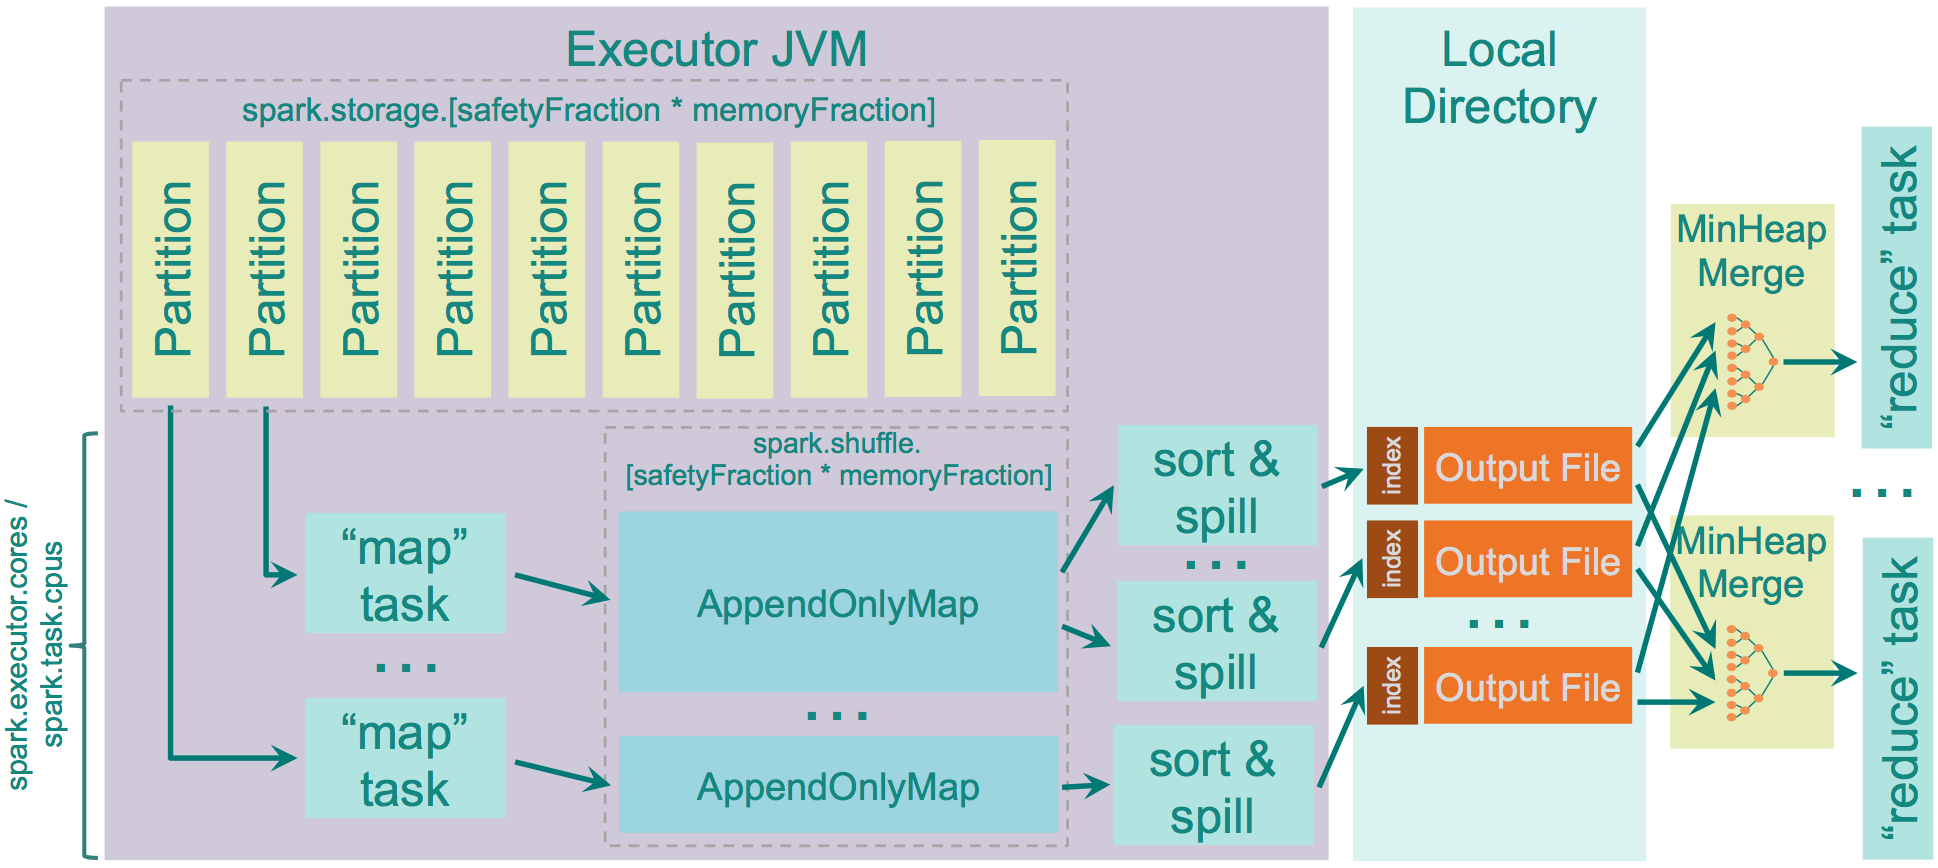
在map进行排序,在reduce端应用Timsort[1]进行合并。map端是否容许spill,通过spark.shuffle.spill来设置,默认是true。设置为false,如果没有足够的内存来存储map的输出,那么就会导致OOM错误,因此要慎用。
用于存储map输出的内存为:“JVM Heap Size” \* spark.shuffle.memoryFraction \* spark.shuffle.safetyFraction,默认为“JVM Heap Size” \* 0.2 \* 0.8 = “JVM Heap Size” \* 0.16。如果你在同一个执行程序中运行多个线程(设定spark.executor.cores/ spark.task.cpus超过1),每个map任务存储的空间为“JVM Heap Size” * spark.shuffle.memoryFraction * spark.shuffle.safetyFraction / spark.executor.cores * spark.task.cpus, 默认2个cores,那么为0.08 * “JVM Heap Size”。
spark使用AppendOnlyMap存储map输出的数据,利用开源hash函数MurmurHash3和平方探测法把key和value保存在相同的array中。这种保存方法可以是spark进行combine。如果spill为true,会在spill前sort。
Sort Shuffle内存的源码级别更详细说明可以参考[4],读写过程可以参考[5]
优点
- map创建文件量较少
- 少量的IO随机操作,大部分是顺序读写
缺点
- 要比Hash Shuffle要慢,需要自己通过
spark.shuffle.sort.bypassMergeThreshold来设置合适的值。 - 如果使用SSD盘存储shuffle数据,那么Hash Shuffle可能更合适。
参考
[1][Timsort原理介绍](http://blog.csdn.net/yangzhongblog/article/details/8184707)
[2][形式化方法的逆袭——如何找出Timsort算法和玉兔月球车中的Bug?](http://bindog.github.io/blog/2015/03/30/use-formal-method-to-find-the-bug-in-timsort-and-lunar-rover/)
[3][Spark Architecture: Shuffle](http://0x0fff.com/spark-architecture-shuffle/)
[4][Spark Sort Based Shuffle内存分析](http://www.jianshu.com/p/c83bb237caa8)
[5][Spark Shuffle Write阶段磁盘文件分析](http://www.jianshu.com/p/2d837bf2dab6)
Spark Shuffle之Sort Shuffle的更多相关文章
- Spark Shuffle之Hash Shuffle
源文件放在github,如有谬误之处,欢迎指正.原文链接https://github.com/jacksu/utils4s/blob/master/spark-knowledge/md/hash-sh ...
- Spark Shuffle原理、Shuffle操作问题解决和参数调优
摘要: 1 shuffle原理 1.1 mapreduce的shuffle原理 1.1.1 map task端操作 1.1.2 reduce task端操作 1.2 spark现在的SortShuff ...
- Spark技术内幕:Shuffle的性能调优
通过上面的架构和源码实现的分析,不难得出Shuffle是Spark Core比较复杂的模块的结论.它也是非常影响性能的操作之一.因此,在这里整理了会影响Shuffle性能的各项配置.尽管大部分的配置项 ...
- 【Spark调优】Shuffle原理理解与参数调优
[生产实践经验] 生产实践中的切身体会是:影响Spark性能的大BOSS就是shuffle,抓住并解决shuffle这个主要原因,事半功倍. [Shuffle原理学习笔记] 1.未经优化的HashSh ...
- Spark性能优化:shuffle调优
调优概述 大多数Spark作业的性能主要就是消耗在了shuffle环节,因为该环节包含了大量的磁盘IO.序列化.网络数据传输等操作.因此,如果要让作业的性能更上一层楼,就有必要对shuffle过程进行 ...
- Add, remove, shuffle and sort
To deal cards, we would like a method that removes a card from the deck and returns it. The list met ...
- Partitioning, Shuffle and sort
Partitioning, Shuffle and sort what happened? - Partitioning Partitioning is the process of determi ...
- Hadoop-2.2.0中文文档—— MapReduce下一代- 可插入的 Shuffle 和 Sort
简单介绍 可插入的 shuffle 和 sort 功能,同意在shuffle 和 sort 逻辑中用可选择的实现类替换.这个情况的样例是:用一个不是HTTP的应用协议,如RDMA来 shuffle 从 ...
- shuffle和sort分析
MapReduce中的Shuffle和Sort分析 MapReduce 是现今一个非常流行的分布式计算框架,它被设计用于并行计算海量数据.第一个提出该技术框架的是Google 公司,而Google 的 ...
随机推荐
- [笔记] 升級到 Delphi 10.2 Tokyo 笔记
升級到 Delphi 10.2 Tokyo 笔记: 更新 Xcode 8.3 & iOS 10.3 测试: macOS 没问题(可 Debug) iOS Simulator 没问题(可 Deb ...
- 调试日志——基于stm32的智能声光报警器(二)
今天调试了音频部分的播放功能,这里我采用的是输出pwm来播放声音的方式. 声音的源文件是一个wav文件,然后用一个软件将wav文件转化为一个数组的文件. 要播放的文件就是这个数组文件里面的数据部分,前 ...
- jenkins+maven+docker集成java发布(二)#远程发布
jenkins+maven+docker集成java发布(一)中写了在Jenkins服务器自动部署业务,那需要将java项目部署到其他服务器怎么操作 这里需要依赖插件Publish Over SSH ...
- pycharm社区版新建django文件不友好操作
一.cmd操作 1.django-admin startproject (新建project名称) 2.在pycharm打开project,运行终端输入:python manage.py starta ...
- ECShop全系列版本远程代码执行漏洞复现
前言 问题发生在user.php的display函数,模版变量可控,导致注入,配合注入可达到远程代码执行 漏洞分析 0x01-SQL注入 先看user.php $back_act变量来源于HTTP_R ...
- 20155213 2016-2017-2 《Java程序设计》第六周学习总结
20155213 2016-2017-2 <Java程序设计>第六周学习总结 教材学习内容总结 输入与输出 串流设计 流(Stream)是对「输入输出」的抽象,注意「输入输出」是相对程序而 ...
- 20155330 实验三 敏捷开发与XP实践
20155330 实验三 敏捷开发与XP实践 实验内容 XP基础 XP核心实践 相关工具 实验步骤 (一)敏捷开发与XP 软件工程是把系统的.有序的.可量化的方法应用到软件的开发.运营和维护上的过程. ...
- HTML 5 +CSS3 + 原生js 做(雪花全屏飘落 + 3d旋转图)
原文:HTML 5 +CSS3 + 原生js 做(雪花全屏飘落 + 3d旋转图) 3d旋转图:主要用css3中transform属性中的rotate,translate;以及用来做舞台效果的 pers ...
- win10-MySql免安装版-安装/多实例
一.MySql免安装版安装: 1.MySql分为两个版本: 安装板的msi格式文件,直接点击下一步,下一步就可以安装 免安装版的zip格式,直接解压配置安装即可,[解压-初始化创建data目录-创建用 ...
- BZOJ2140_稳定婚姻_KEY
题目传送门 暴力直接对于每个点跑一遍二分图匹配,能拿四十分. 然而我们考虑正解. 对于一对Couple我们建♂->♀的一条边,对于一对曾经有恋情的情侣我们建♀->♂的一条边. 跑Tarja ...